
AI 生图能力越来越强,但大家似乎也苦“AI 味”久矣。
精致得有些过头的光影、光滑的皮肤、似曾相识的构图……不少 AI 生成的图片虽然漂亮,却总能让人一眼辨认出来。
最近,一款来自中国的开源生图模型,因画面的自然质感在海外 AI 社区引发了一波热议。
ComfyUI 社区知名开发者 Ostris 给出了一个有意思的推测:如今越来越多模型开始引入 AI 生成图像进行训练,导致输出风格逐渐带上了相似的“ChatGPT 味”。而这款模型选择从训练数据中彻底剔除 AI 生成图像,或许正是其视觉表现与众不同的原因。
这款模型,便是由模思智能和 OpenMOSS 团队开源发布的 MOSS-Image。
上线仅 4 天,MOSS-Image 在包括 Hugging Face 的 Comfy-Org 仓库在内的海外社区中,累计下载量突破 130 万次:
在 GitHub 上收获 1.4k Stars,并迅速登顶 Hugging Face 文生图趋势榜,同时跻身全类别模型趋势榜前列。
更热闹的场景发生在开发者社区。
模型刚一发布,开发者和创作者便紧锣密鼓地推出了各种衍生版本:8 步、4 步加速模型,INT8 量化、GGUF 版本,摄影、动漫风格多样 LoRA,以及全新 ComfyUI 工作流接连涌现。
在 X、Reddit 等平台上,不少开发者将其与 FLUX.3-klein、Krea2、Qwen Image 2.1 等模型同台对比,测试其在画面风格、人物细节、文字渲染和复杂构图等方面的表现。
那么,这款基于 5B 参数 DiT 主干的国产生图模型,究竟凭什么在短短几天内吸引了如此多的海外开发者?
海外开发者热议,FLUX.3-klein、Krea2 也被拉来同台比较
MOSS-Image 开源后,海外社区响应极为迅速。除前述的画面自然度外,开发者们也开始从多维度深入测试该模型的生成能力。
有人关注它能否真正摆脱常见的 AI 画风,有人则尝试借助更复杂的 Prompt 测试其人物姿态、画面细节以及风格一致性。
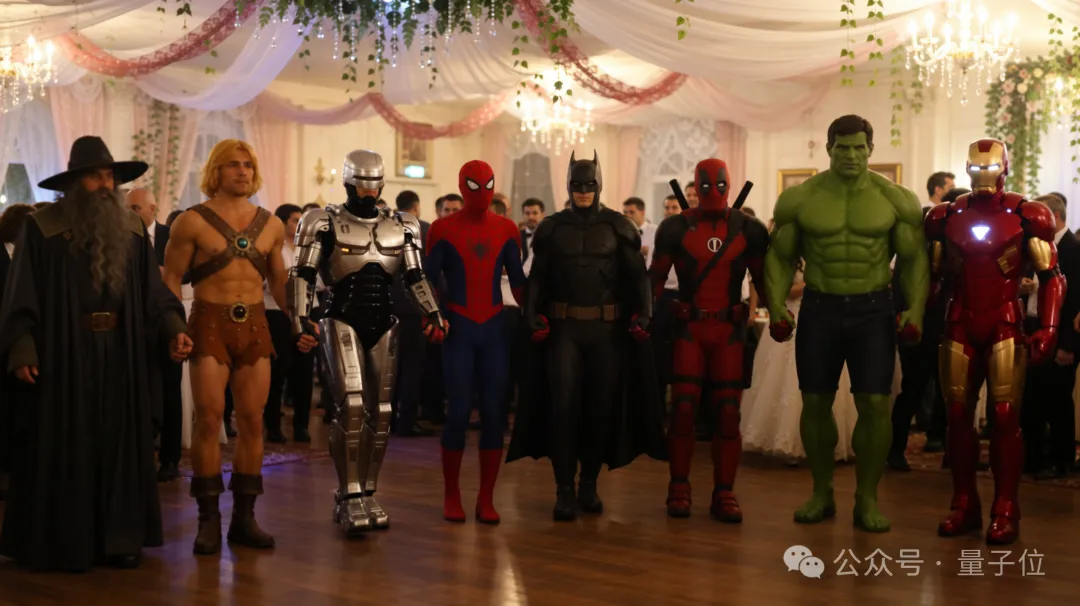
从动漫、插画到照片级写实,MOSS-Image 丰富的风格表现力在社区开发者晒出的作品中得到了充分展现。
 △ 图源:Reddit@Ok-Option-6683
另一位开发者 Wildminder 则重点关注了 MOSS-Image 的布局控制能力。
通过 JSON Layout 与 Bounding Box,用户能够明确指定文字和物体在画面中的空间位置。这种构图控制机制,对于海报、电商图等视觉设计任务而言极具实用价值。
此外,社区中还有不少开发者围绕日文文字渲染、复杂构图、长提示词生成,以及不同 LoRA 和推理参数下的生成效果展开了密集测试。
从分享的测试结果来看,MOSS-Image 在这些场景下的表现收获了大量好评,尤其是其文字渲染与复杂指令遵循能力,得到了开发者的高度认可。
在 Reddit 的 r/StableDiffusion 板块中,MOSS-Image 成为近期讨论热度最高的模型之一。
由 MOSS-Image 核心开发者发起的 AMA(Ask Me Anything)问答帖获得了社区置顶推荐。核心开发团队在帖中与社区成员直接交流,答疑模型设计与落地应用中的各类细节。
有帖子将其评价为“近期表现极为突出的 Base 模型”,亦有开发者由此联想到了当年的 SDXL(Stable Diffusion XL,由 Stability AI 于 2023 年推出的开源权重 AI 图像生成基础模型)。
更有趣的是,关于 MOSS-Image 与其他模型的对比实验迅速铺开,FLUX.3-klein、Krea2 等模型相继进入开发者的对照组中。
部分开发者使用相同 Prompt 对比画面构图与细节,部分聚焦于复杂人物姿态的还原,还有开发者专项测试了写实质感、色彩把控与风格呈现。
各项测试呈现了多元的观察视角:一些开发者对其画面自然度和细节表现给予肯定,也有开发者指出其在特定画风下的稳定性仍有优化空间。
这些自发测试为全面了解 MOSS-Image 在真实创作环境下的实战能力提供了丰富参考。
而从社区讨论的核心焦点来看,文字渲染与排版布局控制尤其受到重视。
文字、排版布局、长 Prompt,MOSS-Image 这次重点解决了什么?
图像生成模型发展至今,生成画质已有显著提升。但若要求 AI 直接生成一张包含密集文字与复杂排版的海报或电商图,往往仍会面临诸多挑战:
文字错漏拼写、标题定位偏移、多元素排列杂乱无序等,都是实际创作中的常见痛点。
MOSS-Image 本次优化的核心,正是这些与专业设计任务紧密相关的能力。
首先是中英文文字渲染。
MOSS-Image 针对密集文本生成进行了深度优化,可支持较长篇幅的中英文内容排版,并能良好保留换行等版式结构信息。在 Long Long Text Benchmark(LLTB)评测中,MOSS-Image 的 Mean-6 文本覆盖率达到 96.3%,位列参评开放权重模型第一。
这里的覆盖率指标主要衡量目标文本的呈现完整度,并不完全等同于逐字准确率;但这一成绩依然印证了该模型在处理复杂文本生成任务时的突出实力。
其次,是更受设计类场景关注的 Layout 空间布局控制。
在传统文生图流程中,用户通常需要利用自然语言描述画面的构图需求,例如“将标题置于左上方、人物位于右侧、主体产品居中,周围点缀背景元素与说明文字”。一旦限制条件增多,模型往往难以完全契合预期排布。
MOSS-Image 则引入了结构化的 JSON Layout 输入方案。
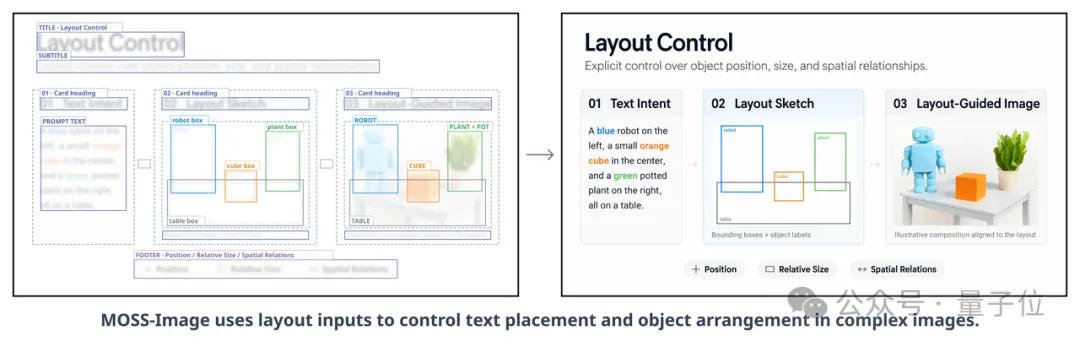
开发者可在 summary 字段中描摹全局场景,在 items 中定义文字、物体及其视觉属性,并借助 Bounding Box 精准锚定各元素的位置与范围。如此一来,抽象的设计意图得以转化为明确的空间几何约束。
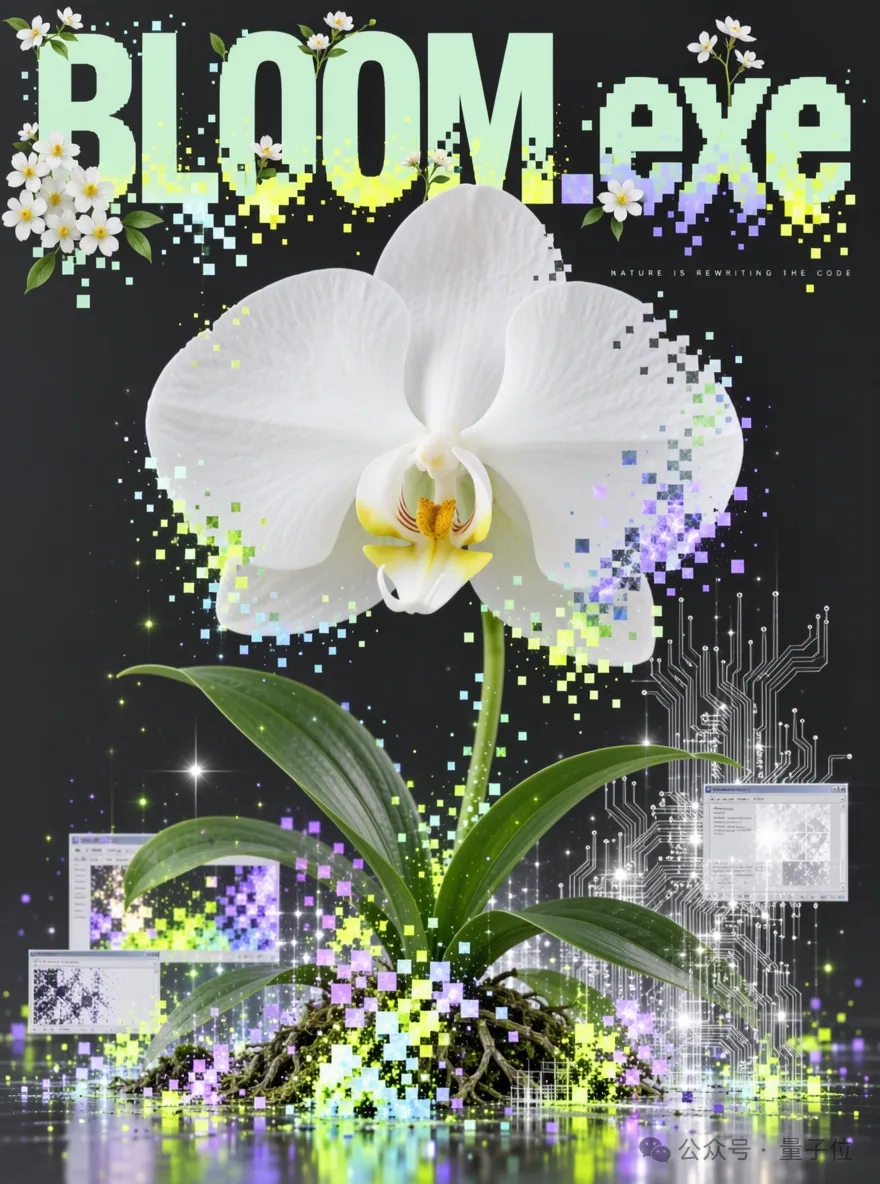 △ 图源:Reddit@Nid_All
在 7Bench 布局控制评测中,MOSS-Image 取得了 0.88 的目标定位 mIoU 和 0.70 的布局 AUC。
在复杂视觉设计任务中,MOSS-Image 同样展现了扎实水准。
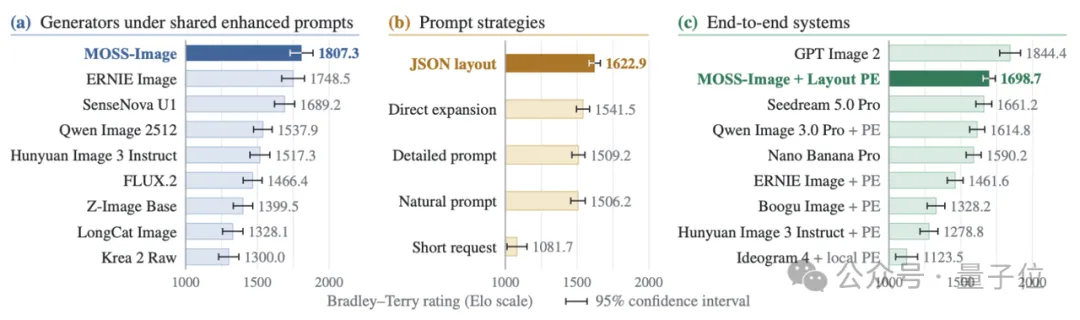
RLA 真实设计盲测显示,在仅提供简要设计要求的条件下,MOSS-Image 的 Elo 点估计(Point Estimate)达到 1698.70,位居参评模型次席,仅次于 GPT Image 2。
而在采用统一增强提示词的另一组对照中,MOSS-Image 的 Elo 点估计进一步提升至 1807.34,位列该组首位,超越了 ERNIE Image 和 SenseNova U1。
第三项核心能力是对超长复杂 Prompt 的支持。 MOSS-Image 最高支持 4096 tokens 的文本条件输入。
在常规文生图任务中,简短描述尚可应对;但面对多主体交叠、复杂空间关系、长段文本内容、多变运镜语言与细致视觉风格的专业设计任务,超长 Prompt 能够承载更为精准细腻的创作规范。与结构化 Layout 结合后,开发者可以同步定义画面内容与空间拓扑,显著增强生成结果的可控性。
为降低长 Prompt 的编写门槛,OpenMOSS 团队同步推出了 MOSS-Image Prompt Enhancer Skill 工具,可将简易创意构想一键拓展为详实 Caption 或结构化 Layout 提示词。
文字渲染、精准排版与超长 Prompt 这三项特质,清晰地指明了 MOSS-Image 的技术路线:推动图像生成从概念性的自由创作,进一步下沉至高要求、可精确控制的商业视觉设计。
在底层架构上,MOSS-Image 采用从零预训练的单流扩散 Transformer(Diffusion Transformer)架构。
其核心 DiT 主干规模达 5B 参数,搭配冻结权重的 Qwen3.5-9B 文本编码器与 FLUX.2 VAE,将文本条件与图像潜变量统一纳入端到端生成体系中。其中,Qwen3.5-9B 负责深度文本语义提取,FLUX.2 VAE 承担图像潜变量的编解码,DiT 则作为骨干网络主导扩散生成的核心建模过程。
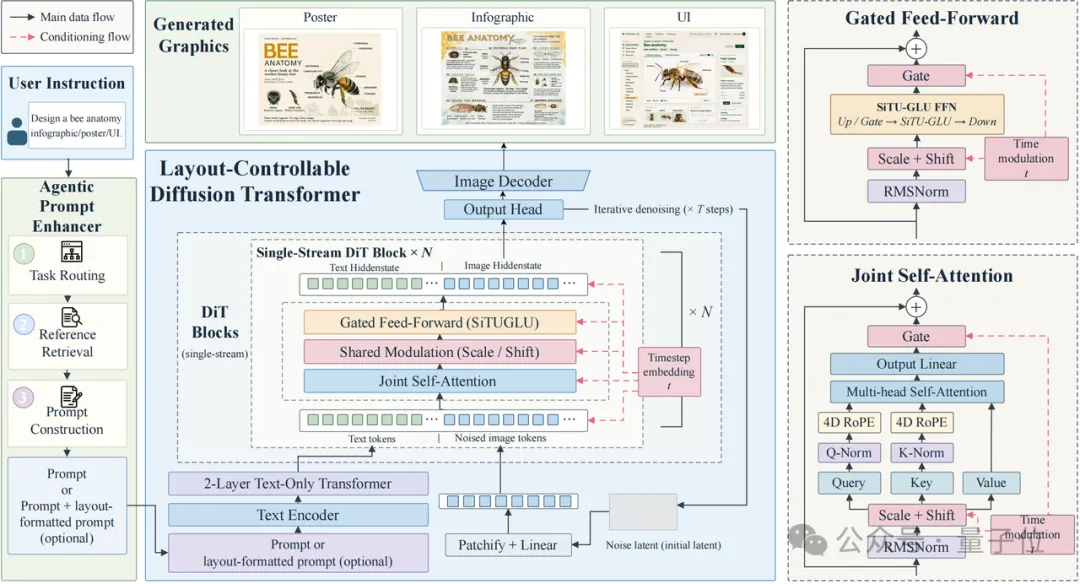
在训练数据治理环节,团队实施了精细化去重与质量过滤,全面剔除 AI 生成图像,最大程度保留真实拍摄图像的多样性,并针对水印、模糊等噪声特征建立了细粒度标注。
另一个尤为关键的工程细节在于,据 MOSS 团队披露,MOSS-Image 全程基于国产 PPU 算力平台训练完成。这为大型图像生成模型在异构算力生态下的工程训练与全流程适配积累了宝贵的落地经验。
开源仅数日,社区加速版、量化版与各类 LoRA 密集亮相
对于一款初出茅庐的开源模型,MOSS-Image 激发社区二次生态构建的速度同样令人侧目。
开发者首先聚焦于推理效率的优化。
MOSS-Image 官方推荐的基准推理配置采用 50 步采样,而社区已迅速展开对超少步数生成方案的探索。Lodestone 等开发者推出了基于 DMD 的 8 步加速方案,Rapid-MOSS 则更进一步将其压缩至 4 步即可出图。
这些方案为大批量图像生产与高频灵感试错提供了轻量化支持。
另一部分开发者则将重心转向边缘部署与推理加速。
INT8 量化、GGUF 格式、MLX 权重转换方案相继面世,各类面向特定运行环境的推理优化层出不穷。相关方案在显著降低显存开销、提速推理吞吐的同时,拓宽了模型在本地个人设备与轻量化开发工具上的部署可行性。
与此同时,社区对专用 LoRA 的微调探索也在全面展开。从复古胶片颗粒、手机随拍质感,到水粉艺术、动漫立绘及像素像素画,多元视觉风格的 LoRA 衍生模型不断涌现,充分验证了 MOSS-Image 优异的微调适应力。
在生态兼容方面,除 Diffusers Pipeline 与 ComfyUI 官方插件外,SGLang 与 vLLM-Omni 也在 Day 0 完成了全量适配;Ostris AI Toolkit、sd-scripts 等热门工具链亦迅速跟进支持,为开发者铺平了从模型微调到工程化集成的全链路工具支持。
从原始图像生成、精准版式布局到下游精细编辑,围绕 MOSS-Image 搭建的工作流体系日趋完备。尽管这些工具方案仍处于开源初期的测试迭代阶段,但全球社区表现出的开发参与度已极为可观。
目前,MOSS-Image API 已经正式上线开放。开发者无需承担本地硬件部署成本,即可直接调用其图像生成接口,快速集成至现有业务产品与生产流中。
此外,普通用户也可借助模思智能旗下的桌面端语音助手 MosMos,通过实时语音交互的方式使用 MOSS-Image 开展创意图像创作。
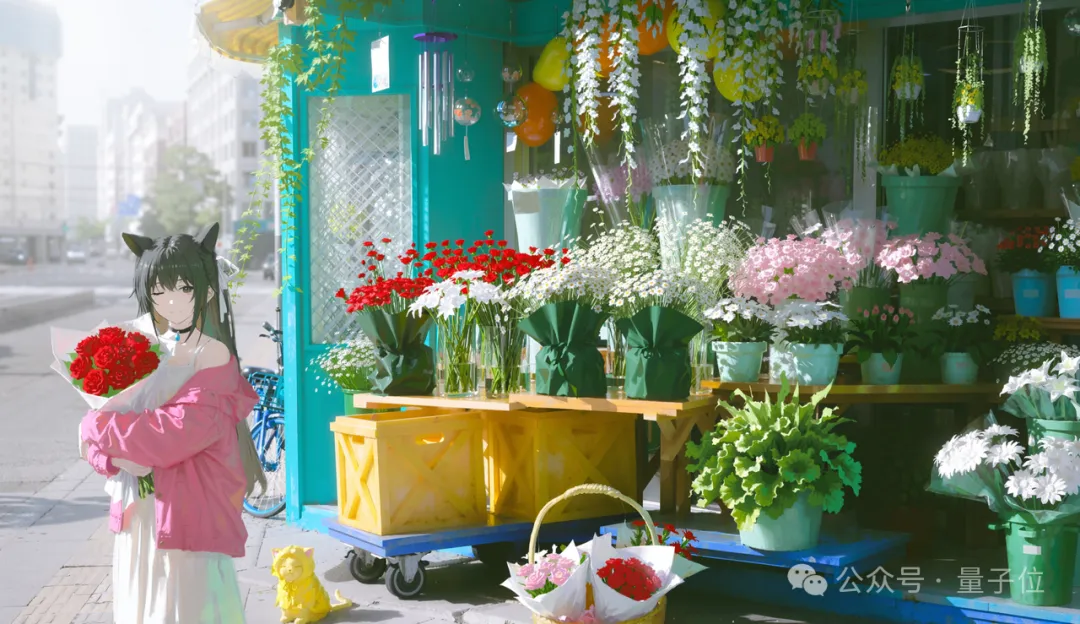
以下为社区使用 MOSS-Image 创作的部分精选作品:
值得关注的是,在 MOSS-Image 正式开源 4 天前,模思智能 MOSS 刚刚宣布完成了超 10 亿元人民币的 Pre-A 轮融资。
相关融资信息显示,该轮融资由华控基金领投,主要跟投机构涵盖国开科创、上海科创基金、新微资本、徐汇资本、追光硬科技创投、临港策源基金等,元禾控股、上海国投旗下上海科创集团、星连资本等老股东也持续加注。模思智能表示,资金将重点用于全模态实时交互智能的技术研发与全球商业落地,并持续探索 AI for AI 方向的前沿潜能。
除本次出圈的视觉图像模型外,仅在 2026 年上半年,MOSS 团队便已密集开源并交付了超过 20 款模型矩阵,业务触角延伸至语音生成、视觉感知理解等多个关键维度。
其中,MOSS-TTS 系列语音模型的累计全球下载量已突破 300 万次;此外,团队还相继推出了端到端视频理解模型 MOSS-VL,以及支持复杂会议场景的多发言人转写模型 MOSS-Transcribe-Diarize 等。
据悉,MOSS 团队近期还将陆续推出全双工实时交互系统 MOSS-Live 与新一代语音合成模型 MOSS-TTS 2.0,旨在进一步拉通并强化全模态环境下的实时交互体验。
从单点技术指标突破演进至高拟真交互系统,并深入复杂真实场景持续释放生产力价值,将是模思智能下一步迈向具身化智能世界的重要航标。
- 项目地址: https://github.com/OpenMOSS/MOSS-Image
- MOSS-Image API: https://platform.mosi.cn/
- 模型权重:
- 技术报告: https://github.com/OpenMOSS/MOSS-Image/blob/main/paper/MOSS_Image_Technical_Report.pdf
- 桌面端语音助手 MosMos: mosmos.io