
这是我们第一篇博文《智能体说它完成了,但数据库并不赞同》的后续。ThinkingBox-Training 现已在 GitHub 开源。
我们构建了 ThinkingBox,通过将最终的数据库状态与预期结果进行对比,来评估智能体(Agent)的工作成效。随后,我们在 ThinkingBox-Bench 之外的训练任务中,将这种可执行信号作为奖励函数使用。对于 Qwen3.8-27B,在进行了 50 个 GRPO 步数的训练后,其平均成功率从 51.70% 提升到了 60.78%,而在全部 20 次尝试中均正确完成的任务数量更是从 38 个跃升至 107 个。
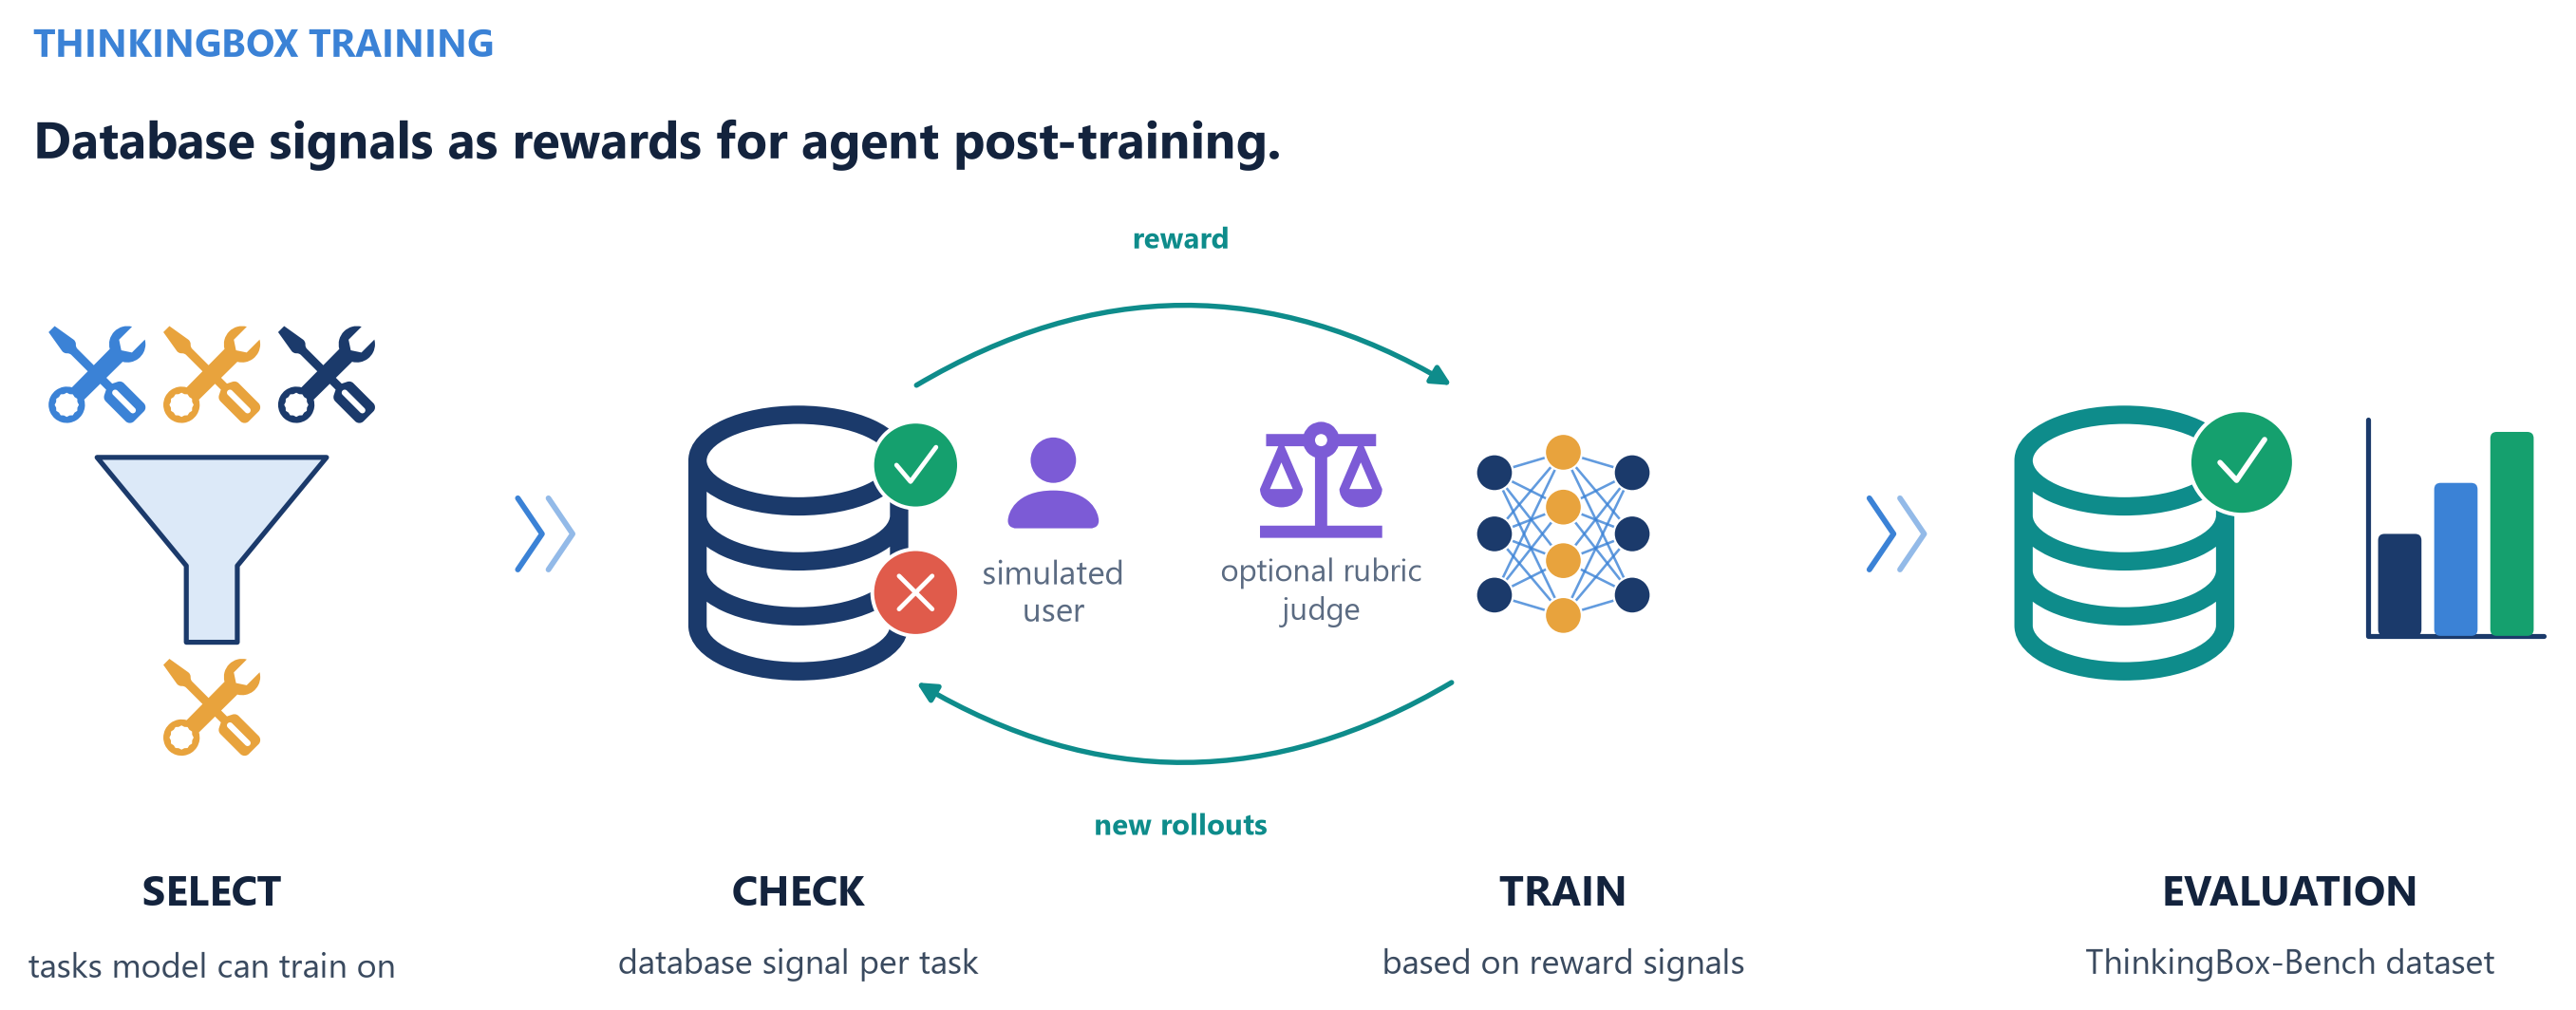
图 1. ThinkingBox 将对最终数据库状态的可执行检查转化为奖励,用于在 ThinkingBox-Bench 之外的任务上对智能体进行后训练(post-training)。
本文由微软与 Hugging Face 联合撰写,特别鸣谢微软的 Mirco Milletari 与 Xiang Jiang、Hugging Face 的 Sergio Paniego,以及前实习生 Zhuochun Li(匹兹堡大学)在合著与审校方面所做出的贡献。
我们构建 ThinkingBox 的初衷,是为了识别出那些自称已完成任务、实际上并未完成的智能体。
在基准数据集 ThinkingBox-Bench 的全部 507 个任务中,每一个任务都会为智能体分配一个真实后端和一套工具,允许它自由操作,随后检查数据库中实际发生了哪些变更。在第一篇文章中,我们捕获了一个案例:模型将客户工单标记为已解决(resolved),但其背后的承运商异常状态仍处于开启(open)状态。看似执行了 9 次合规的工具调用,最终却写入了一行错误的数据库记录。
随后我们意识到我们所构建系统的潜力:对于绝大多数任务,通过对最终数据库状态执行程序化检查,可以直接返回 1 或 0。这不仅仅是一个评分器(grader),它还可以充当奖励函数(reward function)。
因此,我们利用基准测试之外、符合 ThinkingBox 规范的任务构建了一个训练集,并将它们的可执行结果作为奖励。而其中的难点在于如何挑选哪些任务适合智能体训练:多数任务要么模型本身已经能够轻松解决,要么以模型当前的能力完全无法攻克,这两种任务都无法给模型带来任何有效学习。
难度是与策略相对的(policy-relative):一个任务对于当前的…