
发布于 2026 年 10 月 21 日
通过微调诸如 Qwen 和 Gemma 等通用开源模型来针对特定领域或任务进行专门化的模型,会继承一套面向众多领域和通用应用场景构建的词表。
在我们生产环境中运行的一款作文评分器中,该词表将模型最常写入的文本切分成了过多的 Token。本文将预先展示即将发表的 VocabX 论文中的部分成果:我们如何围绕每个 Token 的成本(而非其出现频率)对词表进行专门化定制,并在不改动基础模型的前提下,将实测推理成本降低了 77%。
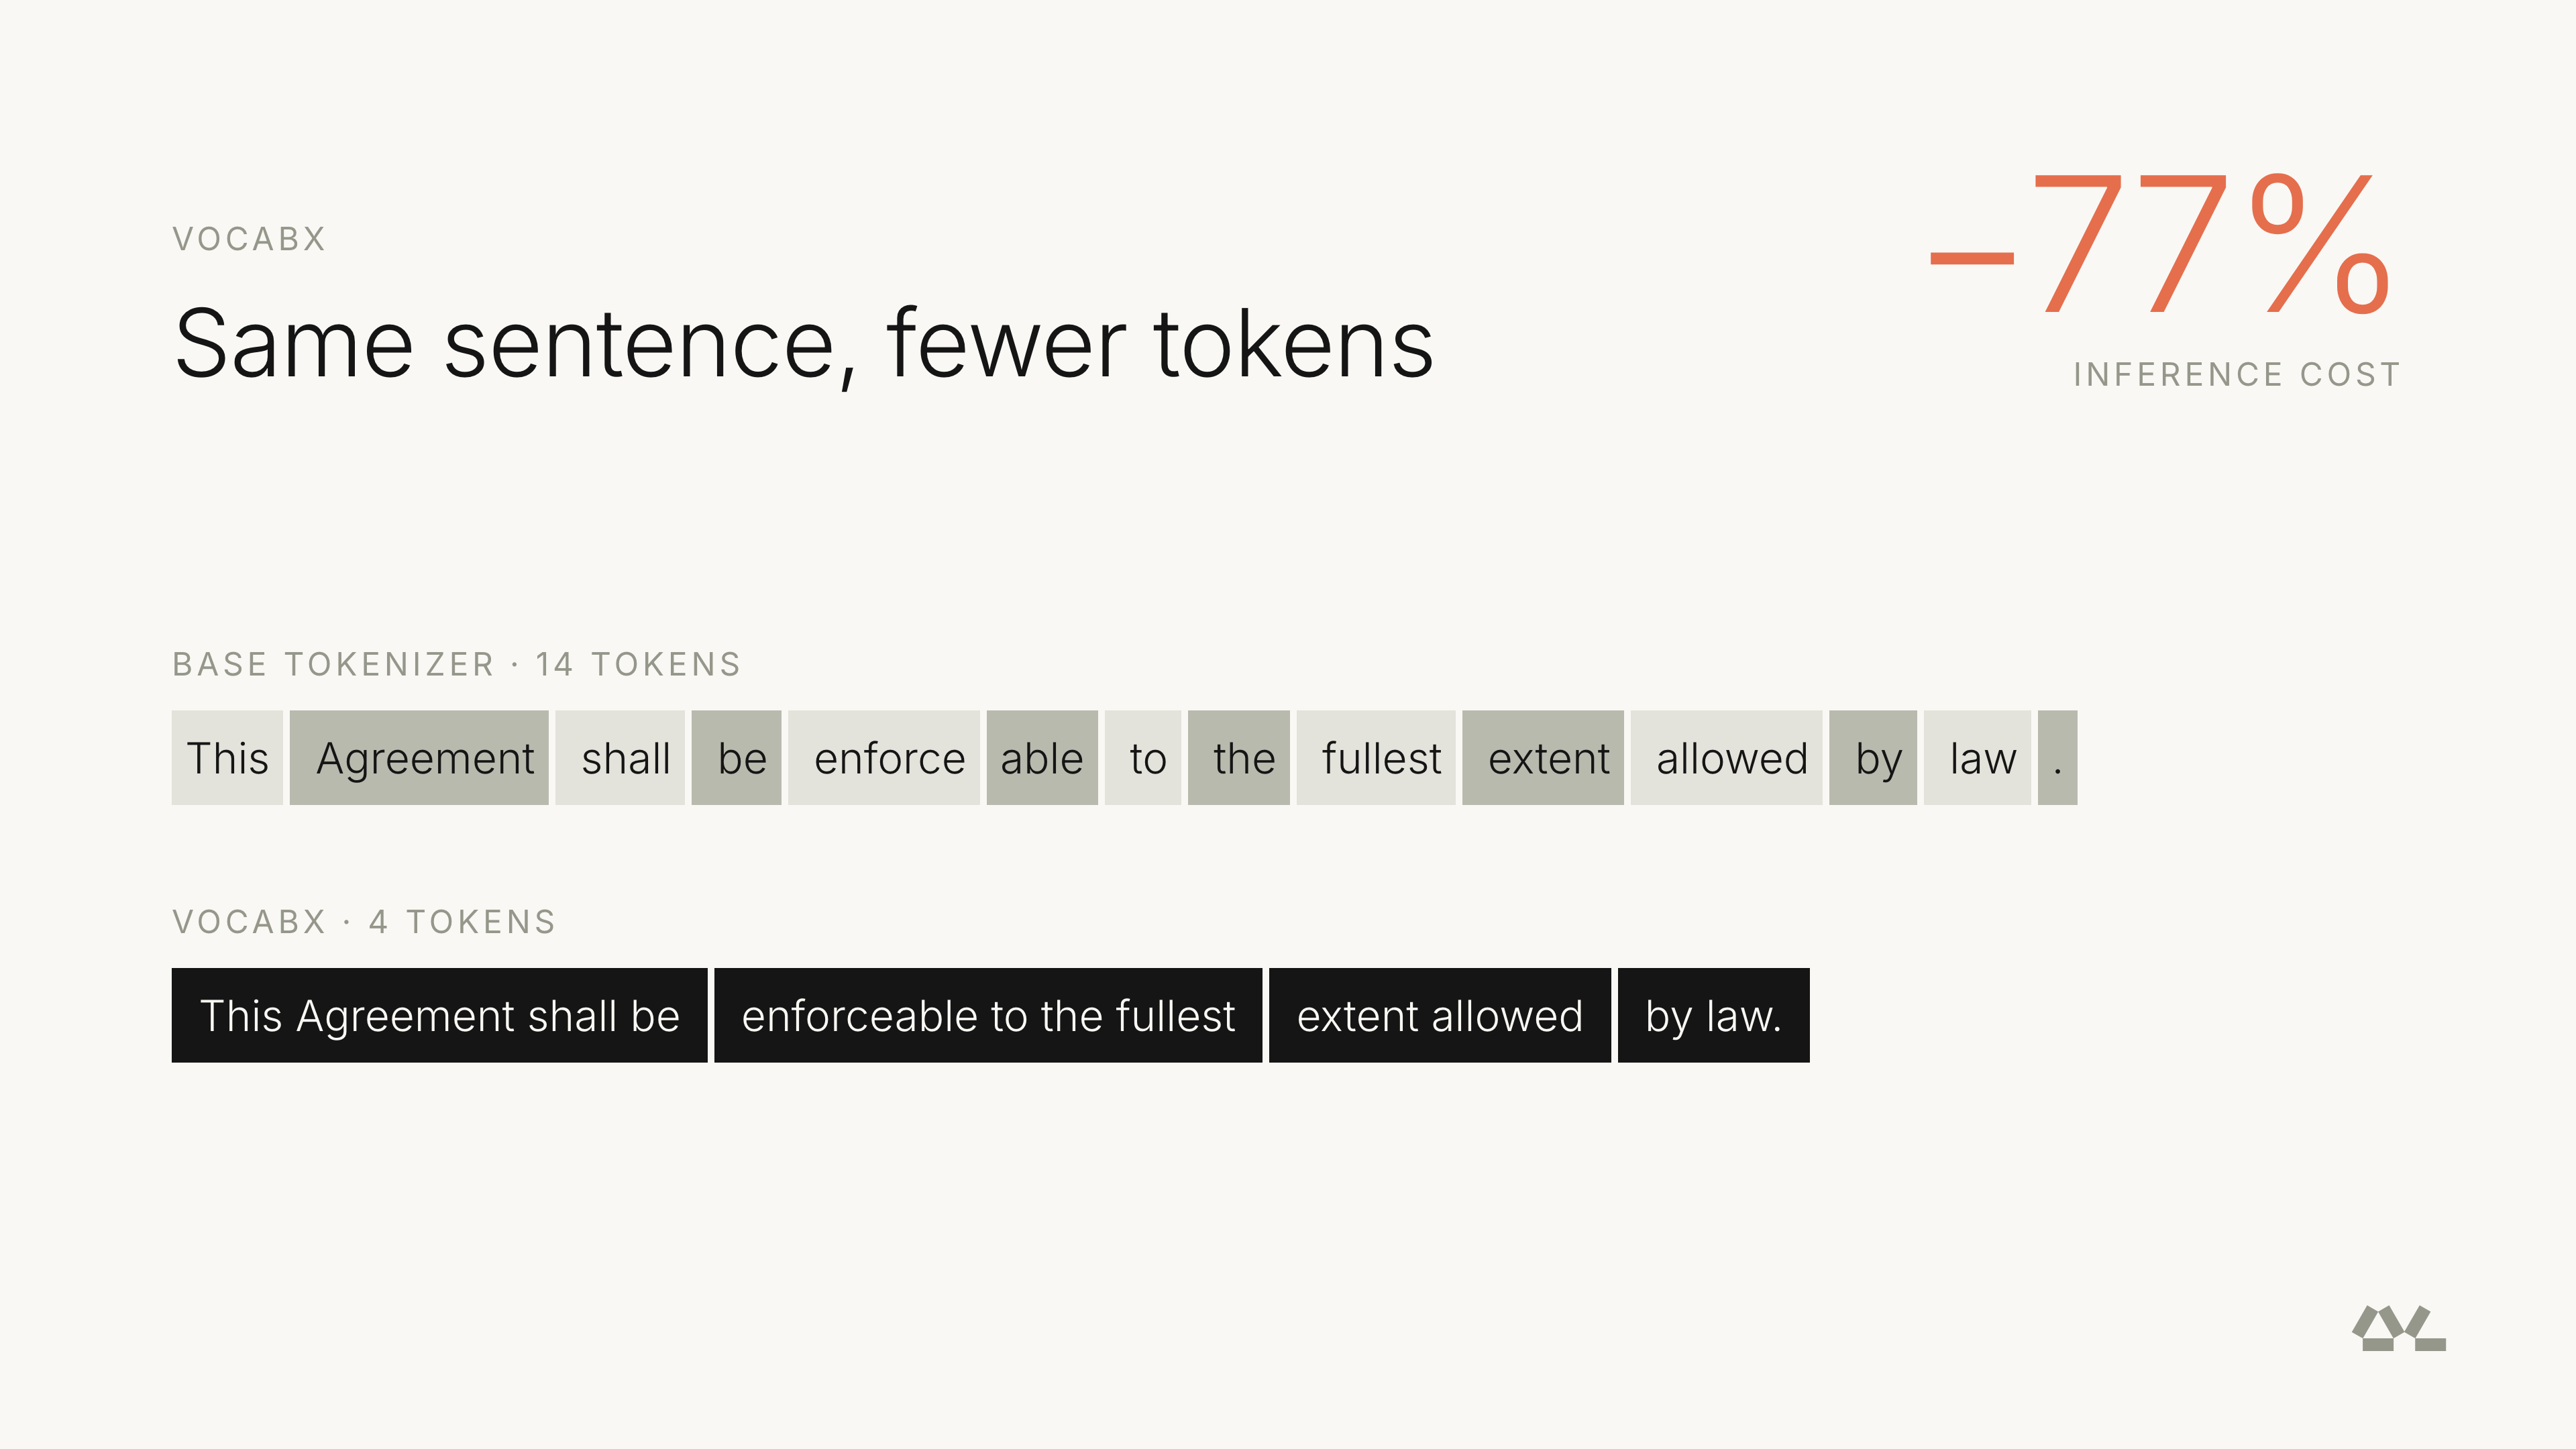
分词器(tokenizer)通常被视为基础模型的一项固定属性而被直接继承并保持原样。但对于专用于单一领域的模型而言,它可能是影响成本最大的调控杠杆之一,而且早在任何训练步骤开始之前它就已被敲定。
我们在生产环境中运行的系统之一是一款基于 Qwen3-4B 构建的葡萄牙语作文自动批改器。它接收作文、提示词及参考材料,并返回包含每项能力维度的评分与评语的 JSON 评估结果。
该模型体量本就较小(参数量为 40 亿 / 4B),且已针对该任务进行了专门训练。然而,它的分词器仍沿用 Qwen3-4B 的原始分词器,该分词器是针对多种语言和海量文本类型构建的。在评分器中,它仅用于单一语言(葡萄牙语)以及单一的回复格式。这带来了双重成本代价:评分器在每次请求中生成的文本消耗了不必要的更多 Token;并且在生成每个 Token 时,模型都要对包含 151,669 个条目的词表进行打分计算,其中包含了大量该任务几乎从未用到的词条。
我们采用一种名为 VocabX 的方法重构了该词表,同时保留了原有的基础模型、数据和训练配方。本文中的数据引自目前仍在审稿中的论文版本,在正式发表前可能会有所变动。
为所有人构建的词表
主流语言模型均以 Token 为单位进行读取与写入,而分词器决定了文本如何转换为 Token。主流通用模型的分词器基于跨多个领域和语言的大规模文本合集训练而成,涵盖从源代码到合同文档再到中文的各类内容。对于通用模型而言,这种选择是合理的。
但对于专用于单一领域的模型而言,这会造成两种浪