由 SerpAPI 倾情呈现:今天的发布内容信息量极大,但你可以将其全部抓取并转为适合你 Agent 使用的 Markdown 格式!相比 JSON 可节省 50% 的 Token 成本。
我们上一次报道推理拐点是在 4 月,从历史上看,大部分进展都来自闭源的百亿美元超级独角兽(decacorn),从 Fireworks 到 Baseten 再到 Modal。
现在,轮到开源领域的反击了。今天是 PyTorch 开发者大会的第一天,DeepSeek 瞅准时机投下了一枚洲际弹道导弹,引爆了全场讨论——他们开源了生产级技术栈 DeepInfer。该技术栈支持长达 72 小时的提示词缓存(Prompt Caching),相比之下 OpenAI 刚刚公布的缓存时长仅为 12 小时:
这是他们基于 vLLM 进行的深度定制版本(同时也致谢了 SGLang 和 TRT-LLM),里面加入了大量新特性……但去掉了他们最核心的“镇店之宝”——极致优化的 KV 缓存(紧凑格式 + 超过 8 小时的生命周期)、PD 分离/解耦架构(Prefill/Decode Disaggregation),以及负载均衡(其分布式存储系统 3FS 不久前已开源)。我们翻译了他们的官方博文并在此发布,同时附带了完整的研究指南、深度解析、代码地图(Codemap)以及子系统指南:
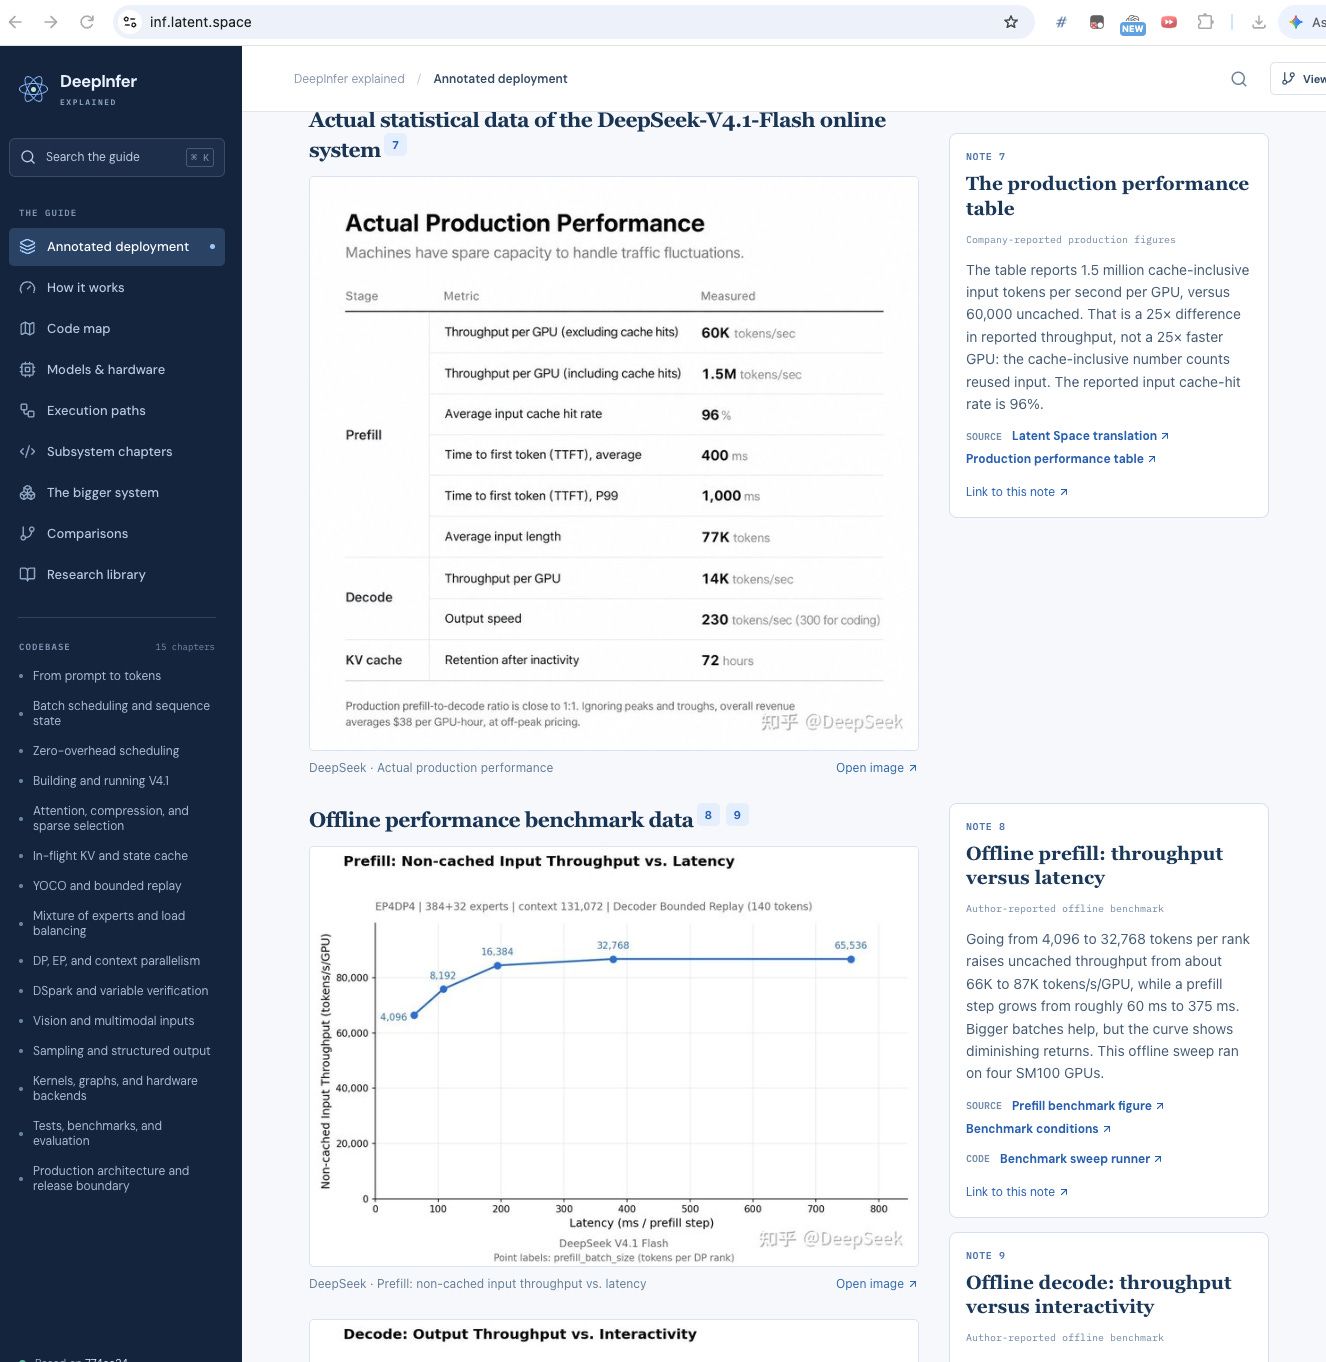
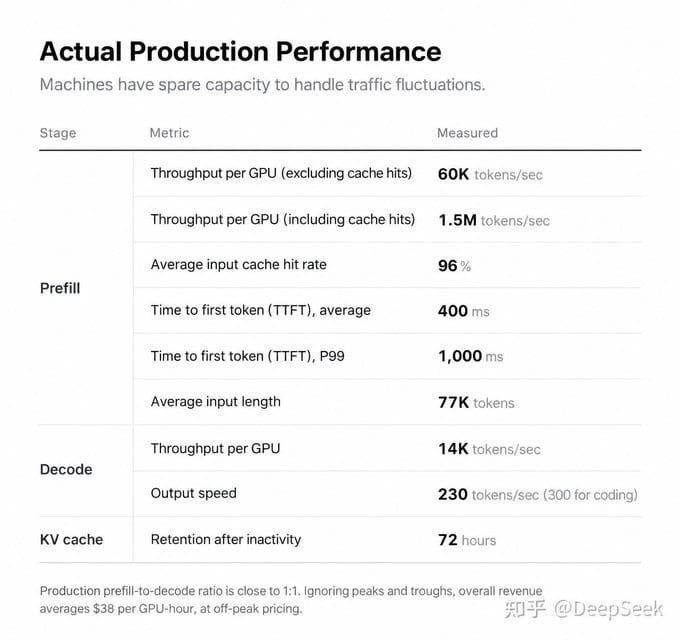
正如我们在对其补充披露的解读中所指出的,他们声称每天处理 155T(万亿)Token,即便按闲时价格计算,单张 SM100/A950 显卡每小时也能带来 38 美元的收益(目前每百万输入/输出 Token 价格分别为 0.15 美元 / 0.60 美元:按 1.55 亿百万 Token * 0.14 美元混合成本 / 24 小时计算,每小时收入约为 100 万美元)。根据他们公布的实际生产数据(我们对其进行了翻译):每张 Prefill GPU 每秒处理 150 万个包含缓存的输入 Token(输入缓存命中率达 96%),每张 Decode GPU 每秒输出 1.4 万个 Token(集群规模约为 2400 张 GPU):