
2026 年 10 月 20 日
初创企业
Terminal X 的 Eval Agent 依据 54 项指标标准对输出进行评分;在 GPT‑6.1 Sol 的支持下,对偏离基金投资范围(mandate)行为的捕捉率提升了 25%。
公司规模:初创企业
地区:北美
行业:金融
产品:API
25%
相较次优模型,在智能体回答超出基金投资范围时,GPT‑6.1 Sol 的检测率提升 25%
240 万美元
单个客户在尽职调查和投资工作流上实现的年化成本节省
+220 个基点
相较次优模型,GPT‑6.1 Sol 驱动的智能体与人工审核员的一致性高出 220 个基点(bps)
30%
相较次优模型,GPT‑6.1 Sol 每次查询的成本降低 30%
投资机构的竞争优势是一笔笔交易积累起来的,但每项决策背后的判断力通常仅存在于少数资深投资人的头脑中。一旦他们离职,机构就会背负 Terminal X 所说的“记忆负债”(memory debt):机构或许留存了文档,却丢失了背后的推理逻辑。
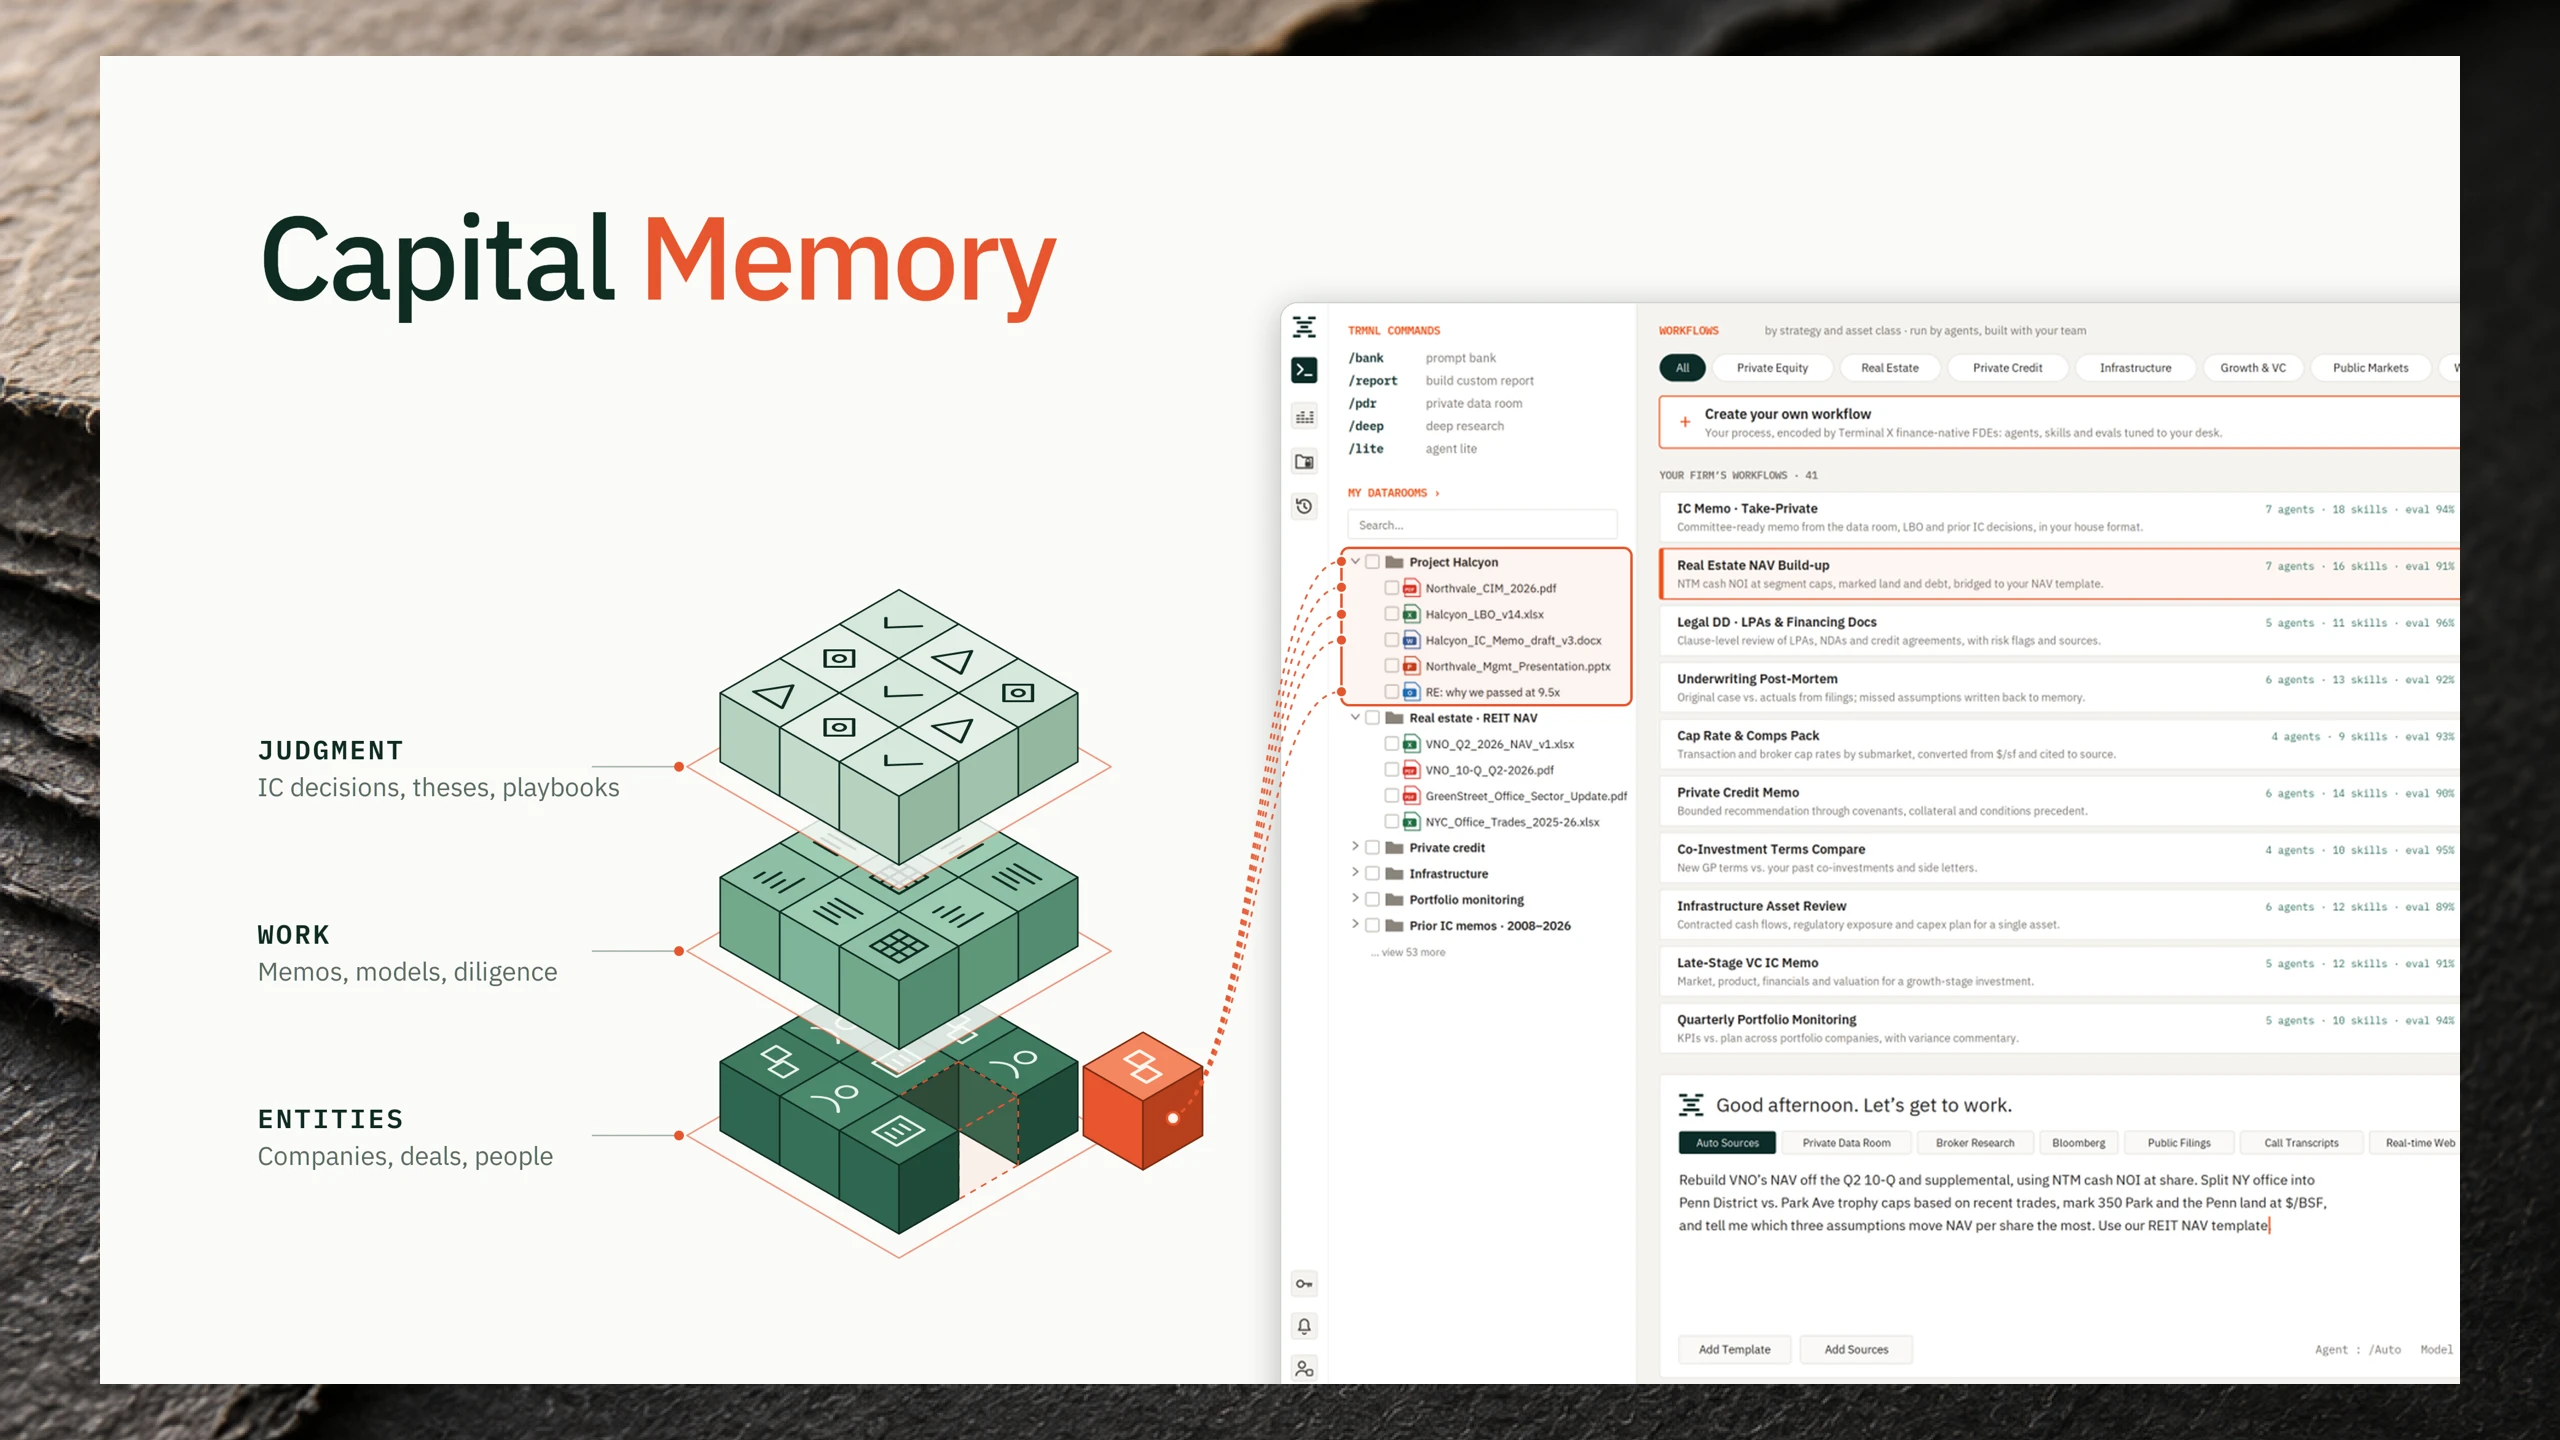
Terminal X 研发的 Capital Memory 操作系统旨在偿还这笔债务。该公司的前沿部署工程师(曾任职于摩根大通和黑石集团的金融与投资专业人士)直接入驻客户的投资团队,设计机构专属的智能体架构(agentic architecture),并将机构的投资逻辑代码化,固化到归客户所有的智能体中,部署于本地或私有云端。
包括 GPT‑6.1 Sol 和 GPT‑6 Luna 在内的 OpenAI 模型负责为这些智能体提供推理支持。同时,Terminal X 的 Eval Agent 会依据机构的标准对智能体的输出进行评估打分。借助 GPT‑6.1 Sol,Eval Agent 捕捉偏离基金投资范围推荐建议的能力提升了约 25%,并且在执行相同工作流时,单次查询成本比次优模型降低了约 30%。
“GPT-6.1 Sol 的长上下文推理能力与 Token 利用效率,使我们能够构建更深度的评估流水线。这帮助我们的 Eval Agent 将投资判断变得可衡量、可审计。”
—— Hyun Hong,Terminal X 联合创始人兼首席执行官
提炼并固化每家机构顶尖投资人的推理逻辑
针对每位客户,Terminal X 都会构建专门模仿该机构顶尖投资人投资风格的智能体。Terminal X 工程师会在客户现场驻扎数周,对机构公认的高水准投资备忘录进行逆向工程,提炼那些从未形成文字的隐性流程——例如信贷团队如何筛选借款人,或联合投资团队在撰写备忘录前会调用哪些信息源。
随后,这些流程会被编写进数百个智能体中,按资产类别和策略进行定制,并在每个投资阶段配备相应的子智能体。GPT‑6.1 Sol 负责处理需要深层判断和庞大上下文窗口的环节:提炼投资逻辑主线、识别关键考量因素,以及评估项目是否契合基金的投资范围要求。GPT‑6 Luna 则负责高吞吐量的任务环节,在这些场景下,Token 成本效率的重要性高于推理深度。
智能体在各机构的私有数据室(private data room)内运行,这是专供企业共享与管理敏感投资数据的隔离环境。智能体能够处理英语、韩语、日语和中文文档,并将其学习到的内容存储为“机构记忆”(firm Memory)——即记录某个特定业务团队如何做出一类决策的版本化档案,包括历史分析、投委会决策、工作流指引及机构核心观点(house view)。
工程师在 Terminal X 平台上将各项“记忆”转化为可复用的工作流;在生产环境中,每次查询都具备完整的可审计追踪路径:执行的步骤、检索的信源、调用的模型以及背后的推理过程。
根据 Terminal X 的数据,采用该方案为客户带来了显著的成本节省,其中一家私募股权投资机构报告称,通过自动化尽职调查和投资备忘录工作流,实现了 240 万美元的年化节省。
利用 Eval Agent 为输出评分并持续优化系统
为了根据机构自身标准审查智能体的回答,Terminal X 构建了评估智能体(Eval Agent)。这是一个基于 GPT‑6.1 Sol 及其他 OpenAI 模型编排的工作流,旨在像副总裁(VP)审核分析师工作一样,细致审阅智能体的每一项输出。
Eval Agent 会依据包含 54 项指标的评分准则检查每项输出,审查维度包括:各项数字、可比公司数据(comps)、市场一致预期数据及引述内容是否提取自权威信源?叙事逻辑是否严密成立?投资建议是否与机构的核心观点保持一致?
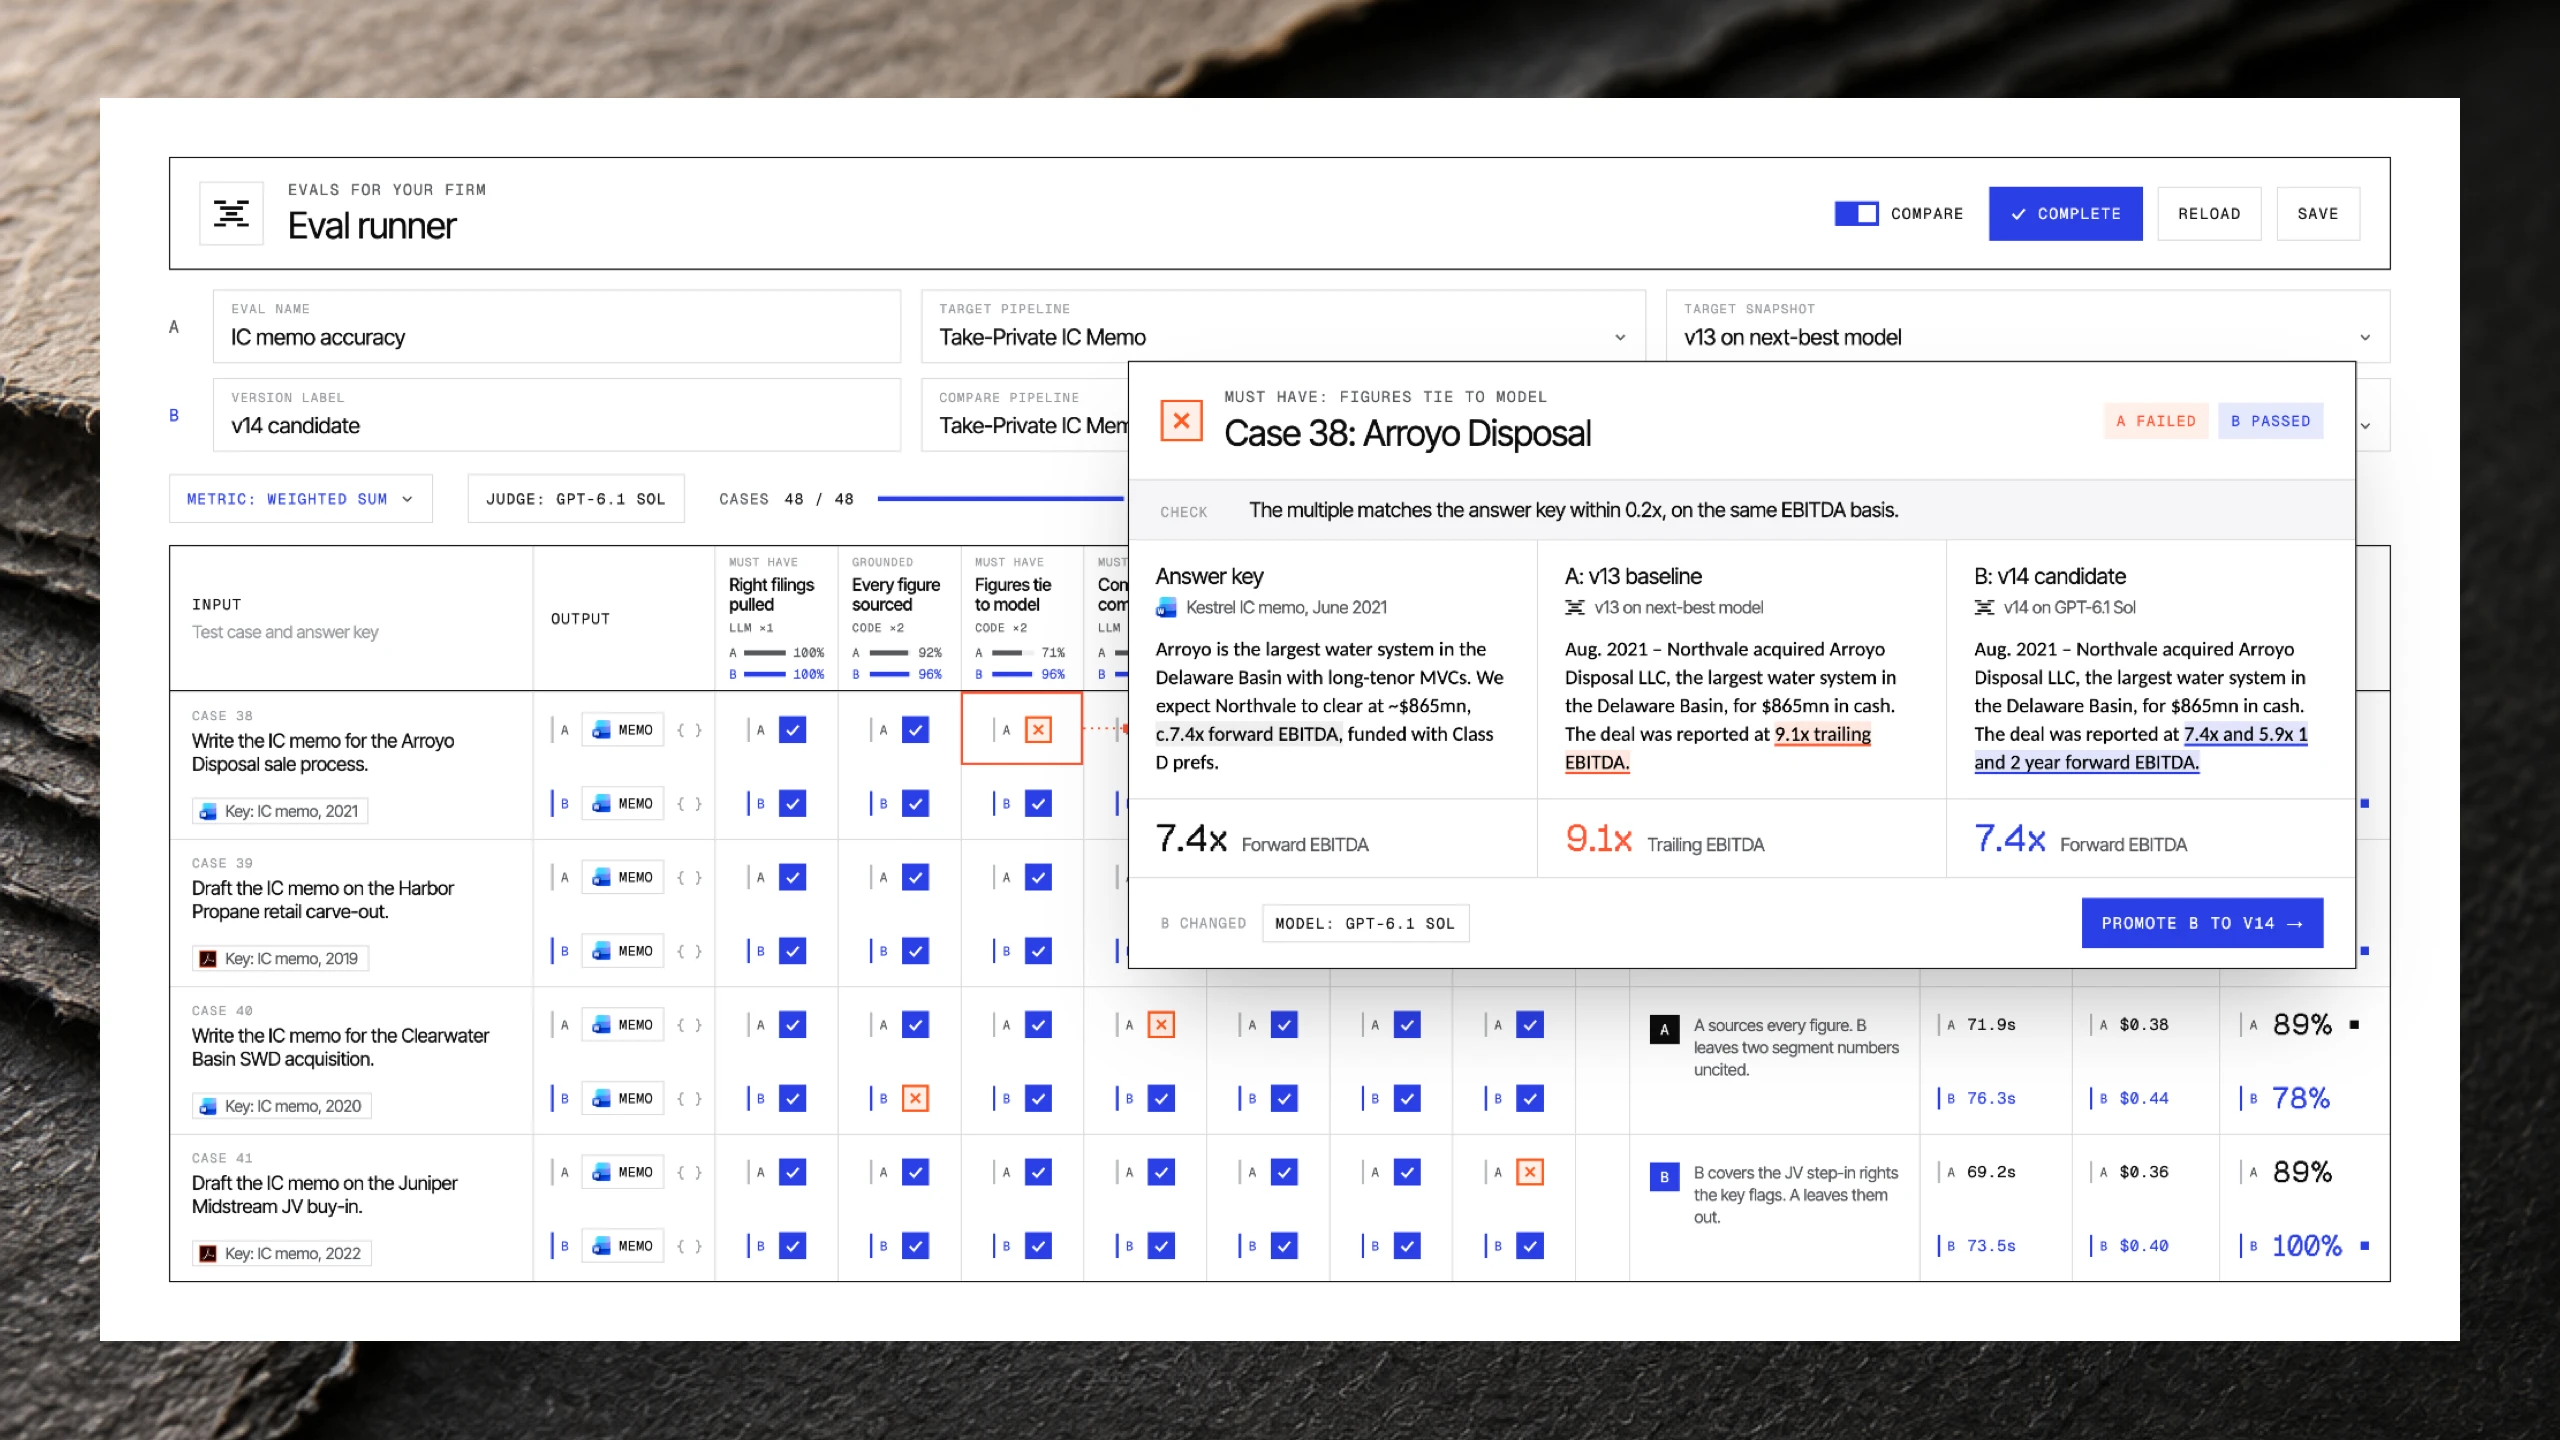
每项检查都会判定为“合格”(pass)或“不合格”(fail)。每次不合格都会附带一行原因说明、更优的替代信源或修正后的文本,并沉淀为一条“记忆”。例如,遗漏的数据源、错误的可比标的或偏离机构核心观点的论调,都会被固化为该业务团队的新工作流指引或新增测试用例。
“每一个回答都会经过评估,而分析师做出的每一次修正,都会让系统对该机构的工作方式多一份理解,”Terminal X 联合创始人兼首席技术官 Ken Lee 表示,“因此,机构使用的时间越长,智能体的思考方式就越贴近他们自己的团队。”
测试各类模型,按任务择优选用
Terminal X 根据自身的评估结果来选拔模型。在 500 次打分评判中,基于 GPT‑6.1 Sol 的 Eval Agent 与资深人工审核员的一致性达到了 88.6%,而次优模型为 86.4%,提升了 220 个基点。
GPT‑6.1 Sol 表现格外优异的一类错误是“风格漂移”(style drift)。例如,某并购基金的投资要求是寻找交易价格低于资产净值(NAV)的私有化标的、评估承销该资产并完成融资架构设计。当情景模型预测市场拐点出现时,部分交易方案开始建议转向困境债权投资或纾困融资。在 GPT‑6.1 Sol 驱动下,Eval Agent 对此类偏离投资策略行为的检出率提升了约 25%。