
是石科技发布 TokenFleet 调度框架
GPU 集群中,请求排队与资源闲置往往可能同时发生。
在 2026 CCF 全国高性能计算学术大会期间,是石科技发布新品 TokenFleet 分布式调度框架,将优化重点放在请求路由、跨机房容量协同与混合负载治理上,致力于提高现有算力的有效产出。
如果把大模型推理服务看作一座“国产 Token 优化工厂”,GPU 是生产设备,推理实例是工位,业务请求则是一张张生产订单。TokenFleet 所负责的,正是将订单与产能进行高效、精准的匹配。
面对同一批设备,接收的任务类型不同、分配策略不同,最终的等待耗时与达标产出也会大相径庭。规模化算力服务,必须将这些生产调度安排统筹考量。
TokenFleet 聚焦集群的有效产出
模型部署上线后,集群往往需要同时应对多元化的业务场景。
多模型共享集群算力,不同租户的服务等级要求(SLA)也各有差异:短对话需要毫秒级低延迟响应,长文档分析高度依赖计算与显存资源,离线批量任务则有明确的截止期限。当服务节点分布在多个机房时,还需考量各地算力容量能否高效协同。
粗放的分流机制极易导致部分实例排起长队,而其他节点的算力未被充分利用。长上下文请求与批量任务相互挤占,会拖慢实时交互速度;而请求超时、取消以及重复计算,更会造成宝贵的 GPU 资源浪费,无法形成有效交付。
在保持模型质量、服务要求与算力预算一致的前提下,TokenFleet 致力于通过提高有效 Token 产出,降低单位有效产出的综合成本。
其由三项核心技术协同分工:
- TokenPilot:负责在同一模型池内优选推理实例;
- FleetMind:专注于跨机房容量的宏观协同;
- SLOMax:主打混合负载的准入控制、队列治理与容量分配。
请求如何分流、任务何时入队、机房容量如何联动,最终都指向同一个核心指标:成功完成且满足服务等级要求的有效 Token 产出。
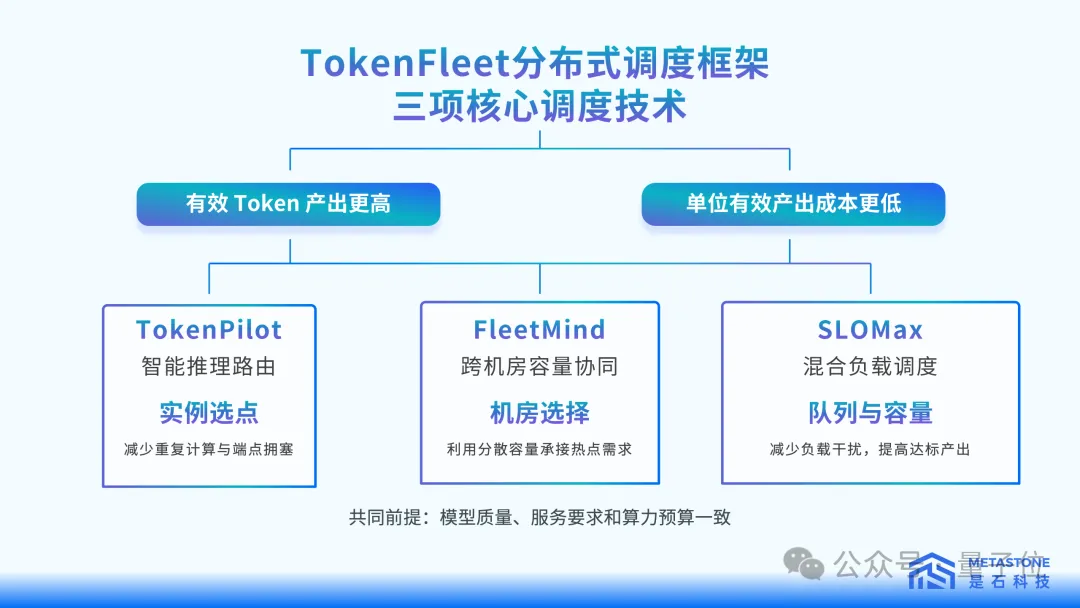
△图1 TokenFleet 三项核心调度技术总览
TokenPilot:兼顾缓存收益与排队代价
在请求路由的实例选点环节,一次请求究竟该发往哪个实例?
一个简短问答与一份长篇文档,即使在统计上均计为一次请求,其消耗的计算量与显存开销也存在数量级的差距。若仅依据请求数量进行简单负载均衡,很难拉平各个实例的实际工作负载。
KV 缓存机制则引入了更复杂的权衡:若将携带相同长前缀的请求路由至已缓存相关 KV 的实例,便能复用历史计算结果,大幅减少 Prefill 阶段(处理输入上下文)的重复计算。
然而,缓存命中率高的实例往往面临更高的并发排队风险。若请求过度向单点倾斜,节省下来的计算时间很可能被漫长的排队等待所抵消。
TokenPilot 在选点时,会同时权衡缓存复用收益与排队代价。系统结合输入上下文长度、输出预算与可复用前缀来预估计算工作量,并综合评估队列深度、在途 Token 数、KV 显存压力以及预测延迟,对候选实例进行综合评分与筛选。(注:输出预算仅作为路由约束条件,并不等同于最终实际输出长度。)
调度器据此量化对比不同实例的预期处理成本,精准判断复用缓存所省去的计算开销是否足以抵消额外的排队等待。
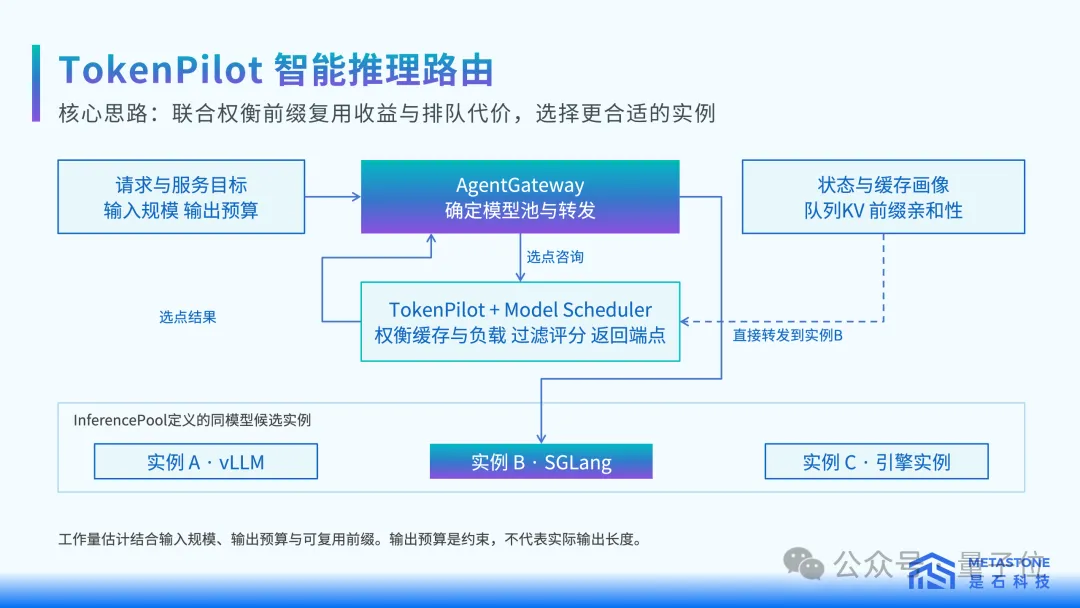
△图2 TokenPilot 智能推理路由框架
是石科技公布的 GLM-5.3 调优数据显示,在所测硬件集群与特定负载条件下,采用基于预测延迟的路由策略后,P95 首 Token 延迟降低了 32.4%,P50 首 Token 延迟降低了 71.3%。
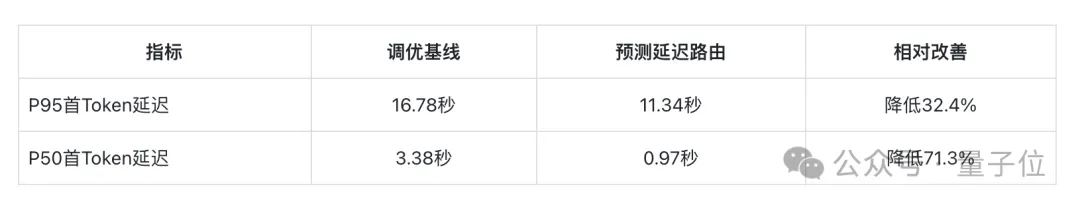
△表1 TokenPilot 首 Token 延迟调优结果。数据来源:是石科技大会演讲材料。改善率按(基线值-优化值)÷ 基线值计算;延迟下降不直接等同于成本下降。
其中,P50 反映调度的中位数响应水平,P95 则反映长尾请求的等待表现。该组数据展示了基准测试环境下的响应改善,整体成本收益仍需结合系统吞吐与实际资源占用综合评估。
FleetMind:跨机房算清实际可用容量
当调度视野从单集群扩展到多机房时,决策层便多了一重全域容量判断。
节点存在空闲 GPU,并不意味着能够立即承接请求。目标模型是否已部署、权重版本是否一致、服务端点是否处于就绪状态,以及跨地域的网络传输耗时,均会显著影响最终交付表现。
FleetMind 的核心是评估实际可用的模型服务容量。在 TokenFleet 架构中,它统一汇聚各机房的模型部署状态、实时容量余量与网络通信链路,先在宏观层面决策承载机房,再交由该机房的本地调度引擎选派具体推理实例。
当热点机房出现队列堆积时,系统会动态评估异地机房是否具备同版本模型的就绪端点及富余算力,进而判断是否支持将合规的新请求跨地域调度执行。
请求能否外溢,首先受制于数据安全规范与权限地域限制;而是否值得外溢,则需综合权衡回源时延、排队时间、计算负载、缓存收益以及跨域网络传输成本。
跨机房协同同样覆盖多重时间尺度:短期内灵活微调新请求路由,中长期则统筹指导模型副本分布与节点预热,并结合容量预留、负载上限感知与自动故障回退机制,最大程度避免容量错配。
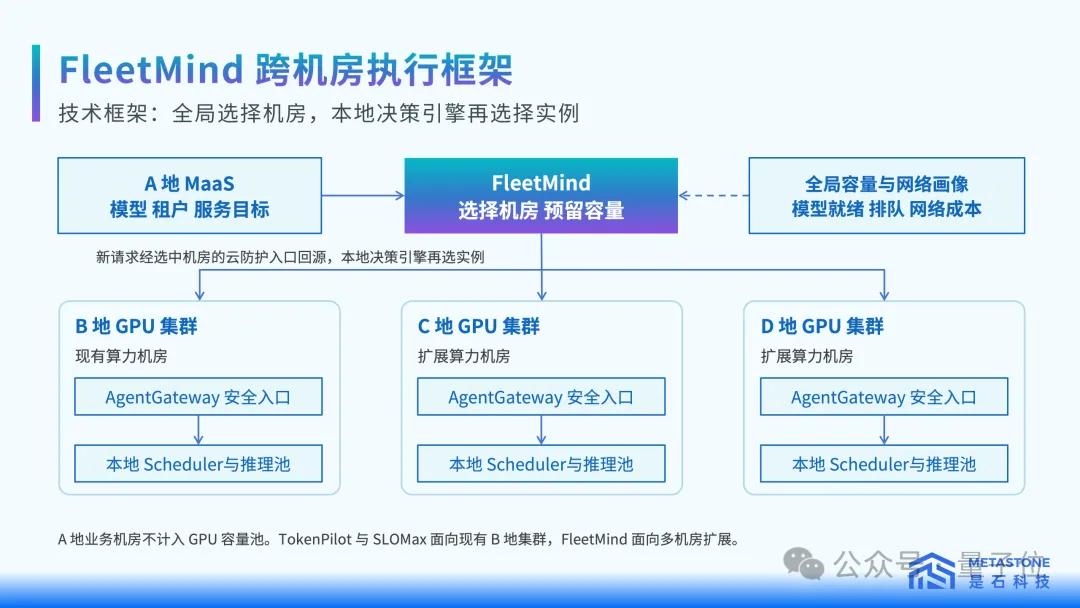
△图3 FleetMind 跨机房执行框架。说明:A 地为业务入口,不计入 GPU 容量池;B 地为现有集群,C、D 地为扩展机房。
TokenPilot 与 SLOMax 侧重于现有存量集群的精细化治理,FleetMind 则服务于新增算力机房的横向弹性扩展。跨机房调度的核心目标,是在满足业务合规约束的前提下,激活分散的空闲算力以应对突发热点需求,消除孤岛效应与重复预留造成的资源浪费。
SLOMax:按服务等级精准治理混合负载
进入同一集群的业务请求,各自的交付 SLA 要求截然不同。
实时对话追求极短的首 Token 延迟与流畅的生成速率;长上下文处理依赖深度的 Prefill 能力与充足的 KV 显存空间;离线批量任务则更注重截止时间与整体批处理吞吐。将这些异构请求杂糅在同一队列中,极易诱发严重的算力争抢。
过长的 Prefill 耗时、KV 显存膨胀以及高并发批量任务,都会对交互式请求造成资源挤占。随之引发的请求超时、主动取消与重试执行,更会导致部分计算资源做“无用功”,无法转化为有效交付。
SLOMax 综合分析输入规模、输出预算、业务类型及租户服务等级(SLO),识别其实际工作量特征,进而实施差异化准入、分池排队与动态容量平衡。它在优先保障高交互容量的同时,有效隔绝长短请求混跑造成的性能抖动。
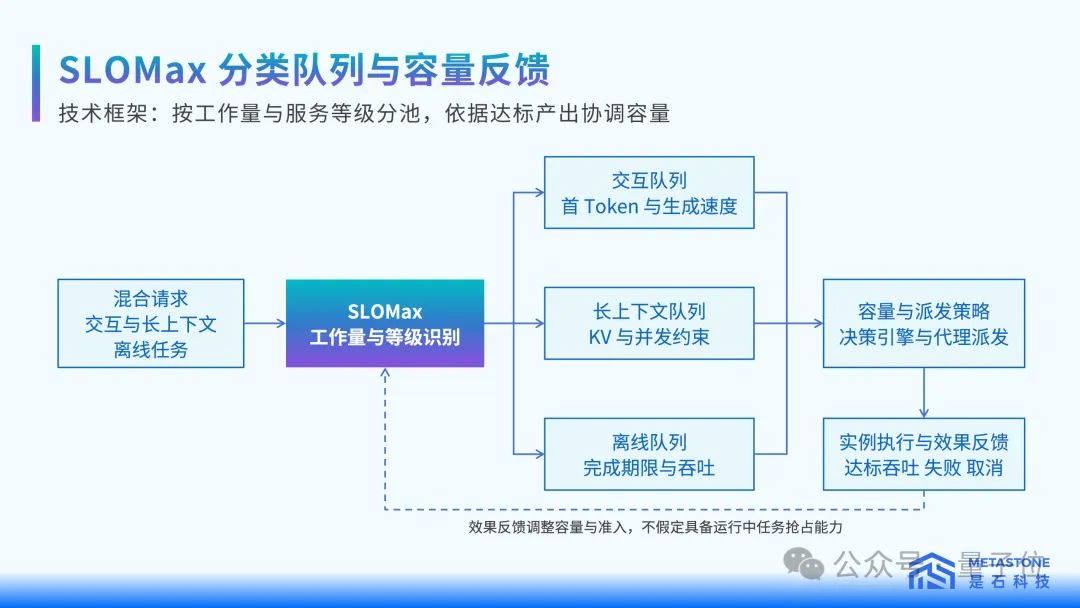
△图4 SLOMax 分类队列与容量反馈框架。说明:效果反馈用于动态调整容量配额与准入门槛,框架不预设运行中任务的强行抢占能力。
在衡量整体调度表现时,TokenFleet 将“达标产出”确立为关键调优指标。
Goodput(达标输出吞吐) 的定义为:在完整的测试周期内,所有成功交付且符合预定服务等级要求的请求所生成的有效 Token 总量,除以测试时长。不同类型的业务任务,需设定独立的达标门槛并分别统计。
系统将达标吞吐量、失败率、取消率与重复计算开销等指标实时反馈至调度中枢,动态迭代准入阈值与算力分配比例。衡量集群效率,不仅要看 GPU 占用率与峰值总吞吐,更应关注最终真正转化为达标履约的产出规模。
在是石科技披露的 GLM-5.3 收益测算模型中,接入流控协同调度策略后,集群总输出吞吐微增约 1.5%,而达标输出吞吐(Goodput)提升了约 29.4%,整体达标比例从约 67% 增长至约 86%。
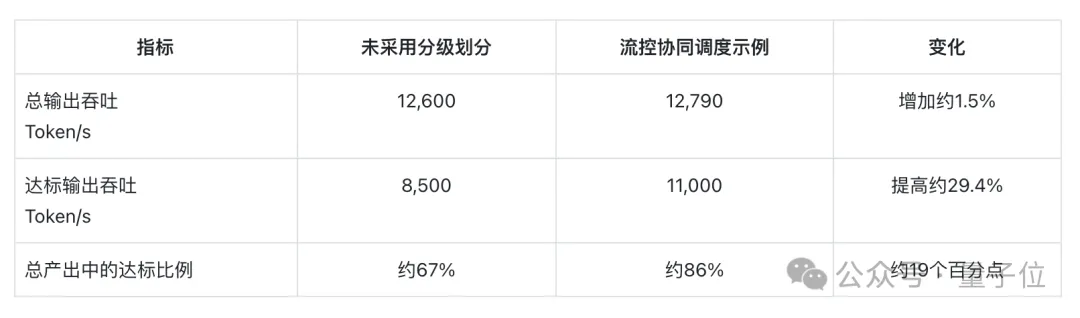
△表2 SLOMax 有效 Token 吞吐收益测算示例。数据来源:是石科技大会演讲材料。本表为收益测算示例;达标比例沿用原文取整值,变化约 19 个百分点。
上述数据属于测算示例,展现了调度架构在改善产出质量上的潜力,其实际商业收益仍需结合生产环境的具体负载与服务指标进行验证。
在总产出规模相近的情况下,若能大幅减少超时丢弃与冗余重试,便能释放出更多的达标 Token 产能。SLOMax 通过指标闭环反馈机制,持续优化后续的全局资源分配。
国产 Token 优化工厂的效率,核心在调度
TokenFleet 将大模型推理的性能调优推进到了分布式集群层面。单实例性能如何在多请求间高效分配,跨地域机房的算力如何无缝组合,都需要通过智能化调度框架将底层硬件基础设施与上层业务 SLA 紧密缝合。
是石科技(METASTONE)定位为独立第三方全栈算力运营商,不绑定单一模型生态,专注于为企业客户提供涵盖硬件选型、组网设计、任务调度、性能优化与集群运维的一站式全栈算力交付方案。
依托源自国家级计算中心的深厚积淀,其运营的算力集群运行 SLA 保持在 99.95% 以上。目前,是石科技已纳管超过 20,000P+ 的异构算力资源,运维 10 余个超智算中心(包括 2 个国家级超算中心);核心团队曾荣获 3 项高性能计算领域桂冠“戈登·贝尔奖”,在超大规模异构算力集群全栈交付上具备丰富实战经验。
围绕“国产 Token 优化工厂”的技术构想,是石科技通过自研自用的技术闭环持续打磨底层系统软件,旨在降低通用、高频模型推理的边际成本,让国产硬件发挥出更强劲的实际效能。
此前推出的 Meta-Infer 推理引擎,重在压榨单推理实例的计算执行效率;而本次发布的 TokenFleet,则将核心聚焦于集群分布式调度,通过精准的请求路由、弹性跨域容量协同与细粒度混合负载治理,构建规模化生产的技术底座。
让更多业务“用得起、用得好”大模型能力,既需要先进硬件提供原始算力,更依赖底层系统软件把庞大的集群产能高效组织起来。TokenFleet 的探索,正在把进一步降本增效的关键,落实到每一次请求的合理分配与每一份算力容量的极致释放中。