
兔皮底下,竟然是 MiniMax!
国庆期间在 OpenRouter 上横空出世、匿名屠榜的神秘模型 Space Bunny(玉兔),马甲终于被揭开了。
兔皮底下,竟然是 MiniMax!
其正式发布的型号代号为 M3.1 Flash。
而这一正式版的跑分表现,比 Space Bunny 时期还要更进一步,尤其是在 Agent(智能体)能力上:
Agents’ Last Exam(ALE)得分 29.6%,斩获国产模型第一。
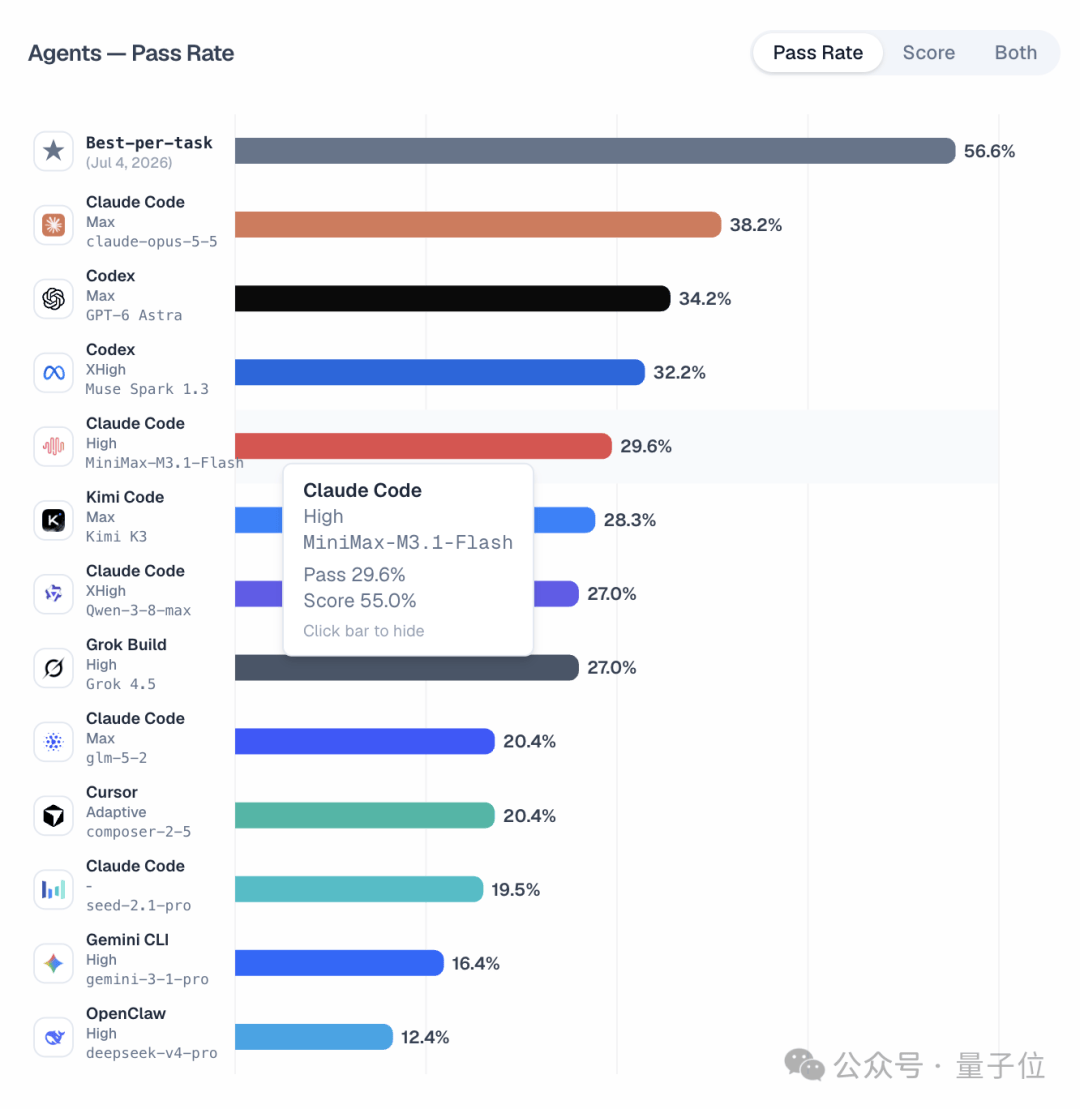
在 AA 榜单上也拿到了 43 分,作为一款 Flash 级别的轻量模型,这个成绩相当亮眼。
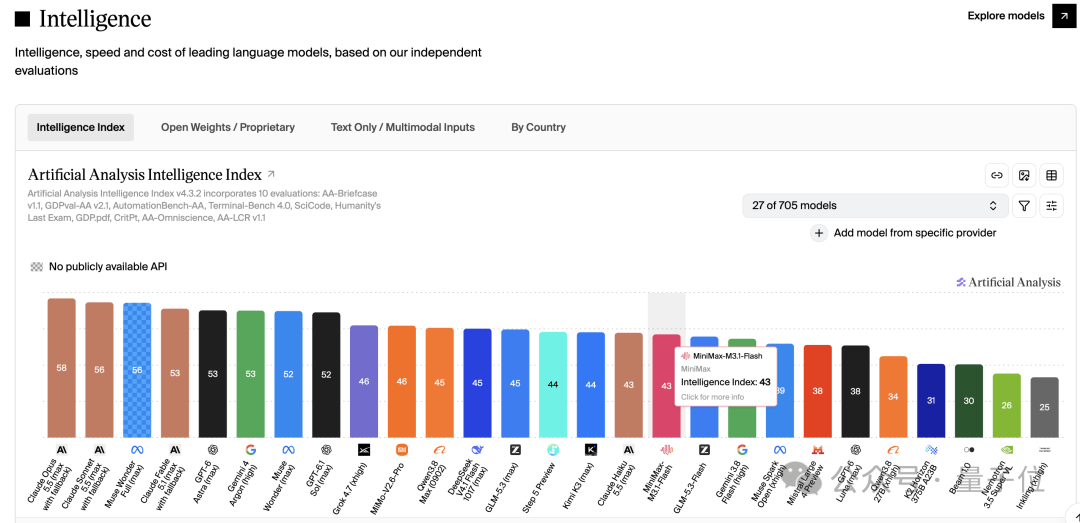
综合执行任务的能力显著跃升,堪称晋升为“高级打工人”。
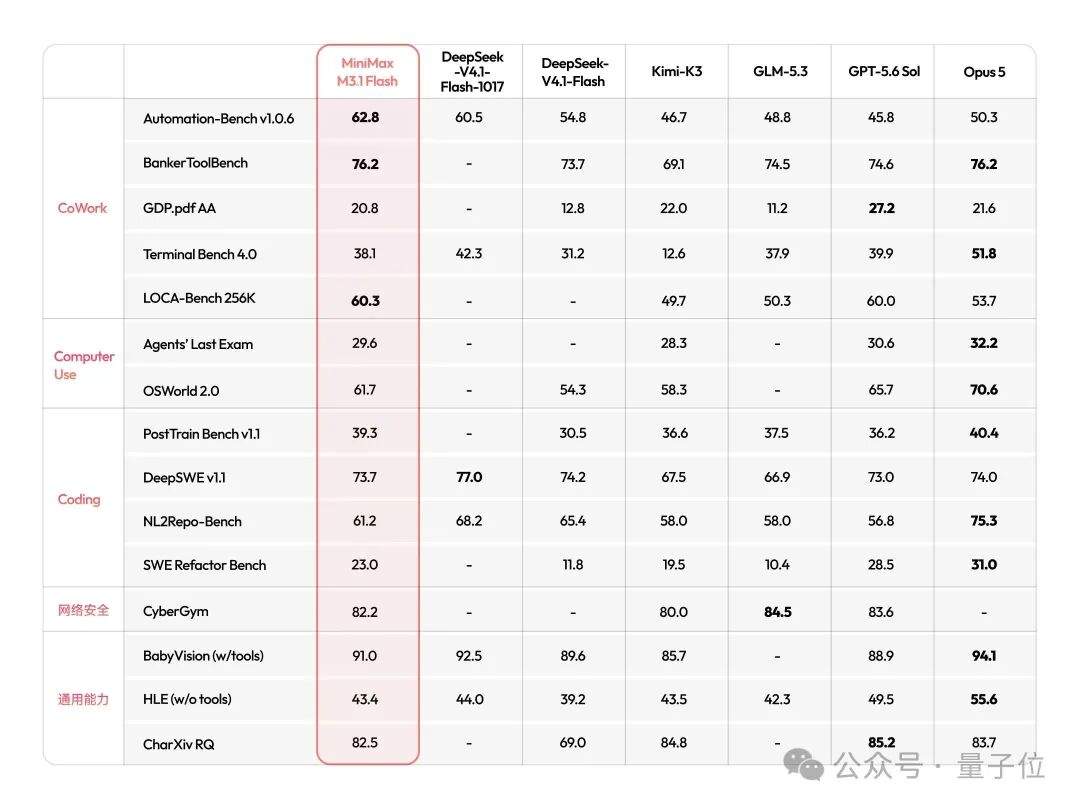
除此之外,在 Coding、网络安全、Computer Use 等维度,也全面跻身全球第一梯队。
在此基础上,它依然保持了“玉兔”时期的高速推理水准,输出峰值速度可达 200+ TPS。
更关键的是——
不愧是 Flash 系列,价格极其亲民:
- 输入每百万 Token 仅需 1 元;
- 输出每百万 Token 仅需 4 元;
- 缓存读取每百万 Token 只要 0.1 元。
综合使用成本直接压缩至上一代 M3 的 30%。
如果对这个价格还没有直观概念,简单来说:
基本与谷时阶段的 V4.1 Flash 相当。
太良心了,堪称“闲时梁文谷,忙时闫俊峰”(bushi)。
△ 图源:@大厂显微镜
反观硅谷闭源阵营,恐怕又要面临新一轮压力。
继 DeepSeek 之后,硅谷一众大参数旗舰,再次被国产 Flash 模型逼上了一条全新的性价比斩杀线。
文本模型翻身仗
坦白讲,此前外界对 MiniMax 不乏质疑。
多模态和视频生成确实亮眼,但在纯文本大模型领域,似乎沉寂了相当长一段时间。
这次 M3.1 Flash 的亮相,无疑打了一场漂亮的翻身仗。
来看具体的基准测试成绩:
代码工程与真实 Bug 修复
在 DeepSWE v1.1 评测中,M3.1 Flash 拿下了 73.7% 的高分。
GPT-6.1 Sol、Claude Opus 5、Claude Fable 5 等一众旗舰,跑分均被这款 Flash 反超。
排在它前面的,仅剩 DeepSeek V4.1 Flash 1017 的 77 分。
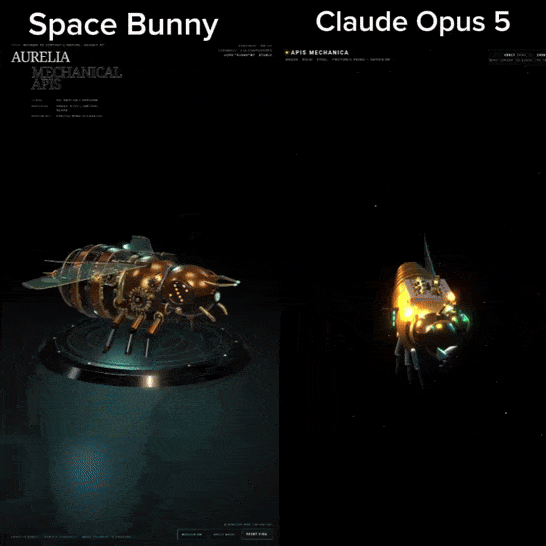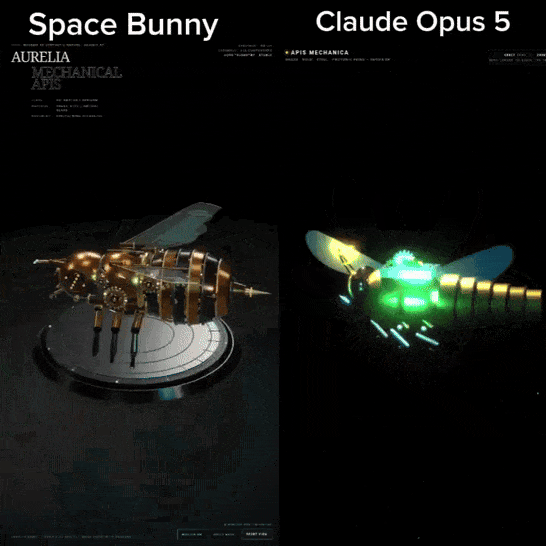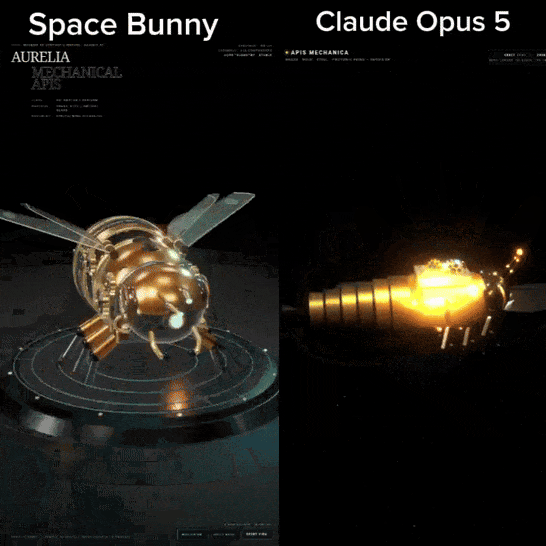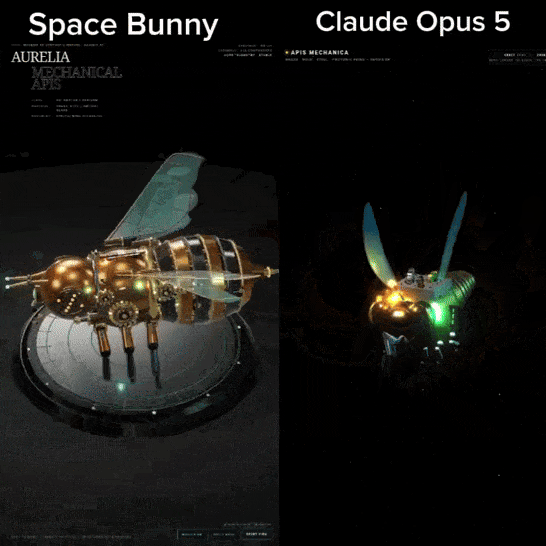
这也印证了此前玉兔匿名测试期间社区的反馈:在处理 Three.js 等 3D 渲染与复杂前端任务时,它对细节的把控极其精准到位。
网络安全实战
在加州大学伯克利分校主导的 CyberGym 基准测试中,M3.1 Flash 斩获 82.2 分,紧随 GLM-5.3(84.5)和 GPT-5.6 Sol(83.6),稳居全球第一梯队。
复杂 Agent 与企业级跨 SaaS 工作流
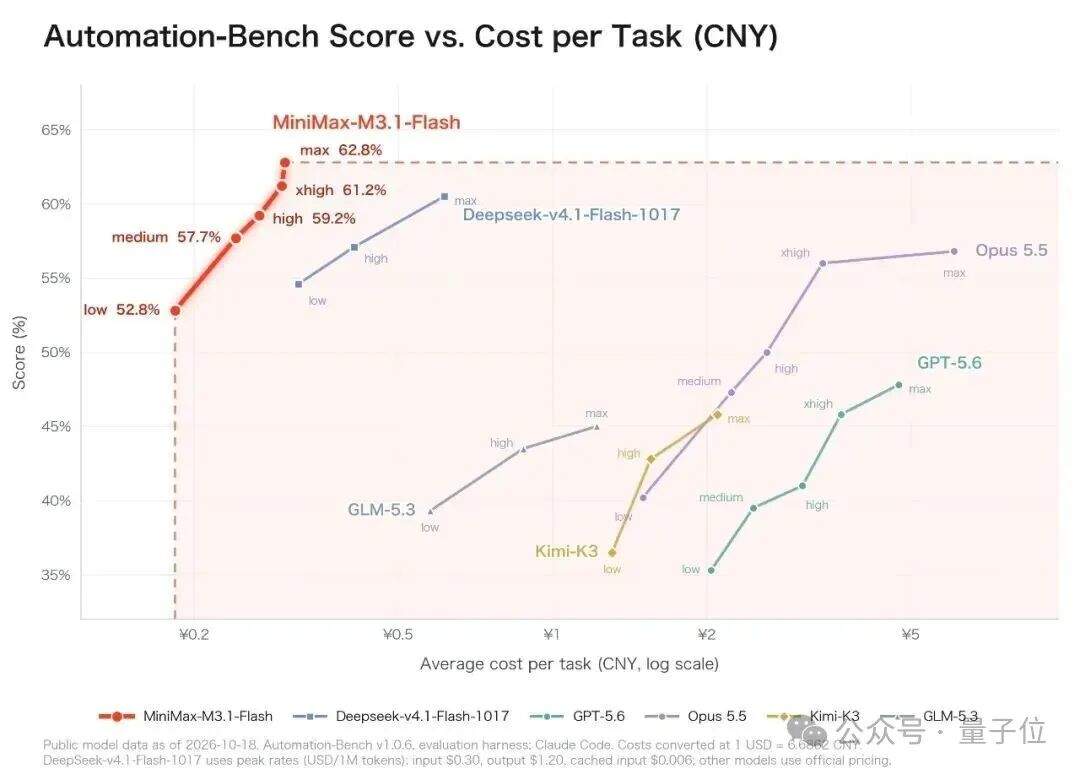
在自动化平台 Zapier 开源的 AutomationBench-AA 评测中,M3.1 Flash 位居前列。
单任务成本不足 0.05 美元,便能自主串联起横跨销售、营销、客服、财务及 HR 的复杂工作流。
在对容错率要求极其严苛的金融专属基准 BankerToolBench 上,M3.1 Flash 更是直接拿到 76.2 分,与公认的天花板 Claude Opus 5 并列全球第一。
Computer Use 真实桌面操作
模拟真实电脑操作的 OSWorld V2 拿下 61.7 分;
而在衡量真实商业价值场景的 ALE 评测中,M3.1 Flash 同样以极低的任务成本,跑出了顶尖旗舰级别的表现。
两项成绩均位列国产模型第一,再次展现了极强的性价比优势。
外界普遍预料到 MiniMax 的纯文本模型终会重返核心牌桌,却未曾想到挑起大梁的会是一款带有“Flash”后缀的轻量级模型。
极速低价才是王道
脱离基准跑分来看,真正让人瞩目的,是该模型对实际产业落地场景带来的冲击。
在构建多 Agent 协同或长链路工作流时,开发者最常面临两大痛点:漫长的等待延迟,以及月底令人心惊肉跳的 API 账单。
一个成熟的企业级 Agent,在后台往往需要调用数十次工具,并在多个子 Agent 之间频繁通信。
模型吐字速度慢,用户因界面长时间加载而流失;调用成本高昂,业务则可能因账单超标而直接停摆。
M3.1 Flash 的核心优势正在于此。
其底层采用了相当激进的稀疏注意力架构。
线上推理速度提升近 3 倍,输出峰值可达 200+ TPS,中位数(P50)也稳定保持在 170+ TPS。
170 TPS 意味着什么?
在 MiniMax Code 桌面端、Claude Code 或各类本地编码工具中下发重构任务,代码几乎能够瞬间呈现在屏幕上。
以往串联四个子 Agent 时的顿挫感,如今已转变为接近无感的流畅交互。
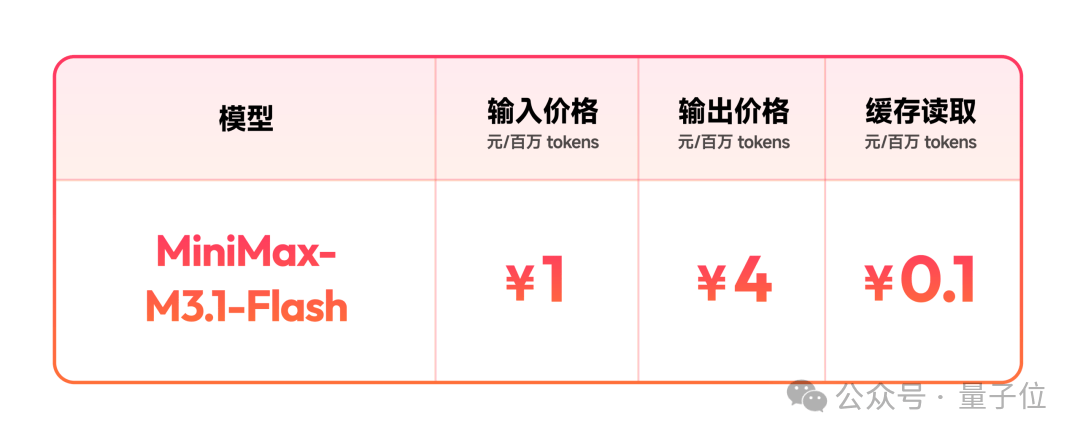
速度提升的同时,调用价格也大幅下调:
- 输入价格:每百万 Token 仅 1 元;
- 输出价格:每百万 Token 仅 4 元;
- 缓存读取价格:每百万 Token 仅 0.1 元。
输入与输出成本直接减半,缓存读取费用更是直降 75%。
最终,综合使用成本相较前代 M3 骤降 70%。
对开发者与企业而言,大规模调用的门槛已被大幅拉低。
国产双子星反围剿
此前行业内普遍存在一种认知:Flash 模型往往只是旗舰大模型的低成本阉割版。
选择 Flash 通常是受制于预算或用于轻量级任务;一旦进入关键复杂的严肃场景,最终仍需切换至大参数的 Pro 旗舰。
但如今局面正在改变。
DeepSeek V4.1 Flash 1017 刚刚确立了新的性价比标杆,MiniMax M3.1 Flash 紧随其后发布,两款模型接连展现了极高的能效比。
小尺寸模型已不再局限于试验性质,完全具备了正面抗衡数倍参数、十倍价格旗舰模型的能力。
更有趣的是,这两款国产 Flash 模型展现出了高度互补的差异化路线:
- DeepSeek 在纯代码工程领域将极致性价比推向新高度;
- MiniMax M3.1 Flash 则在跨 SaaS 企业工作流、金融工具链调用等综合 Agent 能力上形成了明显优势。
一个专精于代码工程,一个深耕复杂业务流程。
针对特定场景,甚至可以衍生出灵活的路由策略:
在不同负载和时段下合理调度模型资源,忙时调用 MiniMax,闲时借助 DeepSeek,实现 Token 成本与系统性能的最优解。
这种模式也让 API 调用成为普通用户更具性价比的选择。
大模型技术迭代极快,即便是按月订阅的 C 端服务,也可能在模型快速更新换代下面临性价比下滑的风险。
与此同时,C 端产品普遍存在 5 小时调用额度限制、深夜额度重置以及动态降智等体验痛点。
转向 API 调用后,用户仅需按需充值,根据各家表现灵活切换,体验反而更为灵活自如。
过去一段时间,海外头部大厂接连发布新一代旗舰,市场上一度充斥着“LLM 竞争格局已定、硅谷正凭借 Scaling 赢者通吃”的论调。
但转折点似乎正在到来。
两款国产 Flash 模型相继登场,正推动旗舰级能力以极高的速度与亲民的价格走向普惠。
追求顶尖 SOTA 固然是一场硬仗,但在“性价比”与“工程可用性”逐步被攻克之后,另一场关乎大模型产业落地的战役才刚刚拉开帷幕。
而工程落地与场景深耕,恰恰是中国科技企业一贯擅长的领域。