
新版本 V4.1-Flash-1017 发布,还开放了自研搜索 API
对上了,都对上了。
前两天 DeepSeek“先崩后补偿”,就有人猜测 D 老师这是要有新动作。
结果还真让大家蹲到了——新模型 DeepSeek-V4.1-Flash-1017 火速上线。
换上新模型后,DeepSeek Harness 全新 0.2.1 版本也迎来了能力增强。官方对此表示:
新模型训练时针对 DeepSeek Harness 进行了专项优化,在提升任务表现的同时,缩短任务运行时间、减少输出消耗和 token 费用。
干活更快、更省,综合表现也更能打了!
此外趁着周末,D 老师还顺手放了一波福利:
符合条件的用户首次登录 DeepSeek Harness,可以直接领取 6 元赠金,无需充值,到账后 7 天内有效。
需要划重点的是,额度限量发放,赠完即止。
性能更强、花费居然更少了
领完福利再来看这款模型的亮点(之前登录过 Harness 的用户记得先退出重新登录)。
目前官方网页端、APP 与 API 模型已同步切换为新模型。
与上一版 V4.1 Flash 相比,1017 版本在各项基准测试中几乎全线飘红,代码与 Agent 任务等能力均有显著提升。
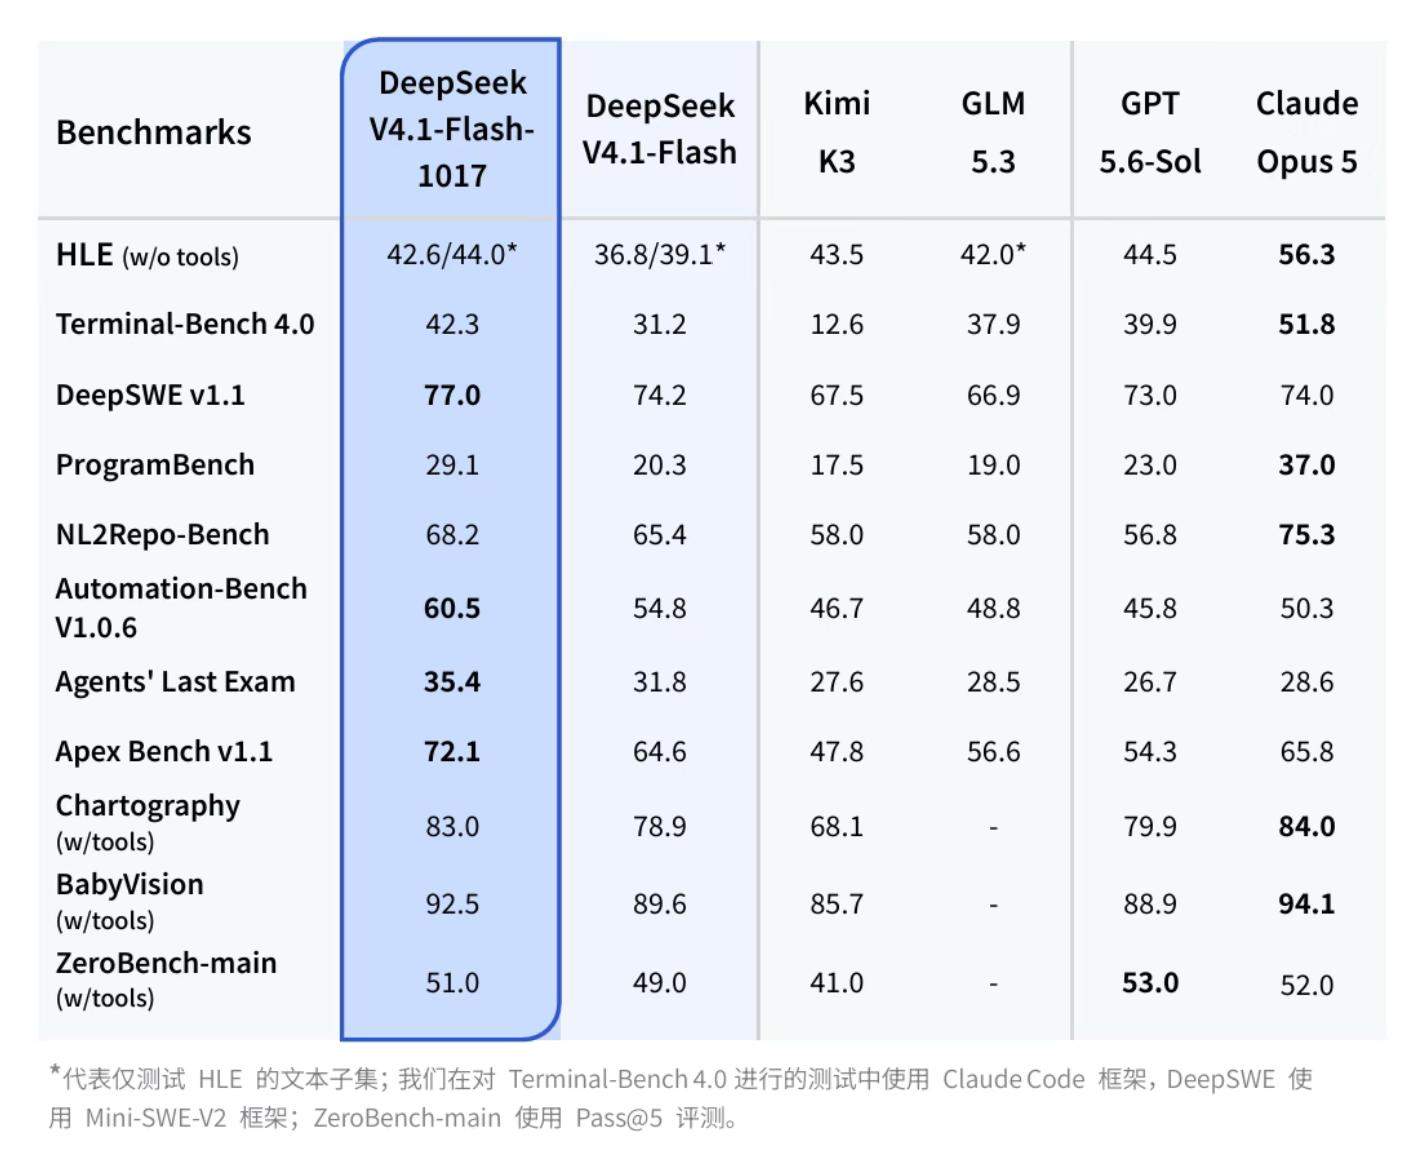
但单纯涨分,还称不上这次更新最厉害的地方。
因为在模型性能往上冲的同时,任务运行时间和输出长度反而被同步压低了。
官方将这种状态称为“性能—费用的帕累托改进”。以往想让 Agent 把活儿干得更好,通常不得不接受它多思考一会儿、多跑几个步骤、多消耗些 Token。
而在 V4.1-Flash-1017 上,模型开始尝试少绕弯路、少说废话,直奔任务交付目标而去。
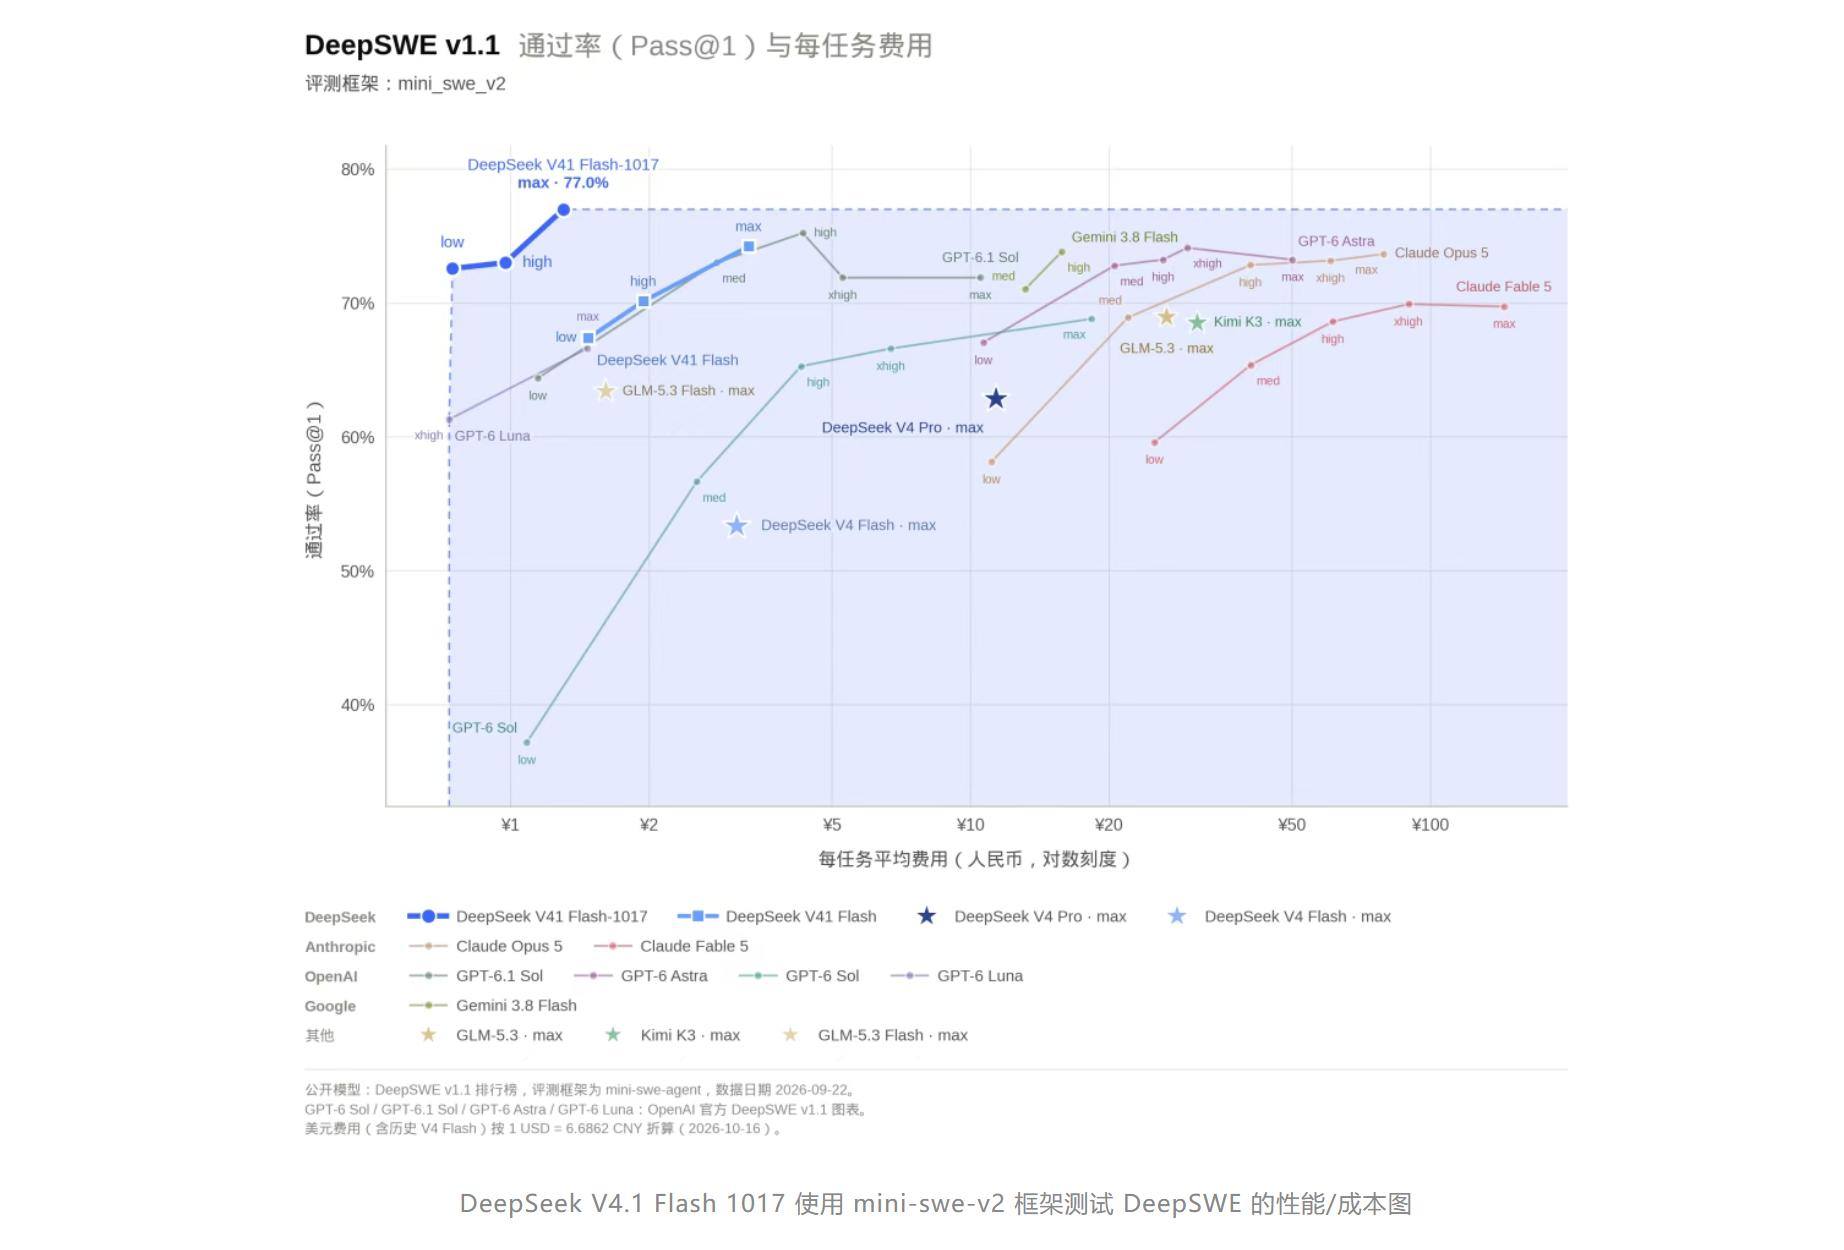
从官方公布的 DeepSWE 测试来看,V4.1-Flash-1017 已经在多个 Agent 框架下,把性能与成本的边界再次向外推了一截。
尤其是 DeepSeek Harness、腾讯 CodeBuddy 和 WorkBuddy,此次均获得了专项优化。
目前若想完整体验这套新能力,DeepSeek Harness 需要升级至 0.2.1-rc.1 及以上版本。
“许愿式编程一键成真”
当然,基准跑分再亮眼,也不如直接看它实际能做些什么。
DeepSeek 这次给 V4.1-Flash-1017 准备的新招式,名字也非常贴合网友的直觉——
“许愿式编程”。
具体是怎样的许愿法?
以往开发一个完整项目,往往需要把功能、架构、交互和技术栈逐一拆解细化后再讲给模型听。
现在用户只需说清楚自身诉求,后续的架构规划、代码编写、运行调试、测试检查以及优化修改,模型全都能自主承接并向下推进。
背后的核心支撑,是一套基于自反馈的强化学习训练技术。
模型写完第一版代码后并不会立刻“交差”,而是会主动检查生成的内容,发现异常便自行回头修复。
基于这套方法实现的效果究竟如何?
官方开局就带来了一个大制作——直接用代码构建故宫。

D 老师仅通过代码就搭建出了一套支持实时浏览与切换视角的 3D 场景。
当别人还在使用 Vibe Coding 写 Todo List 时,D 老师已经开始“Vibe 建造故宫”了。
随后的展示案例同样亮眼:
包括可以直接启动运行的网页版赛车游戏、能够真实交互的 Godot 版《传送门 2》复刻,以及一套横跨史前到现代的动态 3D 世界演示。
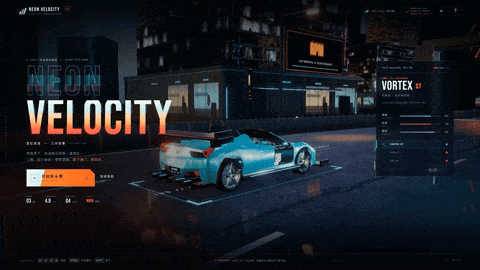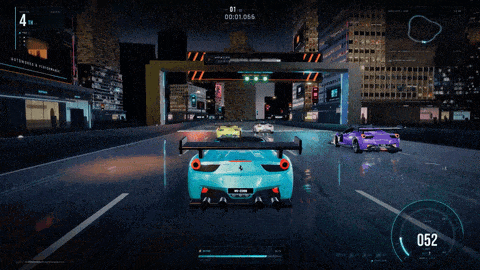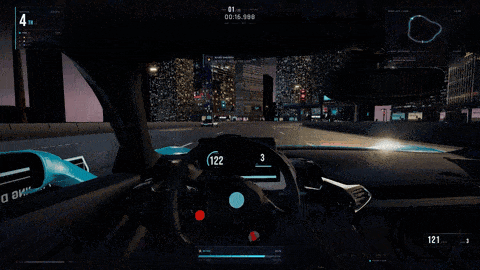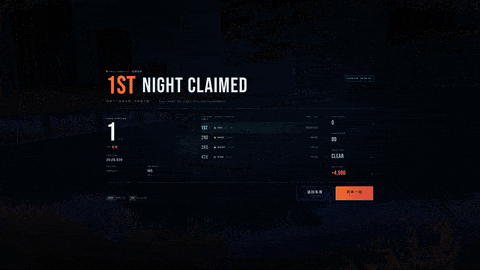

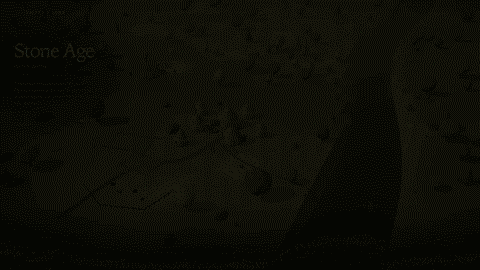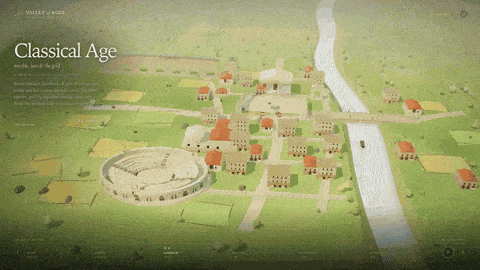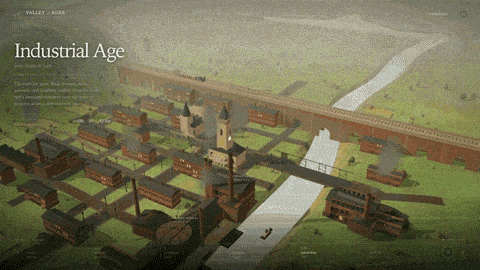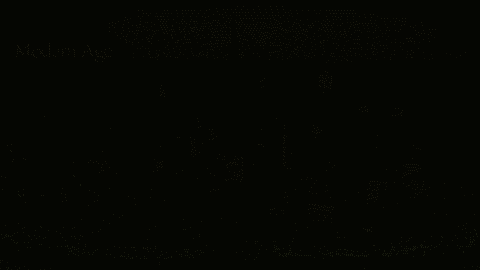
从一句简单的 Prompt,到一个可看、可动、可交互的完整项目落地,“许愿式编程”在这一代模型上确实成了真。
模型发布前疑似泄露,“更聪明,也更简洁了”
事实上,DeepSeek-V4.1-Flash-1017 在发布前就已经有了不少风声。
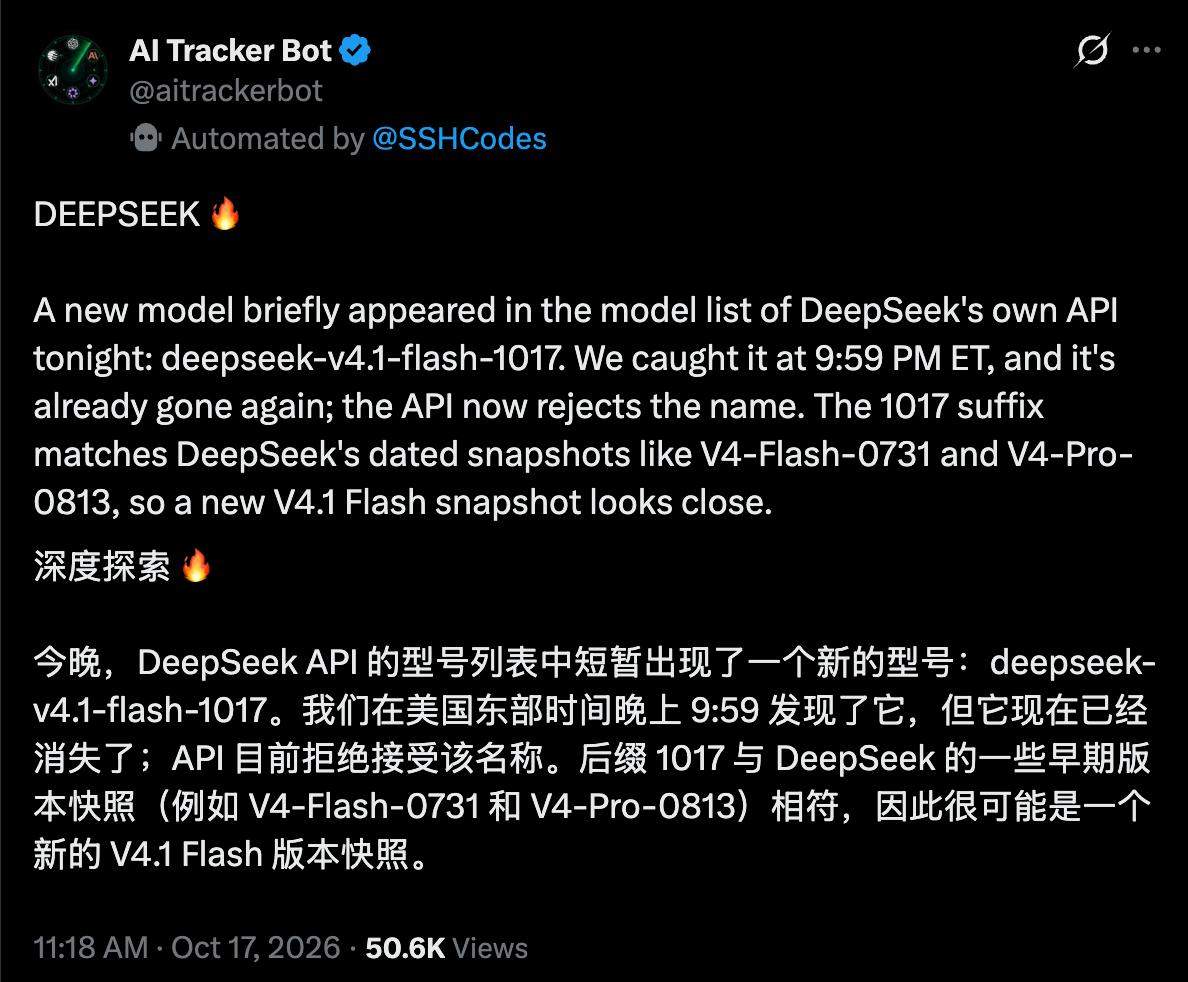
发布前数小时,就有眼尖的网友注意到,DeepSeek 的模型列表中曾短暂出现过“DeepSeek V4.1 Flash-1017”的身影。
尽管该选项很快被隐藏,但仍被守候更新的用户截获。
名称中的“1017”正好对应 10 月 17 日,符合 DeepSeek 使用日期标记模型快照的一贯命名规则。
随后,另一处证据也浮出水面。
有开发者发现,deepseek-flash 接口返回的系统指纹已从 aeb56401ca74e127821c4f9126dcb669 变更为 e72d3c7f663d3e1383b00b3884cb4501。
系统指纹发生变动,通常表明后台服务的模型版本或底层部署配置已完成更新。
而综合多方的一线实测体验,目前的普遍反馈是:
新模型显得更聪明、响应更迅速,且输出内容更为精炼。
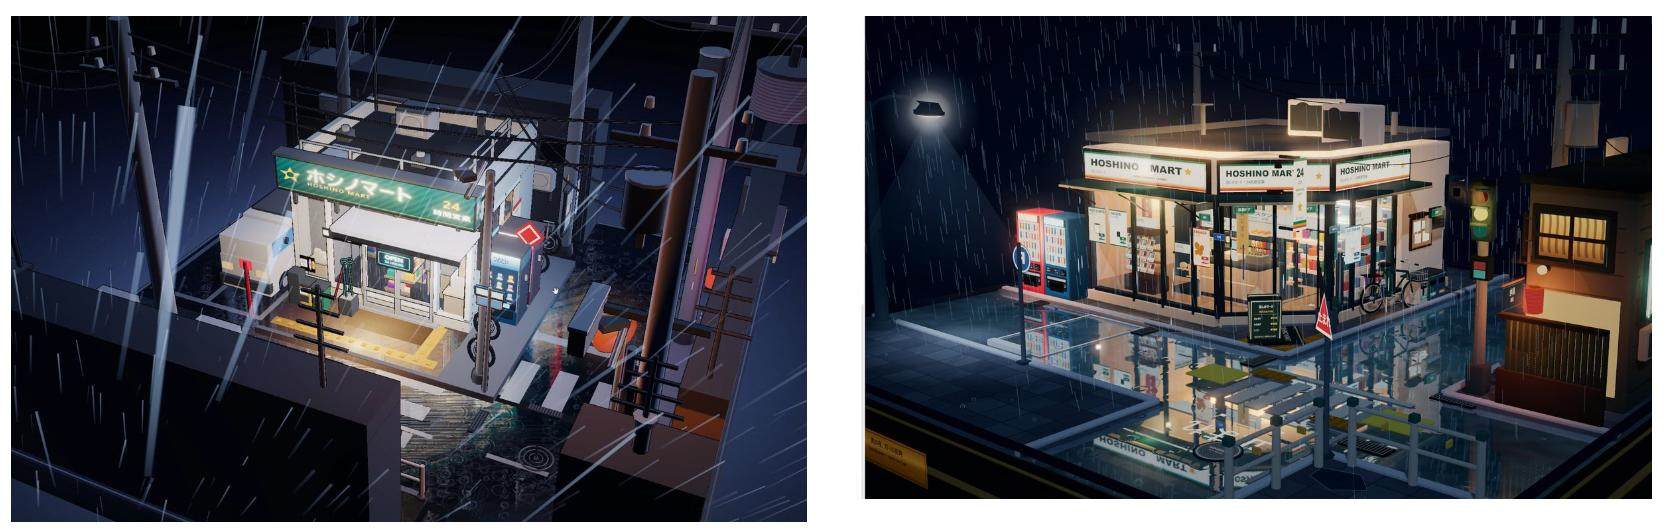
博主 Chetaslua 发现,右侧新版本生成的画面细节更为丰富,光影表现也明显更加逼真。
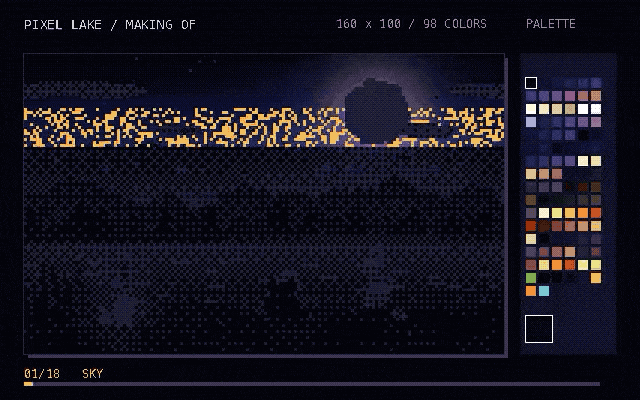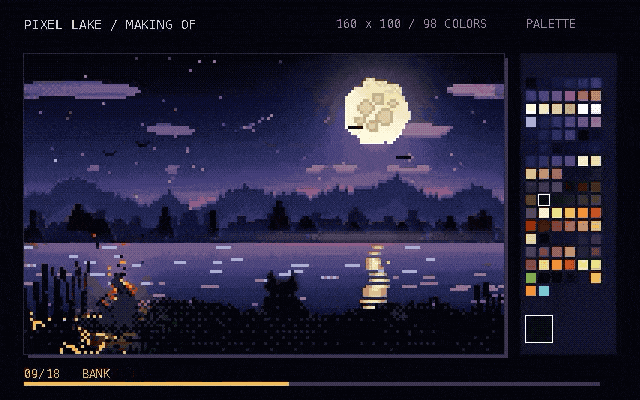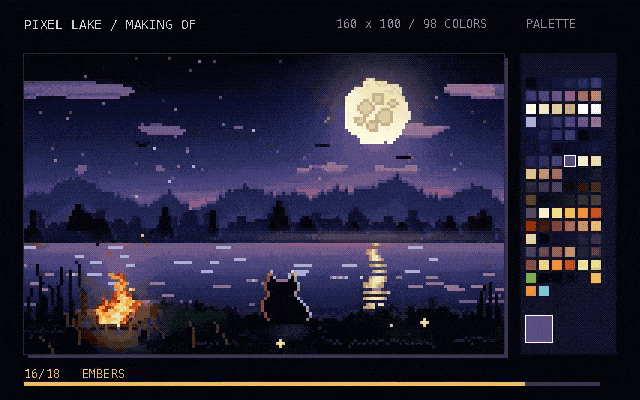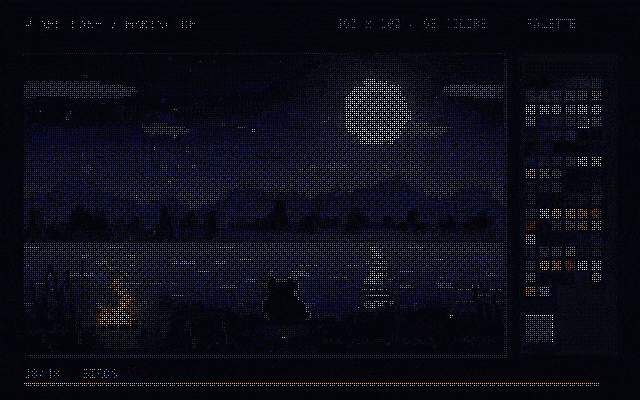
单句提示词生成的效果同样出色,并且附带了完整的创作过程解析。原作者评价称,整体体验比 Gemini 4 Argon 更加流畅。
从更多的多模态评测结果来看,新模型显著强化了 3D 内容生成能力。
博主 Hakm 公布的几组生成案例表现十分亮眼,呈现出了与 GPT-6 Astra 发布时相似的视觉冲击力。

他还顺便借助模型生成了一款经典的第一人称射击游戏,完成度颇高。
自研搜索 API 同步开放
除了模型升级外,DeepSeek 这次还将 Agent 联网检索的核心工具一同推向了市场。
DeepSeek 自研搜索引擎正式开放 Search 与 Fetch 两个 API 接口:前者用于检索相关网页,后者则专注于提取网页正文。
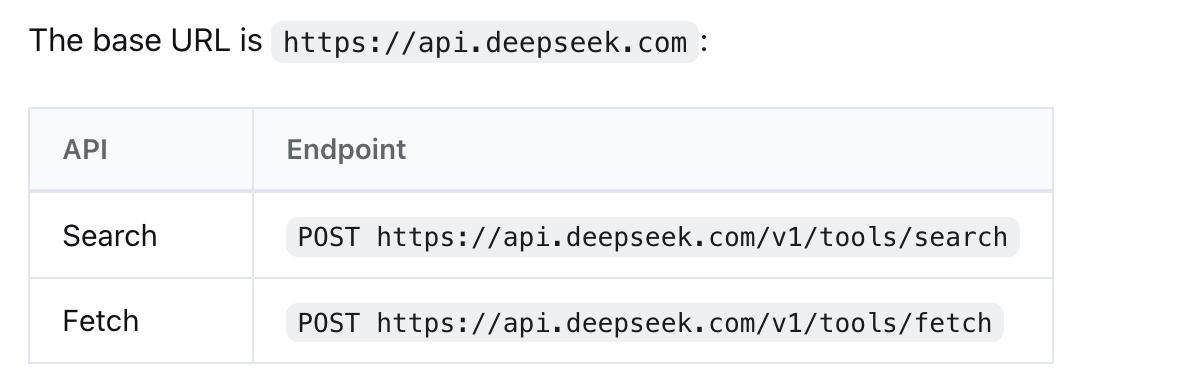
开发者可以先驱动 Agent 根据关键词检索资料,再将选中的目标网页抓取并解析为 Markdown 纯文本,交由大模型进一步分析。
其中,Search API 还支持限定指定站点、语言及发布时间范围,在检索时效性内容时可以有效提升精度。
该接口的计费方式按照成功请求次数独立结算:
价格方面极具竞争力,每千次成功请求仅需 5 元,单次调用成本仅合半分钱;若请求失败、检索无结果或遭遇超时,均不计费。
目前,用户已可在 DeepSeek Harness、Claude Code 或 Codex 中调用 DeepSeek API 来体验该功能,且限时免费开放至 11 月 1 日。
高性价比标签依旧稳固,DeepSeek 再次展现了极强的产品迭代节奏。
HuggingFace: https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash-1017
ModelScope: https://modelscope.cn/models/deepseek-ai/DeepSeek-V4.1-Flash-1017
参考链接: [1] https://mp.weixin.qq.com/s/X-5kbBkedQ5Oct9byUunag [2] https://x.com/aitrackerbot/status/2111295736411300047 [3] https://x.com/yugen_matuni/status/2111336985554227345 [4] https://x.com/hakmgpt/status/2111314470433947988 [5] https://x.com/hakmgpt/status/2111314427416895798 [6] https://api-docs.deepseek.com/guides/search/