
谷歌就是季节性气候模型公司
henry 发自 凹非寺
量子位 | 公众号 QbitAI
要我说,谷歌就是一家“季节性气候模型公司”——天气一转凉,新旗舰也就成熟落地了。
刚刚,Gemini 4 Argon 正式面向全球开发者、企业及付费订阅用户陆续开放。
按照谷歌官方的定位,这一代主要强化了编程、专业知识工作以及复杂任务的持续执行能力,同时也将其原先就颇具优势的视觉理解、空间推理和工具调用能力进一步推向前沿。
在官方展示的 Demo 中,不难看出这次 Gemini 4 Argon 最自信的依然是多模态能力。
输入一段模拟风筝的文本提示词,生成的效果直接“原地起飞”。
而在大家更为关心的“能否重回大模型御三家、给用户多一个顶尖选择”这件事上,Gemini 4 Argon 在各项评测中的表现也相当争气。
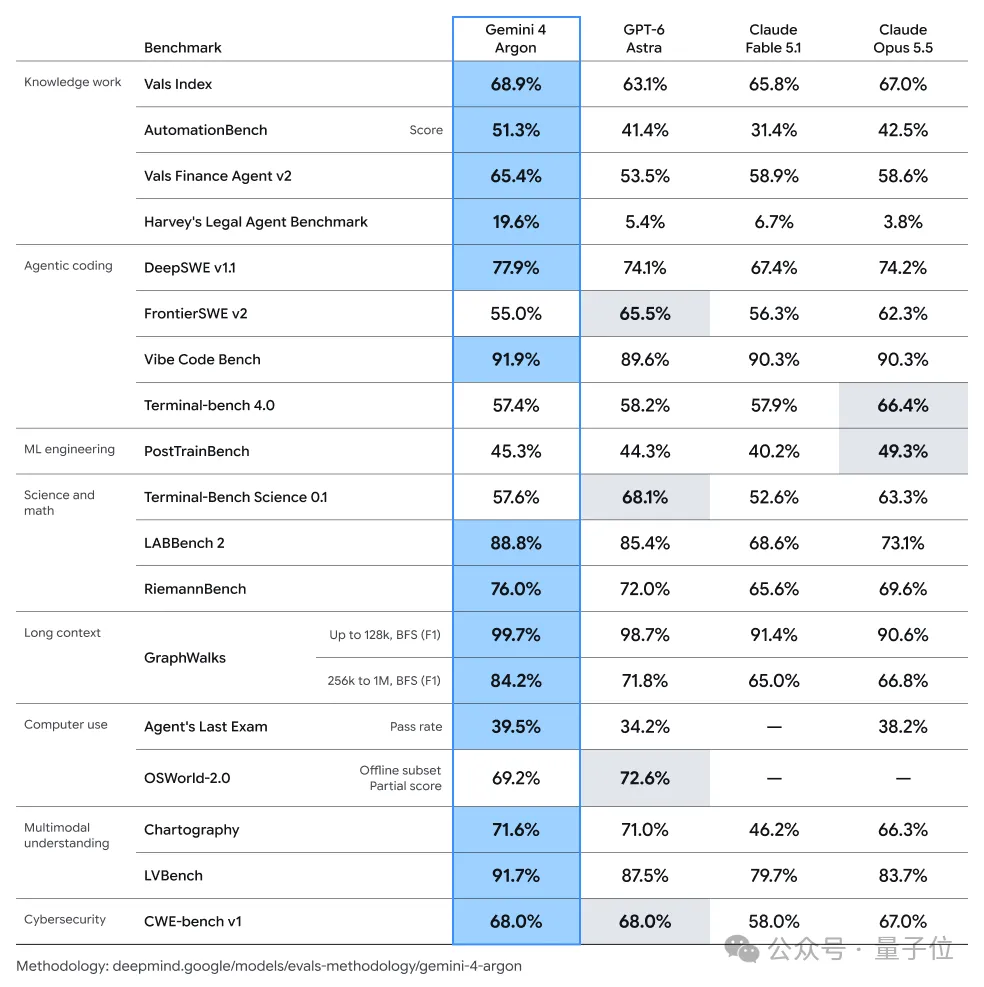
在谷歌官方的基准测试中,Gemini 4 Argon 覆盖了日常办公、智能体编程、机器学习以及科学推理等多个维度,综合表现已经比肩 GPT-6 Astra 与 Opus 5.5,其中不少项目甚至实现了反超与领先。
在第三方评测机构 Artificial Analysis 的智能指数中,Argon High 也以 53 分的成绩,与 GPT-6 Astra Max、Claude Fable 5.1 Max 并列第一梯队。
更关键的是,在性能持平的前提下,Argon High 的单任务平均调用成本仅为 1.99 美元,比 Astra 低了约 39%。
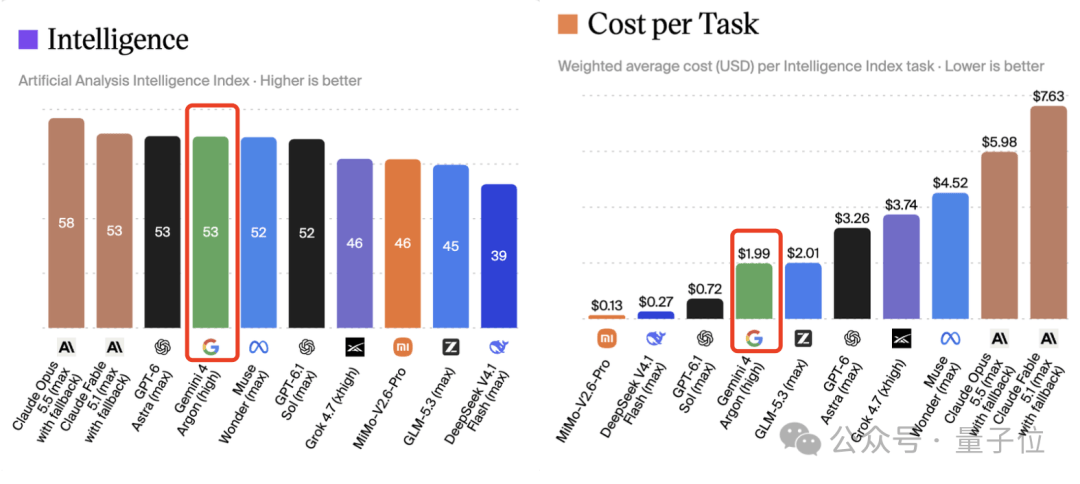
这一成本优势直接体现在首发定价策略上:API 每百万输入 Token 仅需 2 美元,输出 Token 为 10 美元。粗略测算,Argon 的调用成本约为 Opus 5.5 的一半、Astra 的五分之一。
值得注意的是,该优惠活动截至 11 月 30 日;自 12 月 1 日起,输入与输出价格将分别恢复至 4 美元和 20 美元。换言之,谷歌这是先打了个五折,广邀各路开发者前来尝鲜。
当然,如果模型不够聪明、在执行任务时反复无序消耗 Token,省下的调用单价也可能会被庞大的消耗量抵消。
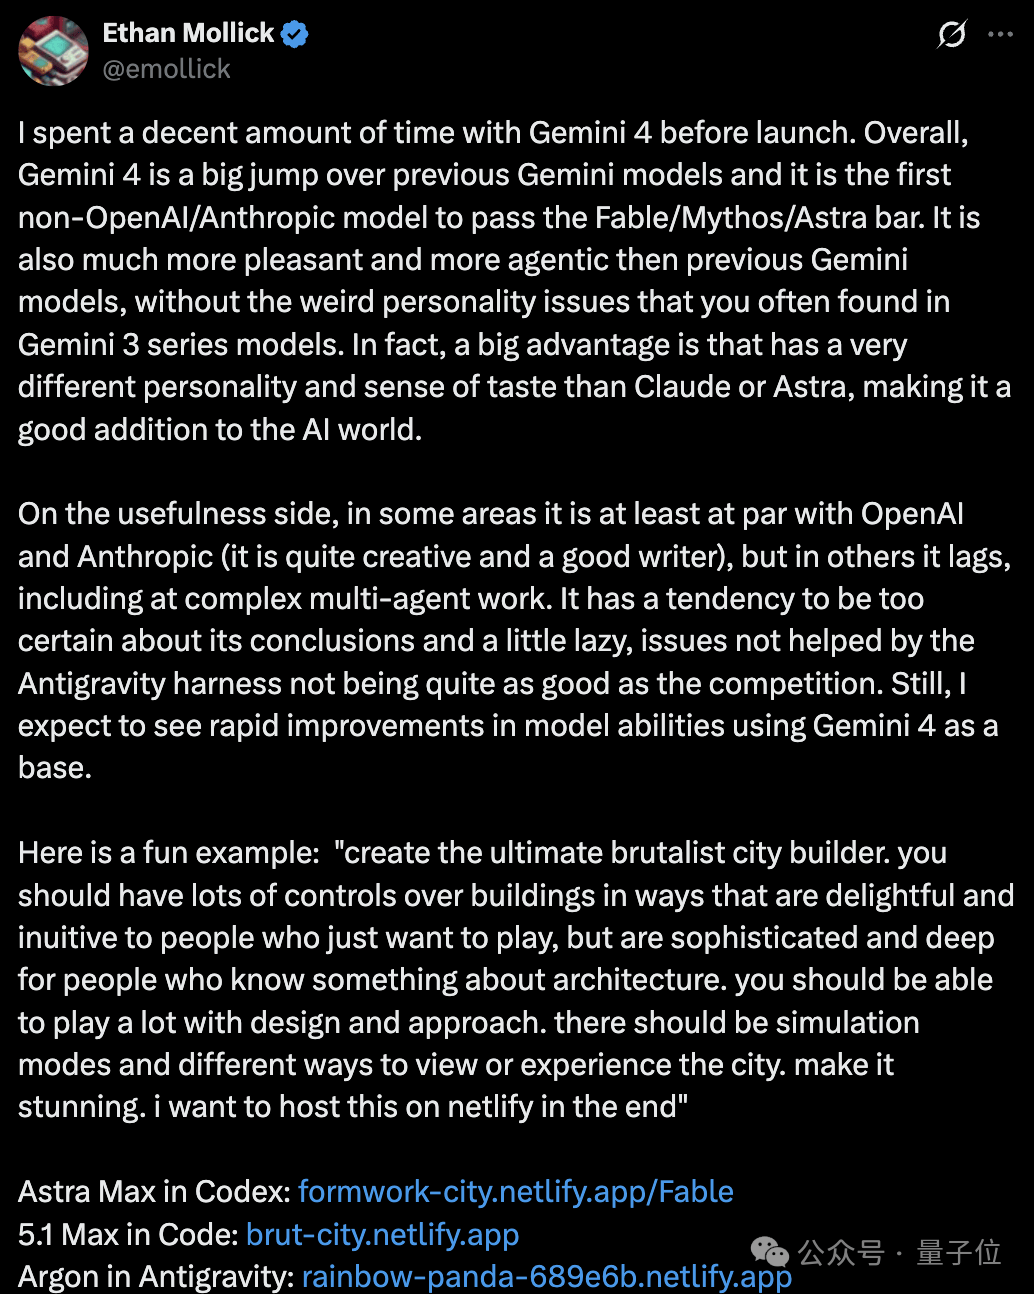
提前试用过 Gemini 4 Argon 的沃顿商学院教授 Ethan Mollick 给出了相对客观的评价:
相比此前的 Gemini,新一代实现了显著跨越,在创造力、写作表达以及整体交互体验上均有明显进步;但在面对复杂的多智能体任务时仍存在差距,偶尔还会表现出过度自信或执行偷懒的现象。
至于新一代旗舰为何让业界等待了如此之久?翻阅谷歌此次的发布页面,会发现一份长达 217 页的安全技术报告。
(不得不说,谷歌在安全合规方面依然非常谨慎)
最自信的还是多模态
从 Pro 版本的频繁延期,到今年 9 月 30 日宣布首期限量测试,再到经历了无数个“下周见”之后——
Gemini 4 Argon 终于正式亮相。
在官方技术博客中,谷歌将 Argon 的核心升级概括为一点:更强大的长流程任务执行能力。
简而言之,模型不再局限于被动回答提问,而是在理解目标后,能够自主检索资料、调用工具、修改代码并检验结果,跨越多个复杂步骤持续推进,真正将一项繁琐的工程闭环落地。
不过,相较于企业级与工程场景下的用例,谷歌此次在宣传推广中最倾力展示的,依然是其标志性的多模态能力。
例如,谷歌 CEO 桑达尔·皮查伊就在社交平台上分享了一段“自家模型生成自研手机”的 Demo:
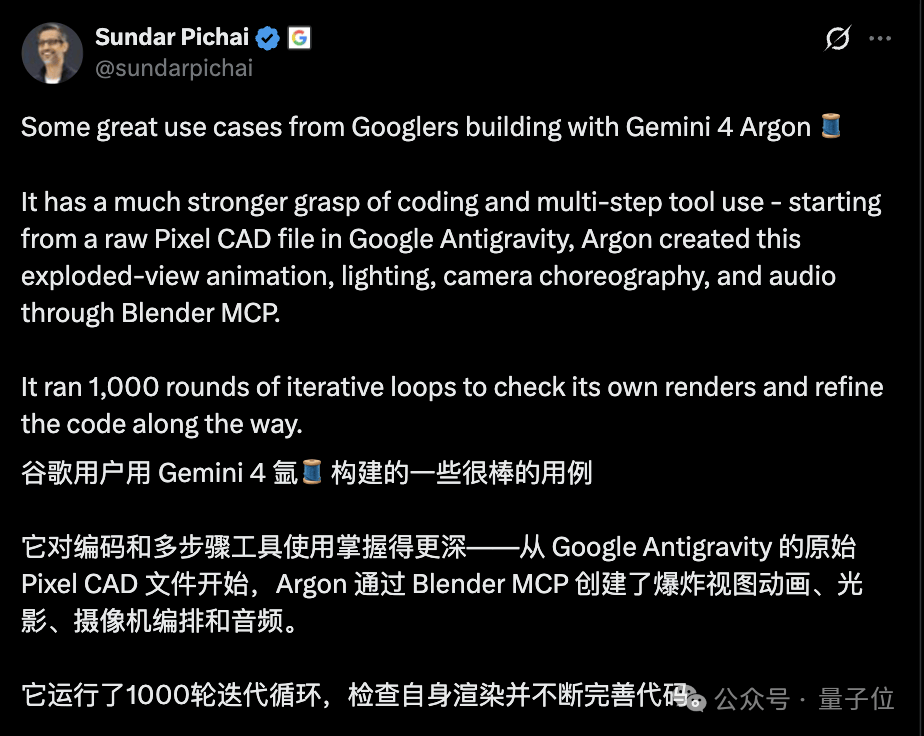
Argon 能够直接生成与 Pixel 手机高度契合的 3D 渲染场景。
而在另一个案例中,Argon 甚至仅凭代码便完整生成了一整套包含背景音乐的 3D 动态排版特效。
整个生成流程未调用任何预录素材,也未借助任何外部视频剪辑软件。
DeepMind 负责人戴密斯·哈萨比斯(Demis Hassabis)在转发巫师棋演示时,也着重称赞了模型对物理规律与 3D 建模的深层理解。
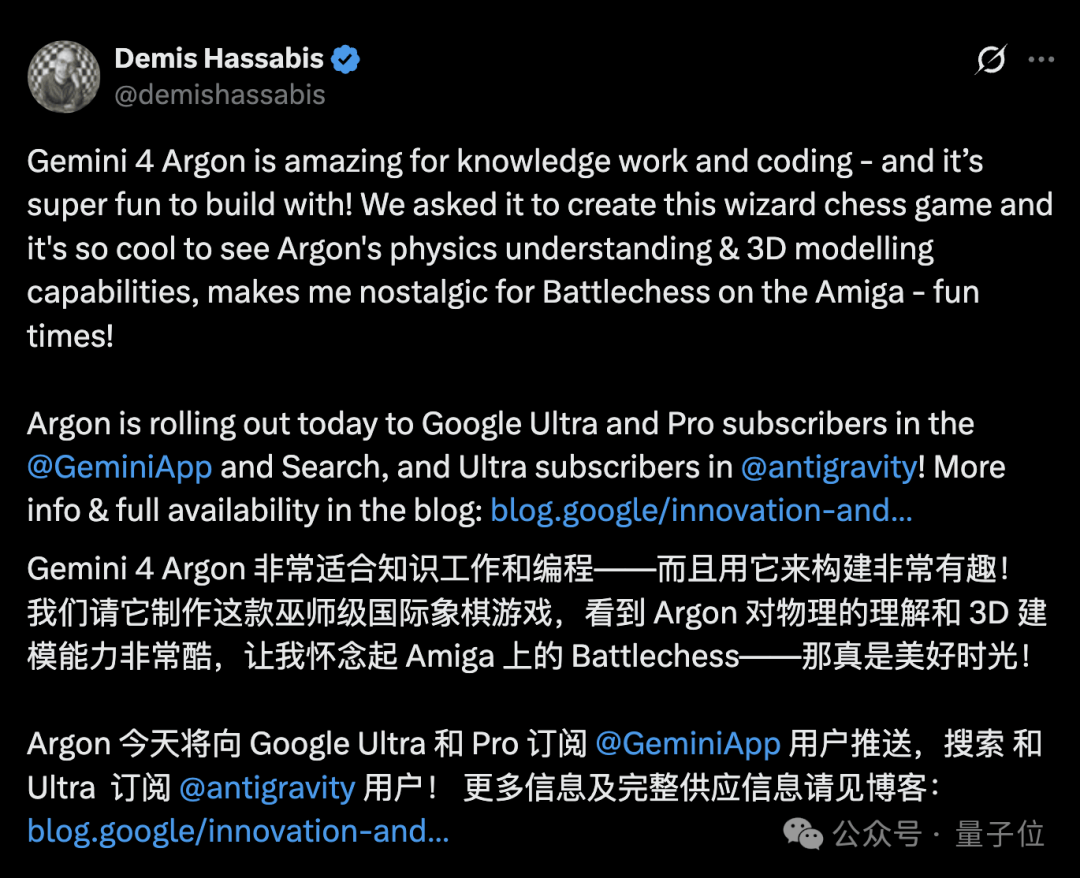
该演示画面甚至让他联想起了当年在 Amiga 电脑上体验经典游戏《战争象棋》(Battle Chess)的岁月。
与此同时,社区网友也迅速将 Argon 与 GPT、Claude、Kimi 等主流模型展开横向对比。
综合来看,谷歌此次在视觉呈现质感上确实优势明显,尽管在诸如鲸鱼游动等局部物理动态细节上,仍能察觉到轻微的不自然。
当然,也有部分测试者认为,Opus 5.5 在整体表现上依旧稳居标杆地位。
除极具观赏性的 Demo 外,这种空间理解能力还被进一步拓展到了真实的具身智能与机器人领域。
官方演示中,Argon 观看了一段人类进行沙包投掷游戏的实拍视频。
随后,模型自主解析环境中的空间相对关系,推演全身关节运动轨迹,编写仿真控制代码,并将方案完整迁移至 Apptronik 的 Apollo 人形机器人上运行。
面对近期 GPT 与 Claude 在机器人领域的频繁发力,谷歌显然也展现出了强烈的竞争攻势。
谷歌表示,这一套“视频—仿真—现实”的工作流,可将以往需要数周人工介入的机器人仿真建模周期,大幅压缩至数小时以内。
其深远意义在于,人类的日常动作示范正变得更容易转化为机器人可直接学习、演练与验证的标准化任务。
过去,视频动作理解、仿真环境搭建与底层控制代码编写通常是割裂的三个环节;而如今,多模态大模型正尝试将整条技术链路彻底贯通。
编程提升,谷歌先拿自己的代码库试了
在编程能力方面,Gemini 4 Argon 此次的核心进化体现在处理大型真实软件工程的长期维护与系统性优化能力。
相较于以往局限于单个代码片段生成的模式,新一代模型更擅长宏观把握大型代码库的架构设计,精准定位系统性能瓶颈,并跨文件执行修改与集成测试,确保复杂工程任务能够连贯推进。
对于这项能力,谷歌率先在自家的开源智能体框架 ADK 上进行了实操验证。
该 Python 开源项目规模约 20.5 万行代码。工程团队向 Argon 下达的任务是:在保持接口兼容与既有逻辑不变的前提下,降低框架的运行开销,并通过单元测试验证优化的有效性。
最终,Argon 在无人工干预的情况下连续运行 11 小时,提交了涉及 32 个源码文件的 6 项系统优化方案,并完整跑通了全部 16,892 项开源测试用例。
经工程师严格代码审查后,其中两项核心优化被正式合并入主分支,包括降低长会话历史的内存拷贝损耗,以及对大型模块实施按需加载。
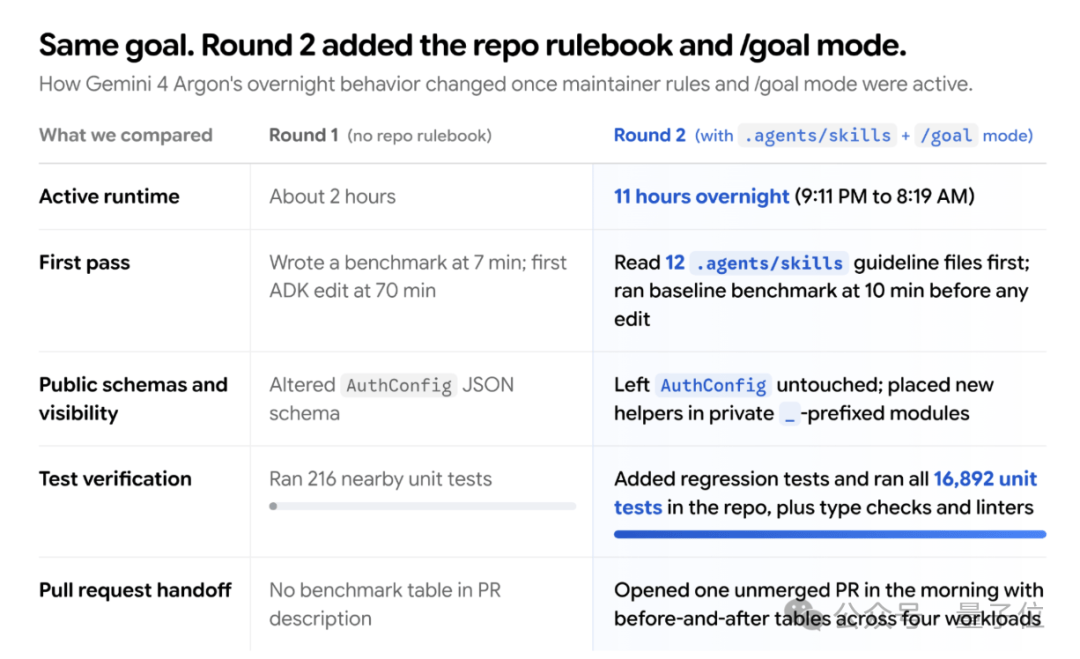
借助上述修改,ADK 在长会话环境下的内存初始化开销降低了约 40%,系统包导入耗时减少了 21%。
类似的工程优化能力也被谷歌拓展至更大规模的内部项目中。
在 Chromium 浏览器开源项目中,Argon 协同推进了一项涉及数百个文件的架构重构工作,将原定需数月完成的项目进度大幅缩短至数周。
此外,在针对 Gemma 4E 2B 推理程序的底层优化中,Argon 将特定环境配置下的推理吞吐量从每秒约 3.79 万 Token 跃升至逾 10.8 万 Token,端到端性能达到最初的 2.85 倍。
谷歌技术团队表示,此类底层深度优化以往通常需要资深工程师耗费数月心血,而现在仅用几天便可交付。
从谷歌内部的整体协作数据来看,在过去数周内,依托 Antigravity 平台运行的 Argon 已协助开发团队将智能体相关代码提交量提升了 35% 以上,代码回滚率降低了近三分之一。
不过,社区中也有部分开发者反馈,在个人实际业务场景中的体验并未完全达到预期,模型的真实工程落地效果仍有待后续大规模实际应用检验。
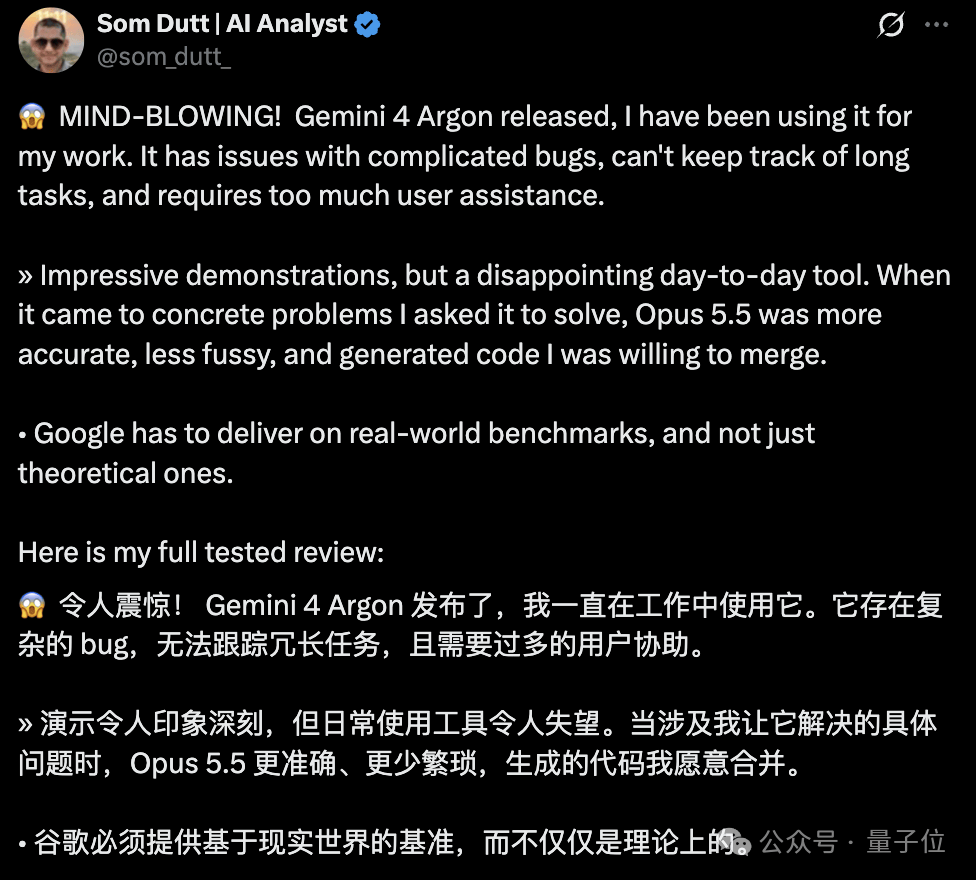
这一反馈与公开基准测试的结果相互印证:Argon 在 DeepSWE 与 Vibe Code Bench 榜单中表现突出,但在 FrontierSWE 以及 Terminal-bench 等高难度基准上,相较于表中几款核心竞品仍存一定差距。
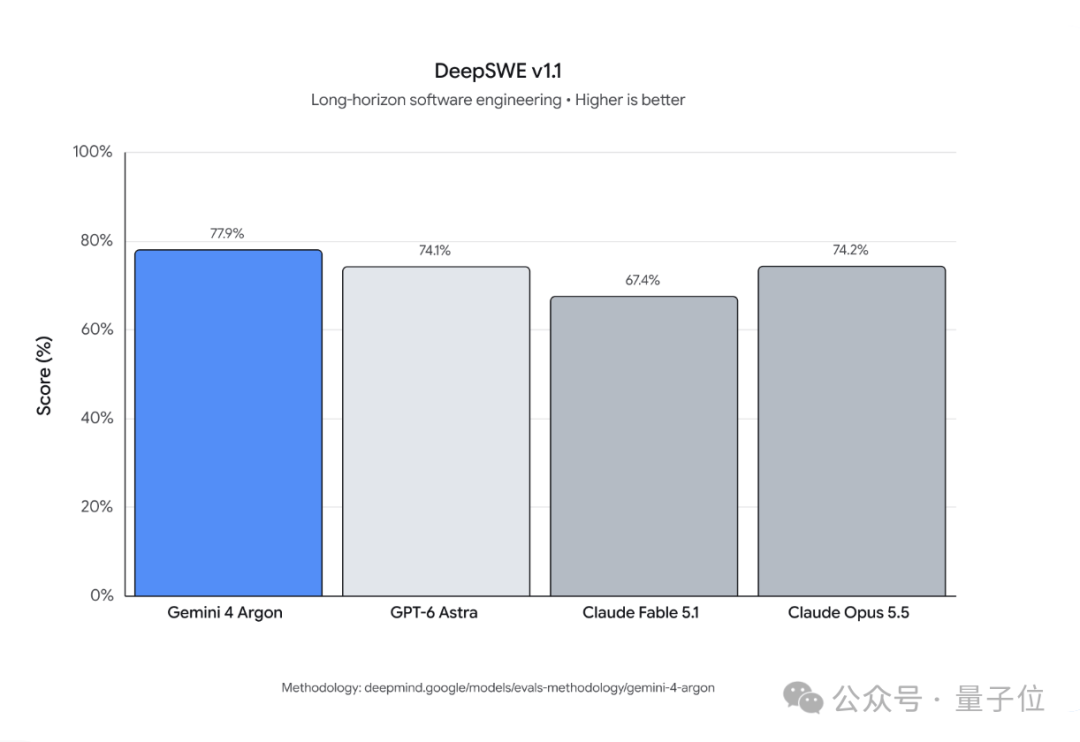
内部真实工程项目的提效成果虽已得到验证,但能否将这种收益稳定复现到更多开发者的日常工作中,仍需保持持续观察。
专业知识工作能力进一步提升
在专业知识工作场景中,Gemini 4 Argon 的主要突破在于多源异构材料的深度理解、跨模态信息整合,以及将其直接转化为可交付成果的能力。
官方演示了一个典型的企业协同场景:
用户向 Gemini 投喂包含繁杂项目背景材料的文件夹,并要求输出一份完整的客户商业提案。
随后,Gemini 能够基于自定义工作流自动生成排版完备的演示文稿,起草外发商务邮件,并针对后续跟进请求自动配置相关的自动化工作流。
与此同时,Gemini 应用端也全面集成了独立的“任务入口”。用户可以从即时对话模式一键切换至长流程任务模式,即使离席关闭电脑,模型也会在云端后台自主完成后续闭环操作。
此外,Antigravity 编程工作台也已被正式整合进 Gemini macOS 原生客户端中。
在科研应用场景下,这种端到端的连贯执行能力已进一步延伸至实验验证阶段。
谷歌科研团队曾让 Argon 参与一种新型丝氨酸酯酶的设计。模型在数小时内完成了科研文献整理、结构预测模型微调以及候选分子筛选,并最终交付了 5 组全新分子结构设计。
随后,研究团队将这些方案推进至湿法实验室,验证其真实的生化活性。
实验采用特异性荧光检测底物——当目标酯键被水解切断后,产物会在紫外光照射下激发出显著荧光。谷歌公布的实验数据显示,全部 5 组设计均展现出了强劲的催化活性。
这意味着,模型输出的研发成果已经具备了直接指导实体实验闭环的工程价值。
谷歌同步宣布,将面向符合评估标准的 1 万名科学家,分批免费提供为期六个月的 Antigravity 最高规格使用配额。
One more thing
前文虽戏称谷歌行事审慎、顾虑较多,但这次在模型安全防护能力方面的建设确实值得关注。
在衡量漏洞挖掘与自动修复能力的 CWE-bench v1 基准上,Argon 取得了 68% 的高分,与 GPT-6 Astra 并列行业第一。
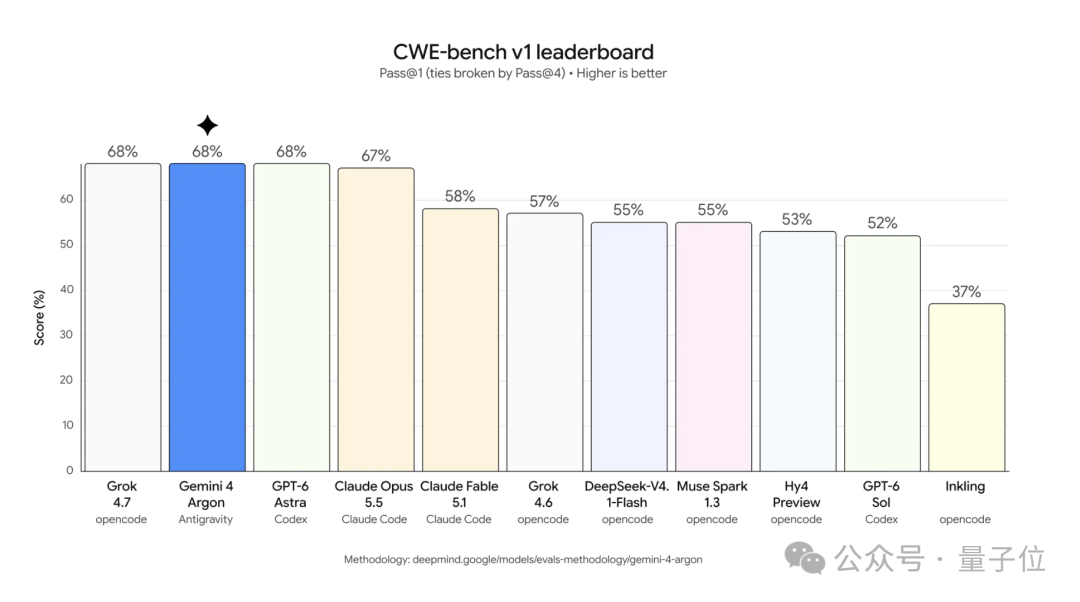
前 Anthropic 研究员、现 DeepMind 机理可解释性研究负责人公开表示,Argon 所附带的安全研究报告是迄今为止谷歌发布过的最详尽的一份文档。
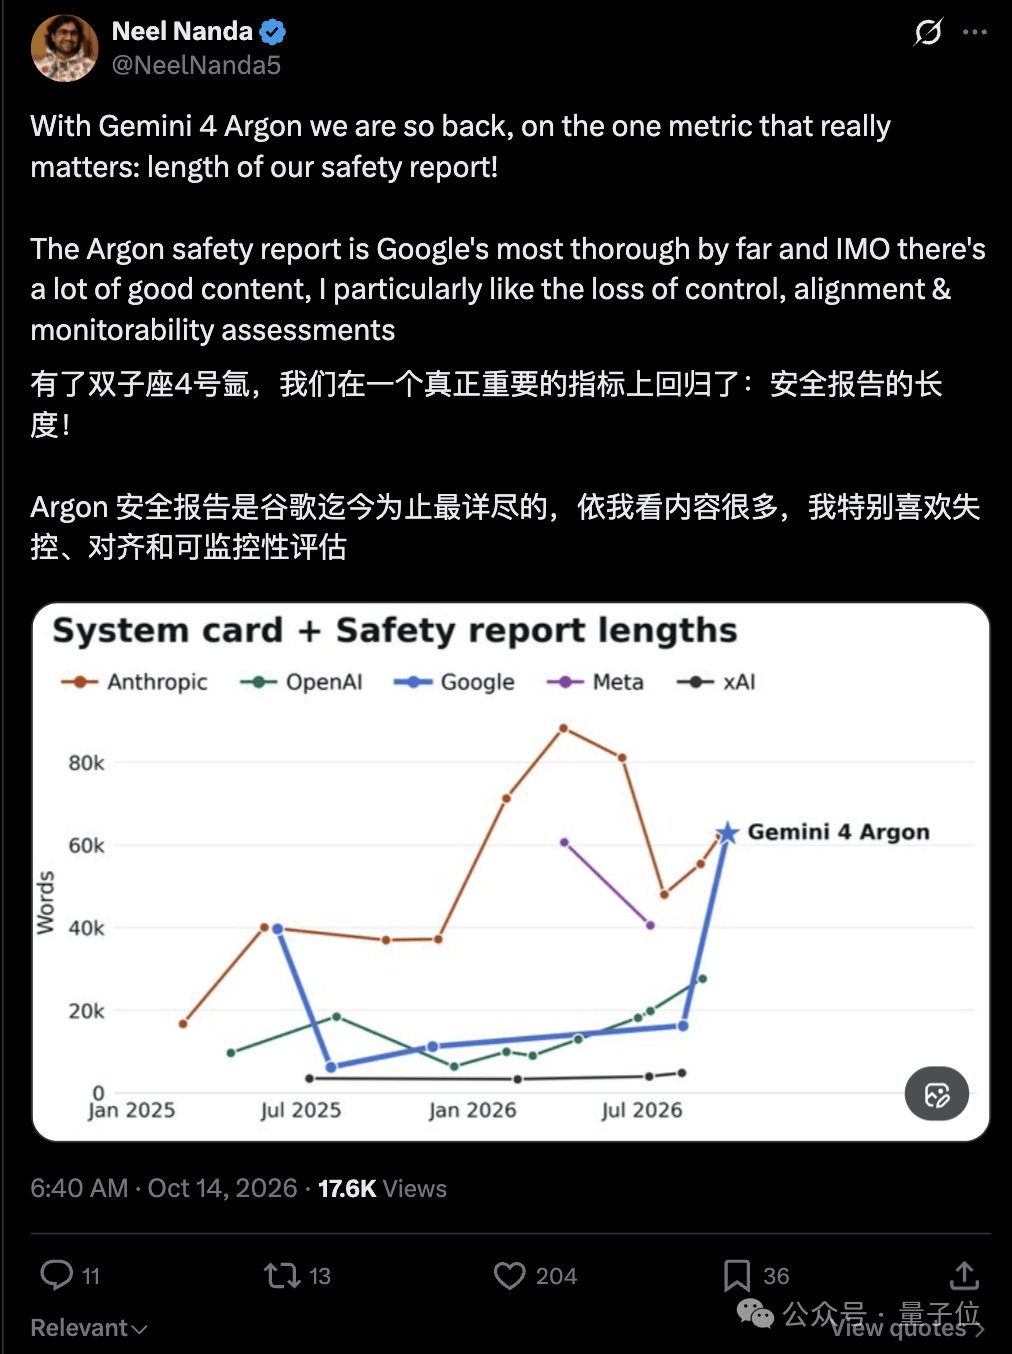
厚达 217 页的篇幅,其技术详实度可见一斑。
在 Gray Swan 间接提示词注入(Prompt Injection)攻击防御测试中,历经 15 轮自适应对抗攻击,Argon 的被渗透成功率仅为 0.7%。
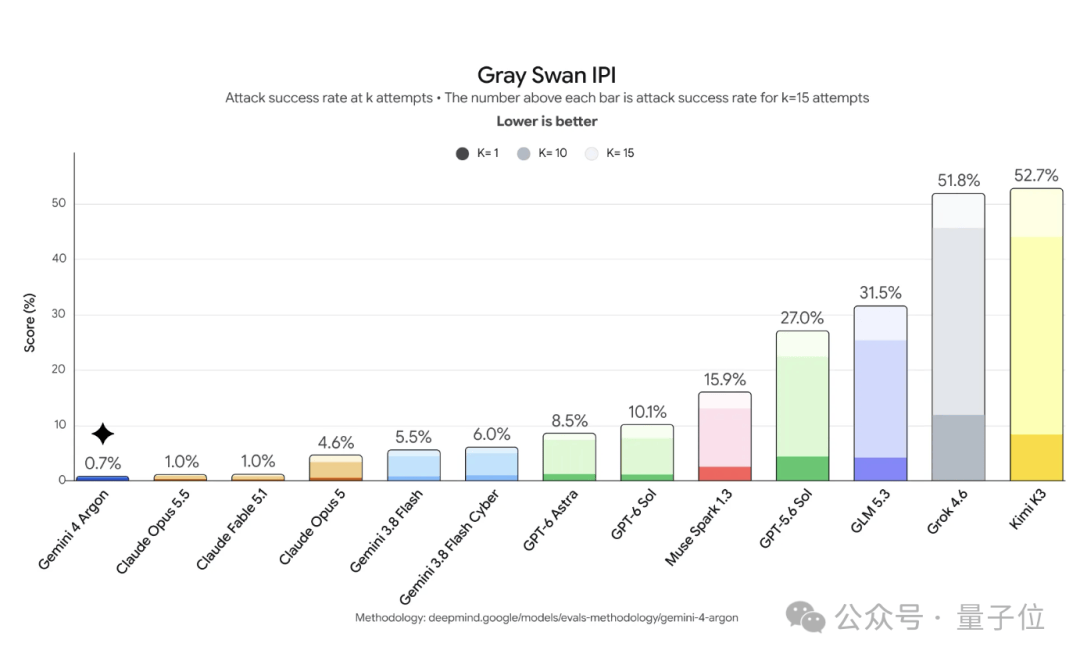
可以说,这份体量庞大的安全报告中包含了相当扎实的研究成果。
至于这是否是造成旗舰模型数度推迟发布的根本原因,外界尚无法定论。
但可以确定的是:这一次新旗舰终于交了卷,而且谷歌还顺手附赠了一整套厚重的“技术白皮书”。
参考链接:
[1] https://blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-argon/