Muse Spark Open 的一个版本于今日发布,兑现了他们最初的承诺,但该模型的性能弱于他们的 Spark 1.3。特斯拉 Roadster 的演示也同样值得一看——虽然严格来说不属于 AI 领域,但没有什么比现实生活中的“飞行汽车”更酷的了。
今天我们的头条是一篇关于可解释性与对齐(interpretability and alignment)的罕见深度报道。我们上一次与 Goodfire 交流是在 2 月:
首个机制可解释性前沿实验室 —— Goodfire AI 的 Myra Deng 与 Mark Bissell 从 Palantir 和 Two Sigma,到将 Goodfire 打造为可落地机制可解释性(mechanistic interpretability)的标杆,技术团队成员 Mark Bissell 与产品负责人 Myra Deng 正在尝试……
以及去年与 Anthropic 探讨的可解释性方法的“苦涩教训”规模化扩展:
可解释性的效用 —— Emmanuel Amiesen,Anthropic 感谢大家参加 AIE —— 第 1 天和第 2 天的完整直播回放现已上线,另有 6 个其他直播分会场。你可以在这个周末一网打尽!等我们补个觉后会带来更详尽的总结。
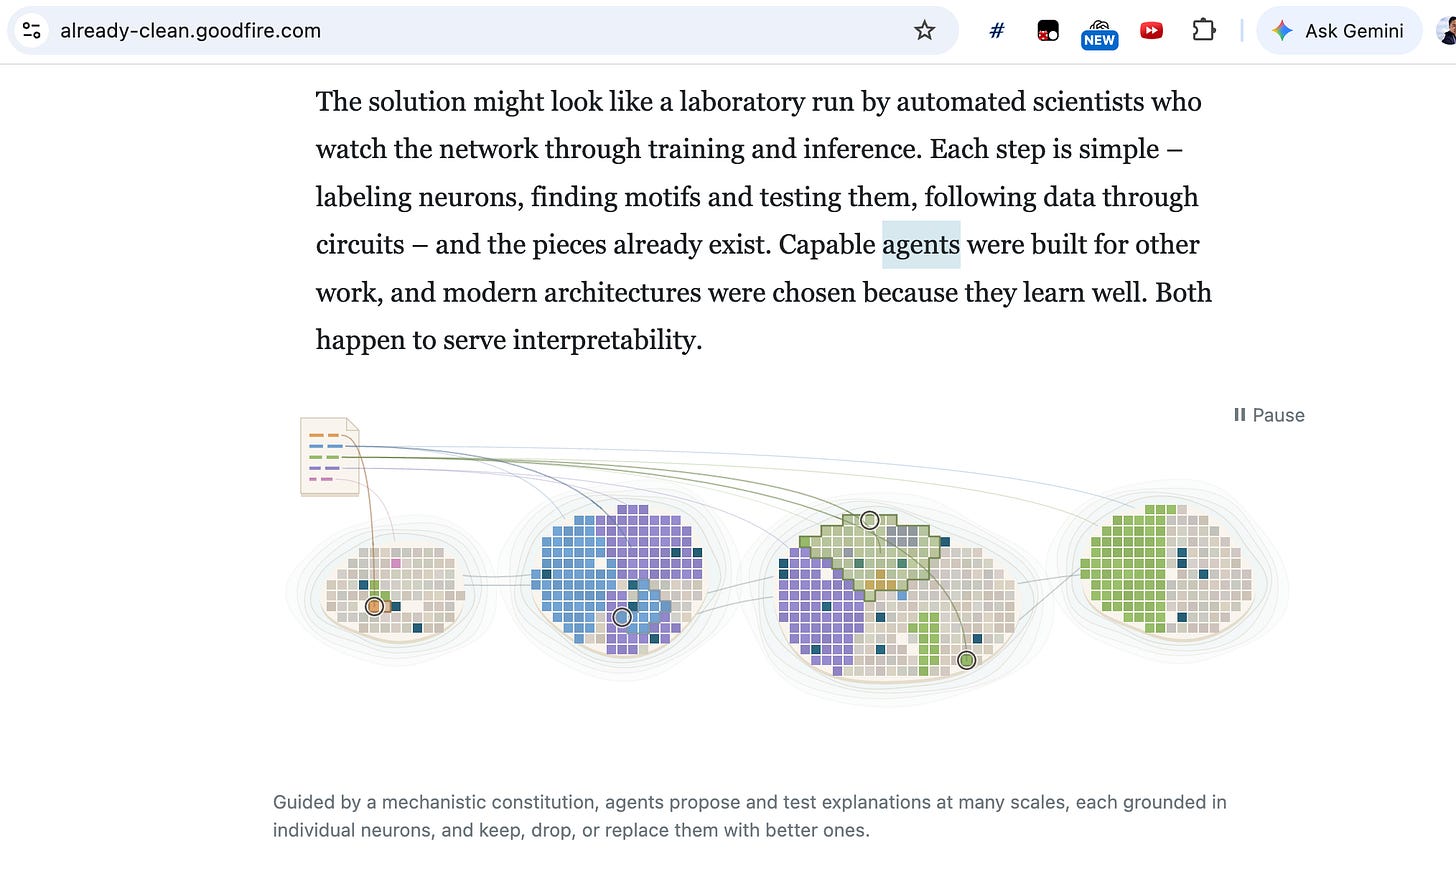
现在,Goodfire 的 Nick Cammarata 发表了一篇重要长文,阐述了他的核心假说:“神经网络本身已经足够干净(Neural Networks Are Already Clean)”——文中指出,许多已知的多义性(polysemanticity)和叠加(superposition)案例(这些现象会导致抗拒人类解释的盘根错节的权重“乱结”),在进一步的智能体分析(agentic analysis)面前都会迎刃而解: