
我们最新发布的 Apertus 1.5 在 8B 和 70B 的 Apertus 1.0 模型基础上进行了扩展,增加了图像/音频理解能力、可选的思考模式(thinking mode)、长达 4 倍的上下文窗口、更强的指令遵循能力以及更好的工具使用能力。更新后的 8B 与 70B 模型权重已于 2026 年 7 月 24 日在 Apache 2.0 许可协议下发布至 Hugging Face。更多细节现已在项目的技术报告中提供,并在此进行了概述。 Apertus 1.5 是在第一代模型基础上的持续预训练(continued pretraining):为 8B 模型增加了 4 万亿(trillion)token 的文本与多模态训练数据,为 70B 模型增加了 2 万亿 token,训练数据总量分别达到 19T 和 17T。与以往的每一个 Apertus 版本一样,这些模型完全开源开放:开放权重、开放数据、开放价值观以及完整的训练细节。
主要增强特性
- 原生多模态理解: Apertus 1.5 支持除文本之外的图像与音频输入,将文档、图表和照片引入对话之中。该模型还可以处理口语语音,不过该功能目前仍处于实验阶段。
- 思考模式: 模型可切换至思考模式,在回答前先对输入进行推理,从而提升在推理问题上的表现。
- 长上下文: 上下文窗口扩展至 262,144 个 token,比 Apertus 1.0 增加了 4 倍。
- 更强的指令遵循能力: 相比 Apertus 1.0 具有更好的指令遵循度,可给出更可预测且准确的回答。
- 更佳的工具使用: 模型经过训练以实现更好的工具集成,能够更有效地调用外部工具与 API。
- 开放的价值观: 更严格地遵循《Apertus 宪章》(Apertus Charter),为模型的价值观与原则带来透明度。
训练流程
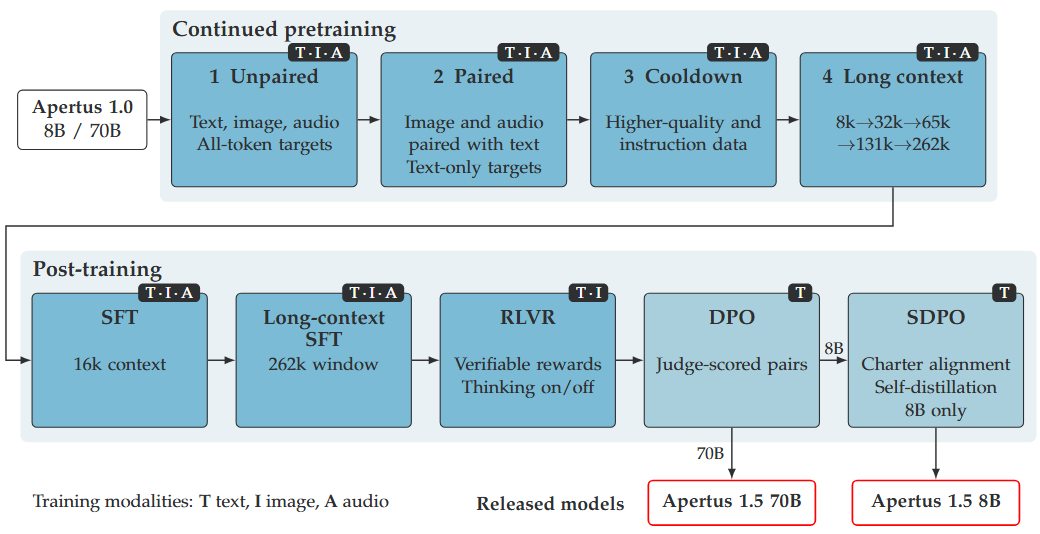 完整的 Apertus 1.5 训练流水线
通过分词器实现多模态
我们在 v1.5 模型中以早期融合(early-fusion)的方式引入多模态能力:图像和音频与文本 token 处于同一序列中,作为离散 token 输入 Apertus,而非使用独立的视觉编码器。图像使用 Emu3.5 分词器进行分词(一张 512×512 的图像