
大模型好不好用,百灵拿成品说话
又到了一年一度的双十一大促筹备期。
在电商行业打拼的打工人,状态还好吗?身边不少做电商的朋友已经直呼扛不住,天天都在发消息求助:
有没有好用的AI打工神器求推荐?急急急,最好是活干得好又能干很久的那种。
别说,最近还真有一款值得关注的生产力工具。
蚂蚁百灵新近开源推出的 Ling-3.1-flash,平时处理工作周报、选题总结等任务均能高质量承接。
实话实说,Claude Code、Codex 等工具此前大家都有接触,但在国内日常实际业务中,适配本土工作习惯的模型往往表现更顺手。
特别是百灵系列,不刻意炒作参数或刷榜,但在真实业务场景中展现出了相当扎实的执行力。
按照官方的定位,该模型聚焦的核心目标非常明确:把真实工作流里的活干完。
以电商大促复盘为例,业务主管一句**“把这次大促的情况整理出来”**,落实到执行层面,往往需要经历资料查找、数据核对、进度跟进,以及最终制作成结构化表格和汇报 PPT 等多个步骤。
业务推进往往需要跨多个环节深度协同,更棘手的是,关键数据通常分散保存在不同的文档和工具平台中。
图片源自百灵官微
Ling-3.1-flash 正是基于此类复杂业务痛点打造的高智效比专业模型。
其核心逻辑在于:回答流畅只是基础,能够切实完成端到端的任务交付才是关键。
为真实世界任务而造
要承接像大促方案分析这样多流程、长周期的琐碎工作,模型必须具备多环节持续推进的能力。理解 Ling-3.1-flash 的架构,可以从这条业务链路展开:
模型面临的首要挑战,是准确拆解交付目标。
用户给出的可能仅是一句较为简略的需求,但最终要求交付的却是一套完整规范的汇报材料。模型需要自行定位所需资料,判断信息缺口与前置依赖,并结合中间结果动态推进。
Ling-3.1-flash 的运行机制正体现了这一逻辑。
它将需求理解、任务拆解、信息整合、工具调用及结果校验串联为一体,能够跨网页、文档、数据表格与代码环境执行复杂协同。
不仅能制作 Excel 表格与汇报演示,也能同步完成代码的编写与自动化测试。
不仅如此,这套能力已有相当具体的落地形态。
Ling-3.1-flash 已经接入蚂蚁内部的桌面协同 Agent 客户端**“小虎”**:由模型主导规划与调度,配合执行环境完成底层文件读取、程序运行与结果写入。
这种落地思路具有较高的参考价值。即便普通用户暂未直接接入小虎,利用已有的办公 Agent 框架搭配 Ling-3.1-flash,同样能够构建出高效率的业务协同流。
在长程任务持续推进的过程中,上下文及历史参考资料会显著膨胀,伴随而来的往往是推理算力开销的激增。
此时,Ling-3.1-flash 采用的混合架构设计发挥了核心作用。
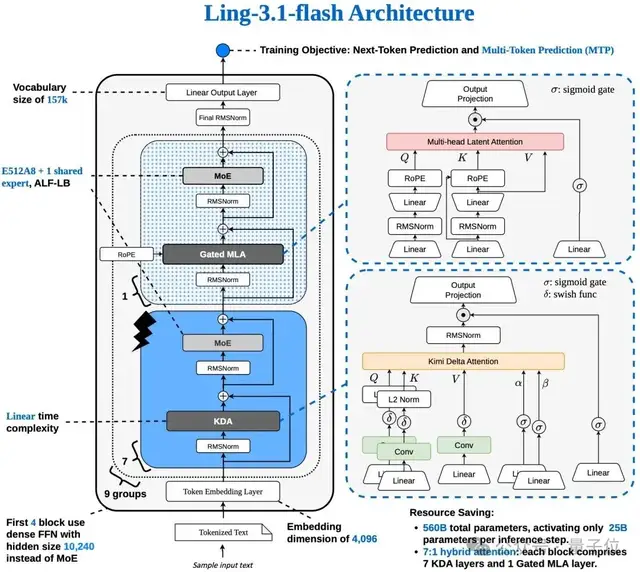
模型总参数量约为 560B,每个 Token 激活参数量约为 25B。在保障庞大知识储备的同时,Ling-3.1-flash 大幅压缩了单步推理的实际计算负载。
在注意力机制层面,它继承并优化了 Ling-3.0-flash 的结构,进一步提升了线性 Attention 的构成比例。
模型采用“7 层 KDA 搭配 1 层 Gated MLA”的混合方案:KDA 用于以线性时间复杂度处理长序列输入,每 8 层保留 1 层 Gated MLA 以确保全局注意力机制的有效传导。
得益于该设计,其上下文窗口上限扩展至 1M,可一次性吞吐大体量文档、代码库与历史交互记录,有效减少了分块切分与人工搬运数据的成本。
在专家路由方面,模型配置了 512 个路由专家,每个 Token 动态激活其中 8 个,并同时调用 1 个共享专家。
这种混合线性注意力结合稀疏 MoE 的架构路径,旨在保障模型在长时间、复杂任务执行过程中的持续稳定性,同时有效控制计算资源开销。
工程部署方面,团队通过混合精度量化将模型权重占用从约 534GB 降至 292GB。在标准的 Hopper 架构测试环境下,部署所需 GPU 资源由 8 卡缩减至 4 卡。
针对具体的生产落地场景,团队还提供了长上下文并行推理方案(PCP/DCP),并强化了对 JSON Schema 的原生支持,进一步便利长资料处理与现有业务 API 接口的对接。
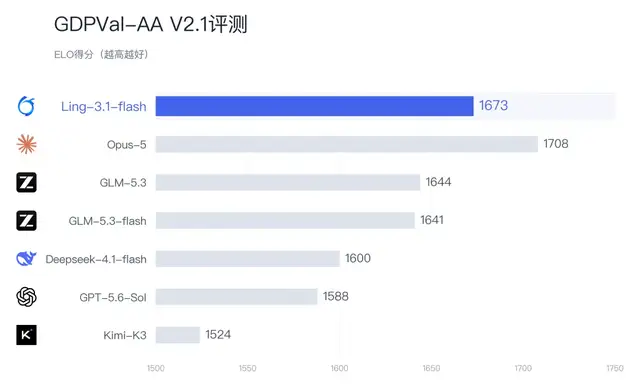
除底层架构外,实际交付能力终究要由客观基准测试检验。
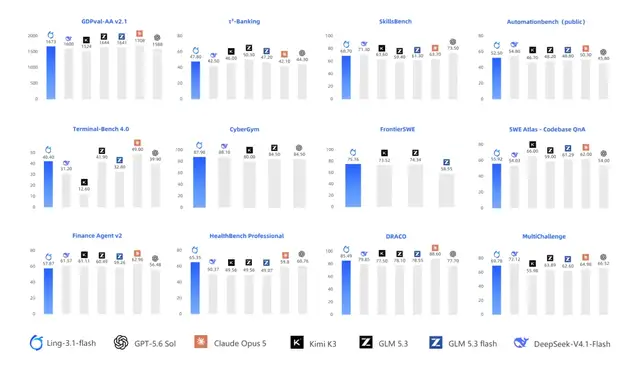
在专门针对复杂办公任务评测的 GDPVal-AA V2.1 中,Ling-3.1-flash 的 ELO 得分为 1673,展现出处理多步骤复合工作流的明显优势。
图片源自百灵官微
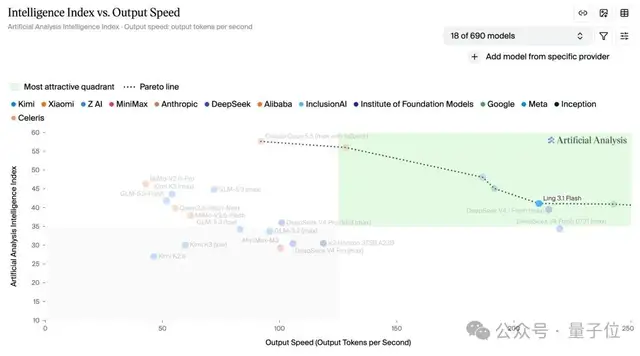
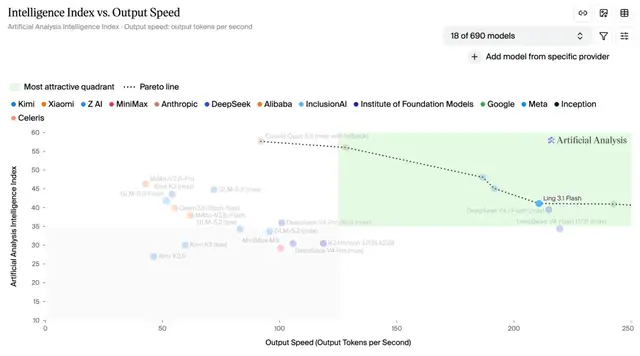
同时,来自 Artificial Analysis 的最新公开评测显示,Ling-3.1-flash 智能指数达到 41,生成速度约为每秒 210 Token,混合调用成本约为每百万 Token 0.19 美元,为高频业务场景提供了兼顾智能水平、生成效率与使用成本的优选方案。
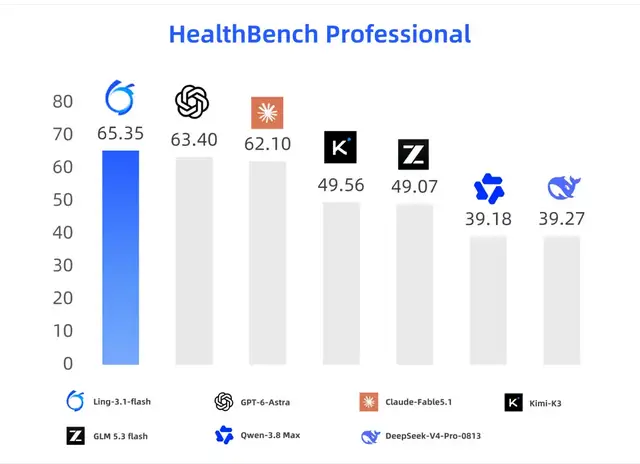
在垂直的医疗场景 HealthBench Professional 评测中,Ling-3.1-flash 也位居前列。
图片源自百灵官微
此外,在软件开发、系统终端操作等技术场景下,Ling-3.1-flash 也具备扎实的环境交互与工程执行能力。
以蚂蚁内部推进的一项长周期 Lua 原生编译器开发任务为例:测试过程持续约 17 小时,模型在自主调度下完成了反复的编写、调试与修正,最终独立测试集通过率达到了 97.8%。
在办公 Agent 的技术选型考量中,具备全局交付力与高执行准确度,构成了优先适配 Ling-3.1-flash 的核心理由。
实测 Ling-3.1-flash 见真章
为了验证其在实际业务中的落地表现,我们通过具体任务进行了实测体验。
首先选择了一项典型的双十一电商实操任务:
假设你是家居收纳品牌 Ling 的电商负责人,根据资料,你需要向老板提交一份覆盖 10 月 15 日至 11 月 11 日的双十一大促方案,方案将直接交给运营、内容、客服和仓储后续执行。
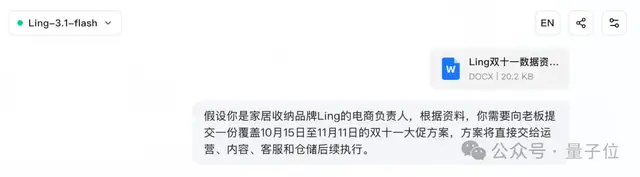
注:测试中所涉基础业务背景数据由 Codex 辅助生成。
在输入业务核心指标、商品明细、人员配置及历史投放数据后,模型开始梳理资料并推导落地执行方案。
在第一阶段,模型率先对初始目标的可行性进行了理性校验。
它没有盲目遵从过于激进的预设要求,而是在预先识别广告投放边际效应递减、仓储周转约束及峰值履约能力等变量的前提下,给出了相对合理、可量化的目标预期。
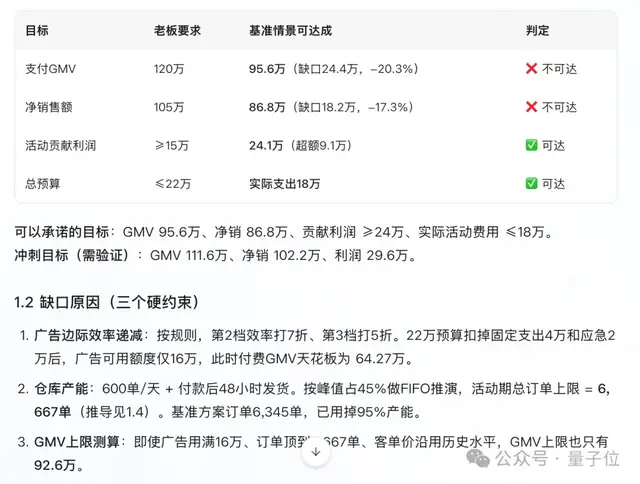
与此同时,模型还配套生成了多套调整备选路径,以便业务人员应对管理层的质询与方案论证。
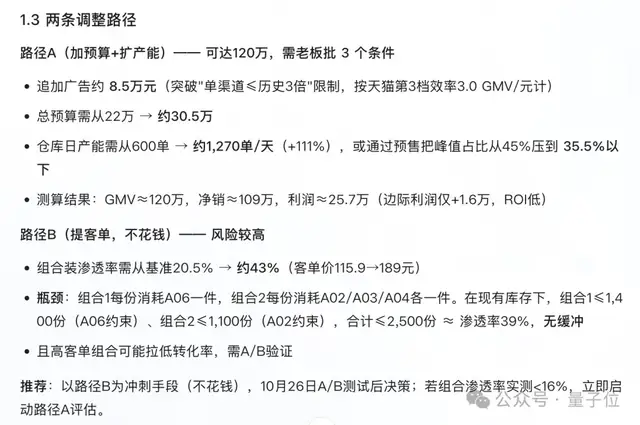
在大促优惠方案推演中,各项核心测算指标展现出了严密的逻辑闭环。
无论是组合装的定价阶梯还是渠道投放预算配比,每一项数据均具备严密依据,展现出了扎实的商业数据分析基本功。
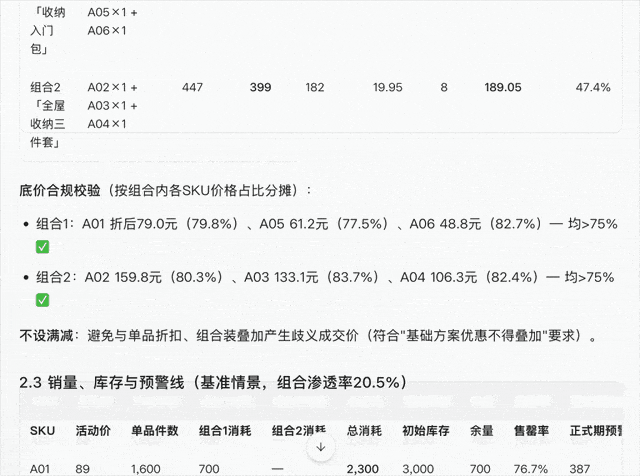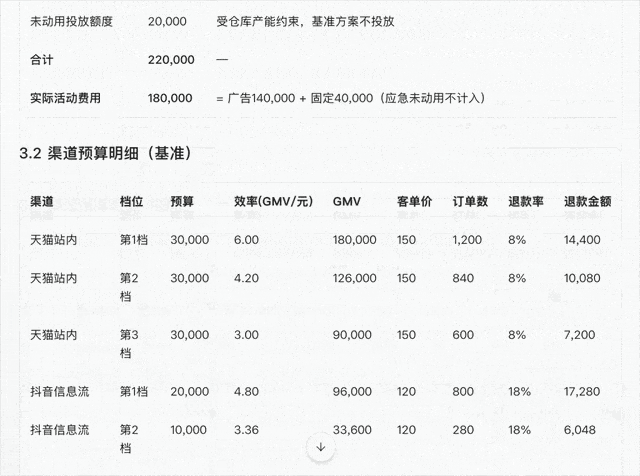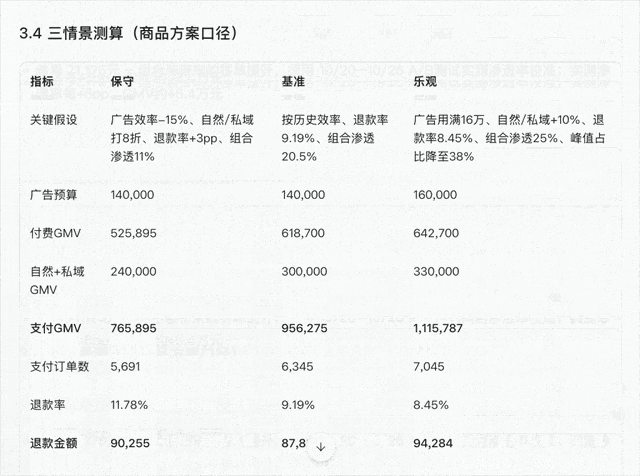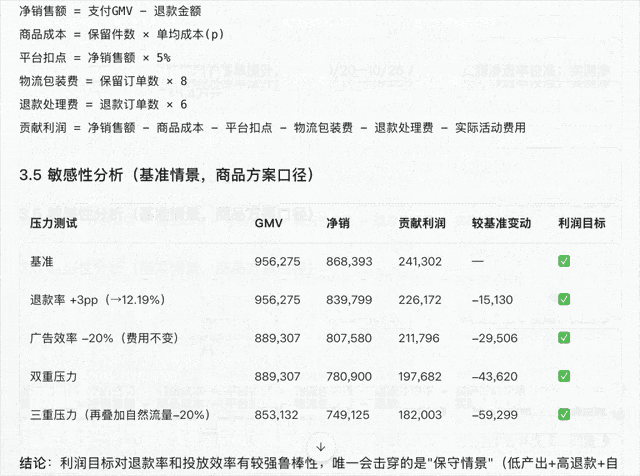
Ling-3.1-flash 还制定了非常详尽的分阶段推进排期表,明确细化了各业务线推进的前置约束条件。
虽然在 Prompt 设定中仅限定排期截止到双十一当天,但模型自主补充了后续的业务复盘节点与净利润核算流程,整体方案规划十分严密。
在文本生成质量方面,诸如短视频引流脚本、促单转化的直播话术等物料均能一键输出。
包含镜头分镜设计、口播文案与转化抓手等要素均已完备,可直接作为落地草稿使用,大幅节约撰写时间。
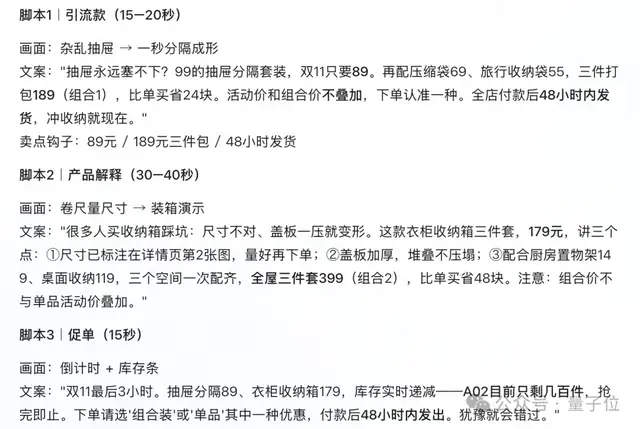
在交付的末尾环节,模型还会主动执行一致性交叉检查,明确标注出仍需业务人员二次核对的关键数据以及待决策选项,确保最终的业务决策权牢牢保留在人工手中。
除日常办公自动化外,医疗健康问诊辅助也是 Ling-3.1-flash 的优势领域。
我们为其输入了一份模拟的血脂指标检测数值及口语化的主诉描述,要求模型整理出一份便携就诊沟通清单。
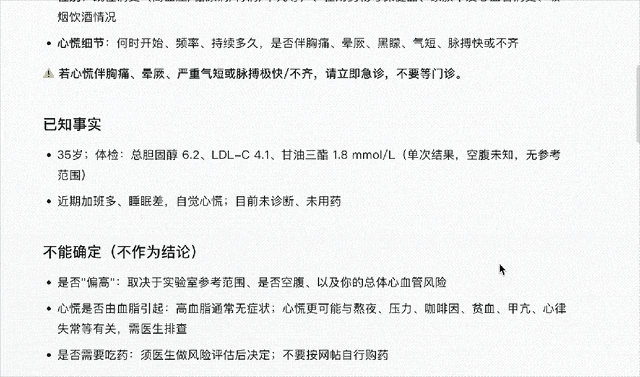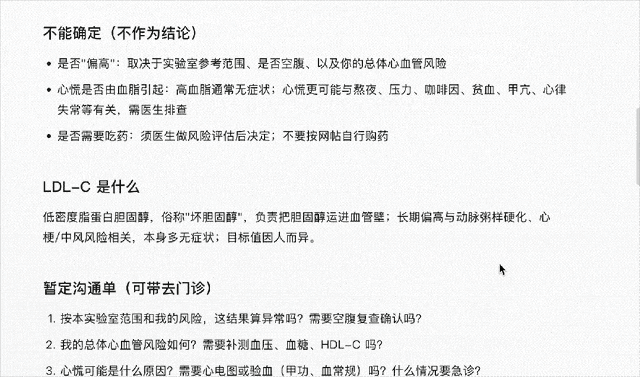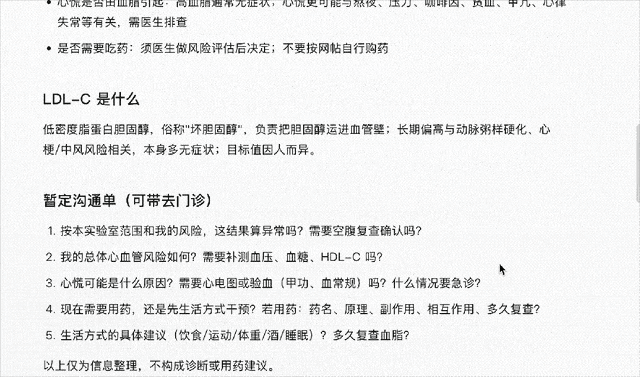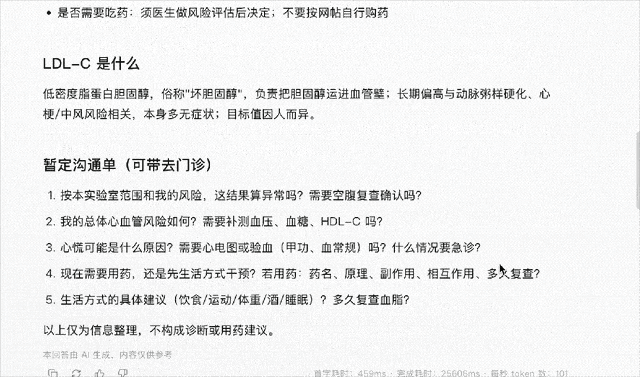
在输入信息并不完备的条件下,Ling-3.1-flash 并没有盲目给出诊疗定论,而是先梳理出需要患者补充的关键临床细节,清晰划分出“已知客观事实”、“待排查不确定项”以及“建议咨询医生的专业问题”。
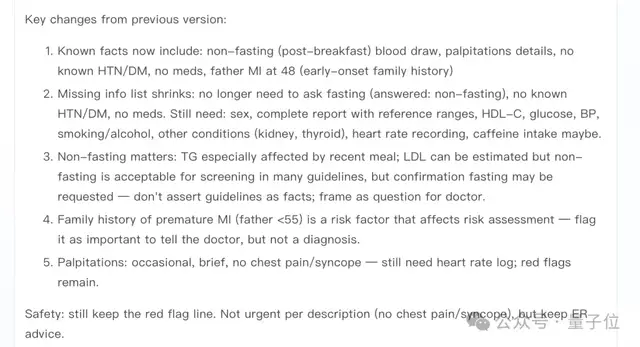
在引导补充核心信息后,模型进一步将增量信息与初始数据交叉校验,输出了一份逻辑清晰的就诊问询备忘单。
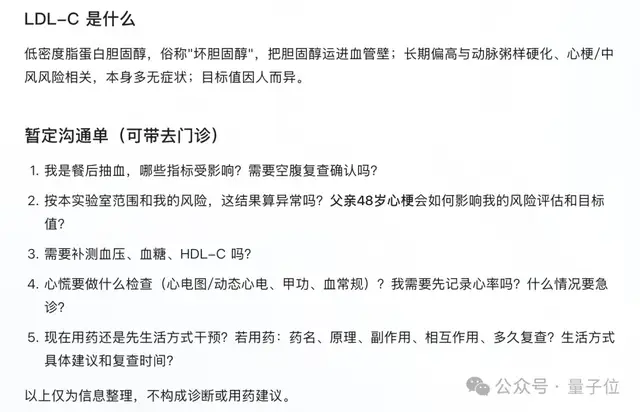
值得肯定的是,模型在推理链条中始终严守医疗红线预警原则,不断提示关注指征变化、出现危急情况应及时就医,且严格规避越权开具用药处方,始终将自身定位在协助医生完成前期分诊与病史梳理的辅助角色上。
当然,Ling-3.1-flash 在实测中也表现出一定的能力边界。例如,在单次输入超长非结构化文本时,模型的全局注意力偶有分散。
因此对于像大促整体筹备这类跨度长、变量多的复合任务,更推荐采用“分步交付”的方式(如优先用自动化脚本清洗聚合数据,再由模型逐步推导方案),循序渐进效果更佳。
单轮提示词直接生成同样存在边界。若初步输出与预期存在差距,回过头优化任务拆解逻辑和交付约束,通常比反复微调单条提示词碰运气要高效得多。
此外,当前版本尚不原生支持视觉多模态输入,仍需挂载前置视觉模型进行图片解析与桥接,这一环节客观上增加了整体部署链路的复杂度与调用成本。
综合来看,模型在不同具体业务中的交付成熟度,仍取决于业务场景本身的结构化水平。
百灵抢先进入真实任务流
回顾产品迭代脉络,百灵团队的布局逻辑清晰地命中了当前大模型行业的转折点。
在过去很长一段时间里,大模型圈内的技术发力点高度聚焦于纯代码生成(Coding)和跑分刷榜。
但当技术演进至深水区,行业内外开始普遍思考一个根本问题:迈向通用人工智能,Coding 是否是唯一的衡量准绳?
百灵负责人西亭在外滩大会上的核心研判是:Coding 绝非唯一的考场。
在团队的认知中,百灵的宗旨始终是解决现实世界的生产力问题,将大模型能力从纯技术指标中抽离,以解决真实任务的能力作为终极检验标准。
基于这一判断,百灵将 3.0 系列模型率先推向了容错率极低、专业要求极高的两个硬核领域:金融与医疗。
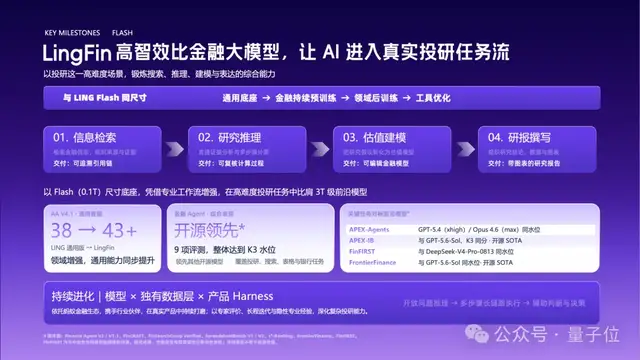
LingFin 聚焦于高智效比金融场景,以行业研报分析与数据穿透为切入点重塑金融作业效率;面向医疗健康强化的 LingSante,则深耕医学知识深度推理、循证检索与规范化诊疗流程探索。
其中,Ling-3.0-flash-Fin(总参数 124B,激活 5.1B)已深入切入实盘投研链条,打通了“海量资料提取—多维交叉分析—规范研报输出”的完整生产闭环。
其在高难度投研任务中的表现足以比肩 3T 级通用前沿模型,在金融 Agent 综合评测中处于开源领先地位,关键指标看齐 GPT-5.4 等前沿旗舰。
Ling-3.0-flash-Sante 则把高智效比带入医疗垂直场景,以 124B 参数规模在 1.6T 以下模型中取得了领先成绩,整体能力与多款超大规模旗舰模型比肩。
图片源自百灵官微
相较于一般的基座模型,这些产品并非停留在浅层的指令微调,而是真正置于严苛的生产环境中,经历长期真实业务流打磨与持续纠错演进的产物。
从更高维度观察,百灵也在尝试推动行业在效能定义上的转变,即重新诠释**“效率”**一词的内涵。
以往行业多单纯衡量算效比,即强调计算资源的单点利用效率。
百灵则进一步将模型计算效率、参数规模效率与 Token 成本整合,倡导并践行模型的综合智效比。
这一思考正逐渐成为行业共识。近半年来,Anthropic、OpenAI 等前沿厂商也在密集加码面向金融、医疗等复杂专业垂直场景的落地赋能。
例如 Anthropic 此前推出的 Claude for Financial Advisors,便是将底层连接器与业务任务 Skills 紧密嵌合于岗位工作流的具象实践。
尽管未来路径演进的胜负远未定型,但**“深入真实工作流”**已从少数团队的前瞻探索,全面演变为全行业的核心风向。
这一年,也是百灵由单一算法能力展示全面跃迁至任务价值兑现的关键节点。
透过 Ling-3.1-flash 的推出,百灵后续的技术图景已逐渐展开:
向上,持续拓宽 Agent 体系在复杂任务中调度的能力边界;向下,显著缩减企业与个人的推理部署成本,将高智效比真正转化为高效办事的生产力;向外,深度渗透各类专业垂直行业,在实体经济场景中探索不可替代的业务突破点。
大模型赛道的价值证明方式正在加速换挡,而面向实体与生产力场景的真正角逐,才刚刚开始。
Ling Studio:
https://ling.tbox.cn
OpenRouter:
https://openrouter.ai/inclusionai/ling-3.1-flash
HuggingFace:
https://huggingface.co/inclusionAI/Ling-3.1-flash
ModelScope:
https://modelscope.cn/models/inclusionAI/Ling-3.1-flash