
Black Forest Labs 的 FLUX.3 Image Klein 现已发布,并且从首日开始即可在 Diffusers 中运行。单个模型即可同时支持文本生成图像(text-to-image)与多参考图的图像生成图像(multi-reference image-to-image),并带来了一项全新功能:布局控制(layout control)。你可以在提示词中写入边界框(bounding box)来指定图像各部分的位置,或者指定参考图像中哪些部分需要移动。 这两个开源权重检查点均已收录在 FLUX.3 Image Klein 合集 中:
| 检查点(Checkpoint) | 说明 | 默认参数 |
|---|---|---|
black-forest-labs/flux-3-image-klein | 时间步蒸馏(Time step distilled),用于快速推理 | 16 步,无 CFG |
black-forest-labs/flux-3-image-klein-base | 基础模型(Base model) | 50 步,启用 CFG |
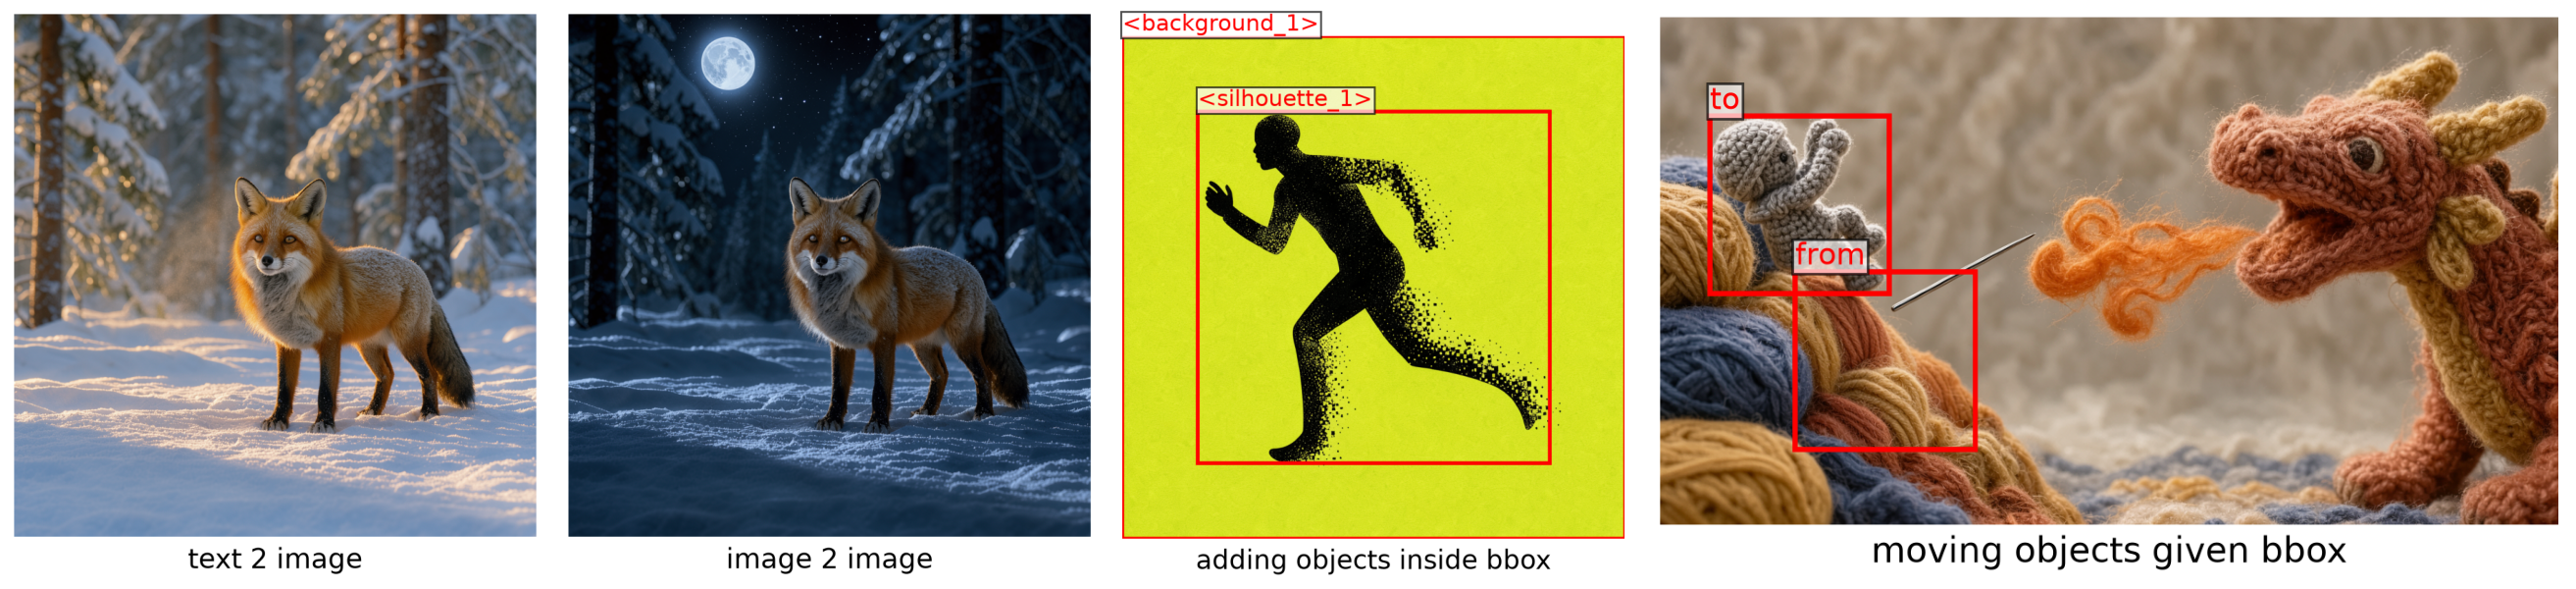
你现在就可以前往 Hugging Face Space 亲自生成一些图像!
摘要(TL;DR)
- 单个模型即可实现文本生成图像、多参考图的图生图以及基于边界框的布局控制。
- 蒸馏版检查点在单张 H100 上生成一张 1024 × 1024 分辨率的图像仅需约 2 秒。
- 支持通过
from_single_file加载 NVFP4 和 FP8 权重,适用于显存较小的 GPU。 - 提供适用于文本生成图像和图像编辑的 LoRA 训练脚本。
- 以 模块化 Diffusers(Modular Diffusers) 流水线形式发布,方便用户按需拆卸或添加自定义模块。