
2026年10月15日 · 科学
Pengfei Tian、Maxwell L. Bileschi、Zoi Tsangalidou、Sukhdeep Singh 与 Lucy J. Colwell
面对日益严峻的抗菌药物耐药性危机,新型抗生素的研发迫在眉睫,但寻找新疗法的过程往往缓慢且耗费大量人力。如今,依托我们的智能体开发平台 Google Antigravity,这一研发流程将得到显著简化。
Google Antigravity 提供了一个基于智能体的科学工作台,赋能生物学家快速发现、结构评估并筛选高价值候选靶点,将以往需要跨多个数据库进行的碎片化检索整合至单次会话中。此外,它还能协助研究人员利用 ProtNLM 模型快速扫描 UniProt 数据库中数百万个此前未表征的蛋白质。ProtNLM 能够直接根据氨基酸序列预测其生物学功能。
本技术演练展示了生物学家如何使用 Google Antigravity 发现一种新型候选抗菌肽。该候选肽被预测对引发呼吸道感染的病原体具有活性。目前,所发现的先导分子正在接受湿实验验证。
寻找新型抗菌肽
日益严重的抗菌药物耐药性(AMR)是当今时代最紧迫的全球公共卫生危机之一,预计到 2050 年每年可能导致全球约 1000 万人死亡。为防患于未然,我们急需发现新型治疗药物。抗菌肽(AMPs),特别是细菌素(bacteriocins),作为传统抗生素的替代方案展现出巨大前景。它们在自然演化中形成了靶向竞争细菌核心弱点的机制,从细胞外壳到必需的细胞内机器,这使得病原体极难对其产生耐药性。
基因组和宏基因组测序的指数级增长,使全球数据库中积累了数十亿条天然氨基酸序列。这一天然数据宝库已经孕育出了全球广泛应用的细菌素,如乳链菌肽(Nisin),以及近期通过基因组挖掘获得的突破性分子,如达罗巴汀(Darobactin)、迪诺巴汀(Dynobactin)和拉里奥西丁(Lariocidin)。
然而,许多分子仍深藏于蛋白质数据库尚未注释的“暗物质”中。由于它们与已知蛋白质缺乏相似性,其功能至今未被表征。例如,全球领先的蛋白质序列与功能信息公共资源数据库 UniProt 中,就包含数百万条直接从基因组测序项目转入、但功能未知的序列。
为了填补这一空白,Google 开发了 ProtNLM(蛋白质自然语言模型)。这是一个深度学习模型,经过专门训练能够直接解读氨基酸序列底层演化的“语法”。这使得模型能够直接从原始蛋白质序列中预测其生物学功能,从而为 UniProt 中数百万个此前未命名的条目赋予高置信度的功能标签。
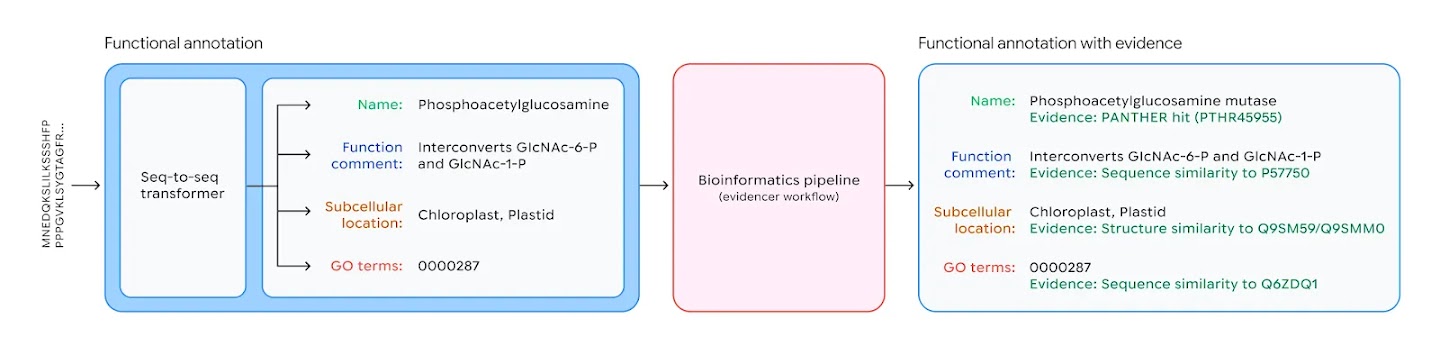
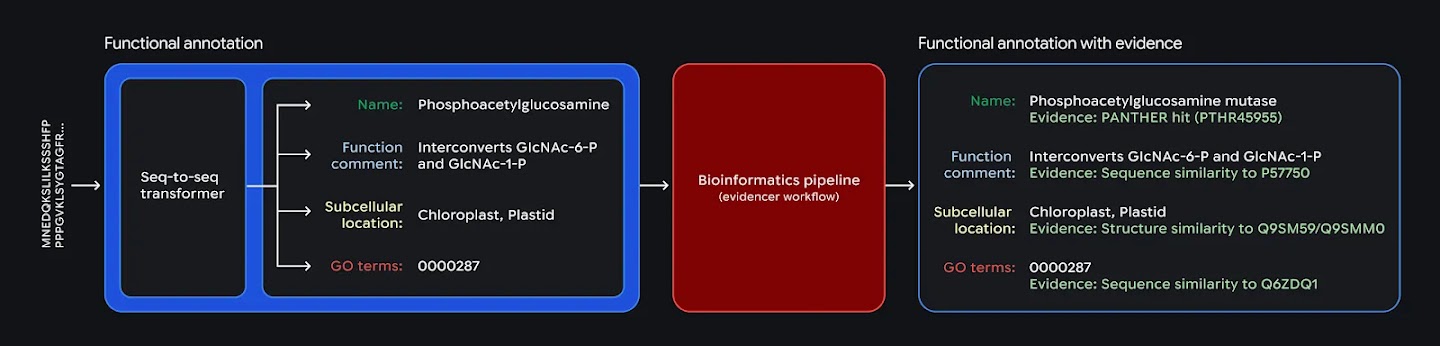
ProtNLM 流程概览:将原始氨基酸序列转化为未审查 UniProtKB/TrEMBL 条目的自然语言生物学注释。该系统的功能注释范围涵盖蛋白质名称、功能描述、亚细胞定位、基因本体术语(GO terms)以及关键词。
协同智能
科学发现往往不是一蹴而就的单步流程;寻找切实可行的候选蛋白质需要结合人类直觉,并通过多轮迭代融入新的实证证据。在 Antigravity 中,研究人员与 AI 智能体首先确立一个明确的生物学目标:在假肺炎链球菌(Streptococcus pseudopneumoniae)中寻找并在计算层面验证新型抗菌肽(AMPs)。在交互式的多轮会话中,研究人员主导科学策略,决定提出哪些问题以及收集哪些证据;而智能体则承担繁重的跨数据库调度、结构分析和文献综合工作。
幻灯片 1 / 6
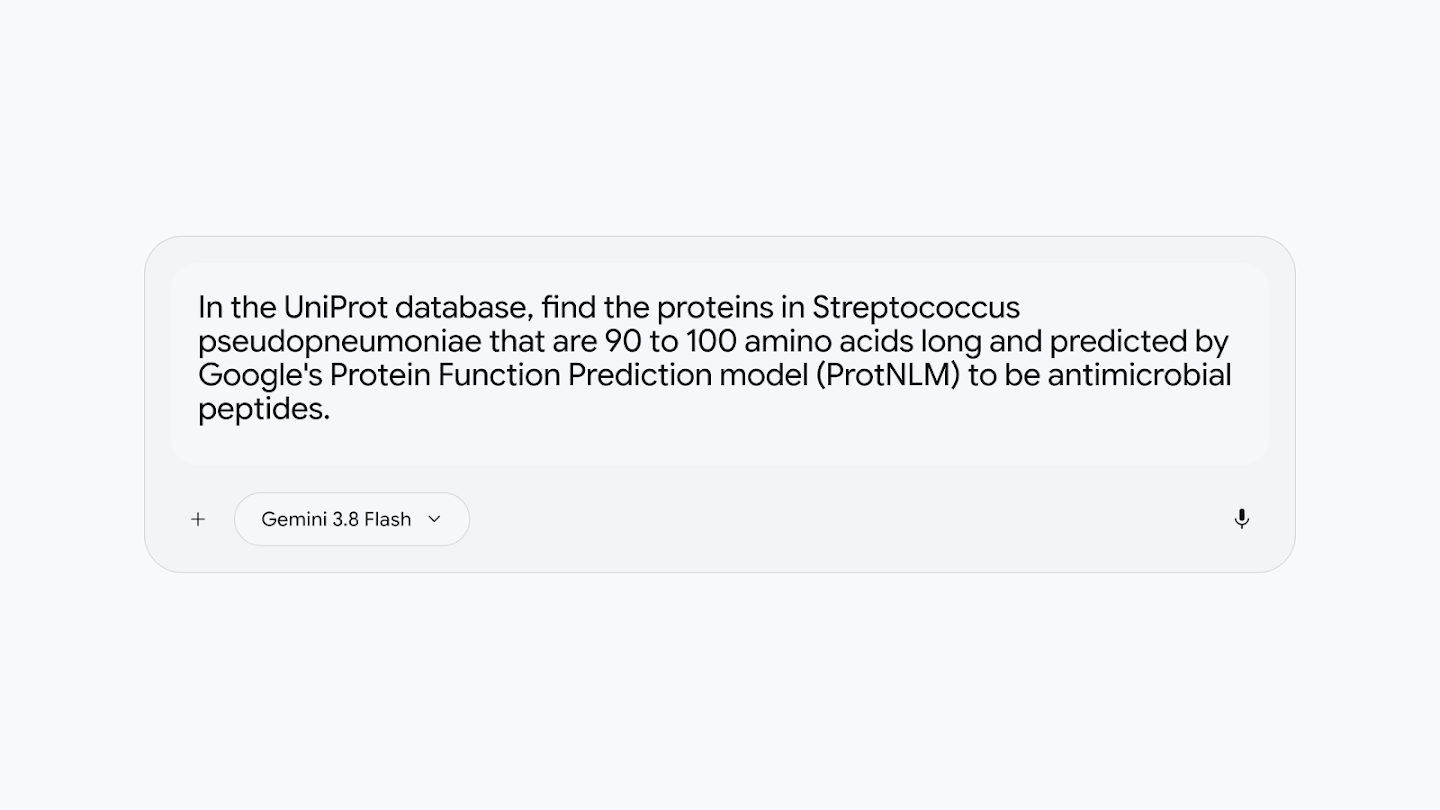
在浩瀚的搜索空间中导航:
智能体对数据库进行检索,并将数百万个条目筛选缩减为少数几个值得关注的候选分子。在此处,智能体发现了一种来自乳球菌素 972 家族(Lactococcin 972 family)、长度为 97 个氨基酸的细菌素(UniProt ID:A0A0U0D591)。
![图 43:交互式界面展示