
一次采集,反复使用
让 Agent 写周报、分析方案,已成为许多人的日常习惯。但每次开启新任务,用户往往仍需翻找资料、补充背景,智能体也需要经历查找、阅读、整理等多道工序才能正式进入状态。一旦更换任务,整套流程又得从头再来。
反复处理这些已有资料不仅费时费力,还会徒增 Token 消耗。资料越繁杂、链路越冗长,就越容易出现信息遗漏或理解偏差,直接影响任务完成的准确率。
为解决这一痛点,WorkSwarm 首次原生支持“个人知识空间”。
“个人知识空间”基于用户配置的多源资料渠道,能够自动采集内容,并通过纯规则处理、规则与大模型混合处理或智能体自主处理等方式,将零散资料整理为有目录、有联系、有出处的结构化个人知识,最终以“渐进式披露”的方式提供给智能体按需调用。
WorkSwarm 将零散的个人资料沉淀为可长期复用的个人知识库,真正实现**“一次采集,反复使用”**,既让智能体更精准地定位并用好背景信息、提升任务完成率,又大幅缩减了准备时间与 Token 消耗。
openJiuwen个人知识空间:自动采集个性化多源知识,办公智能体按需使用
个人知识空间围绕“来源、采集、处理、使用”四层架构,将用户日常积累的个人资料转化为可持续复用的任务背景知识。
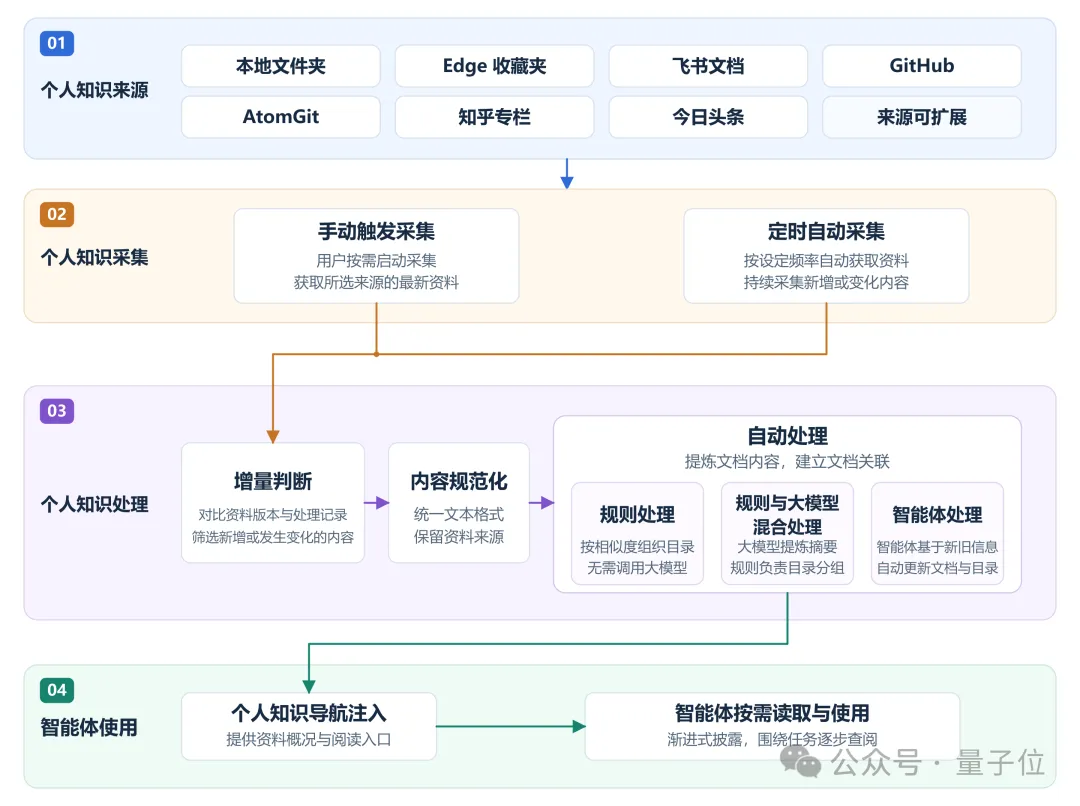 △ 个人知识空间四层流程:涵盖多源资料配置、手动与定时采集、三种处理方式及智能体按需调用
用户首先选定知识来源与采集范围,系统据此按需或定时获取内容。采集到的资料经格式归一化与增量判断,自动识别本轮需更新的内容与变动;随后,系统依照预设的规则处理、混合处理或智能体处理机制,将内容整理为主题目录与 Markdown 页面,并完整记录文档间的关联与原始出处。在通过目录结构与引用来源校验后,最终成果即可供用户随时查阅。
当用户在任务中开启该功能时,系统会向智能体提供知识概况与阅读入口,由智能体围绕当前目标逐步调阅关联页面,让沉淀的知识成为高效执行任务的可靠上下文。
个人知识空间配置与采集:自主选择个人知识来源,支持手动/定时增量采集
在“设置”中的“知识”页面启用个人知识空间后,用户可自由接入本地文件夹、Edge 收藏夹、知乎专栏、今日头条、飞书文档、GitHub 以及 AtomGit 等多元渠道。各来源支持独立配置,用户可完全自主掌控哪些个人资料进入知识空间。
配置完成后,用户既可以手动触发采集以主动刷新知识库,也能设置定时自动采集,按固定周期持续抓取更新。系统会结合数据源标识、版本号及采集进度,精准识别新增或变动的资料,并在已有知识框架下进行高效的增量处理。
在“来源管理”页面中,采集进度与实时状态一目了然,用户不仅能随时调整同步频率、检查本轮采集结果,还可一键中止正在进行的采集任务。
(操作示例:在“设置”的“知识”页面开启个人知识空间后进入“来源管理”,以今日头条为例,添加作者主页链接即可手动启动采集并实时监控同步状态。)
个人知识处理:提供三种整理方式,让分散资料成为可复用的知识
网页、文档与代码的格式各异,同一主题的内容也常散落于不同渠道。个人知识空间首先统一数据格式,再对核心内容进行提炼,按主题重构成目录与独立页面。这既便于智能体快速把握全局脉络后按需深入阅读,也完整保留了原始文档的跳转链接与出处信息。
每当引入新资料时,系统会在现有知识基础上进行增补与迭代,确保知识在同一套纯文本体系中持续演进沉淀。
用户可根据资料特征与整理诉求,在“设置”的“知识”页面自由选择以下三种处理方案:
- 规则处理:依托 BM25 词项权重与文本相似度算法将页面归入对应主题,并自动化维护目录及页面引用关系,全程无需调用生成式大模型。
- 规则与大模型混合处理:先由大模型提炼新资料的标题、摘要与关键词,再交由规则系统完成主题聚类与目录搭建,最后由大模型生成清晰的目录标题与导读简介,兼顾效率与可读性。
- 智能体处理:由智能体深度分析新资料与既有知识体系的关联,优先更新或合并至已有主题,必要时新建文档,并全自动同步维护目录索引与交叉引用关系。
采用后两种方式时,用户可自主配置专用于资料整理的模型。整理完成后,系统将自动校验目录结构与引用源,通过检查的内容便可立即供用户查阅及智能体调用。
此外,用户还能借助文件树、知识图谱或全文搜索快速检索内容,展开阅读正文,并依托“来源”标注随时回溯原始出处。
(检索示例:采集完成后,若已包含“jev”相关内容,用户在“知识”页面检索“jev”即可在右侧查看结构化正文,或通过图谱直观探索关联节点。)
按需使用:渐进式披露,让智能体带着已有知识开始工作
当资料沉淀为系统化的个人知识后,用户可在任务输入框通过“+”菜单将智能体与知识空间连接。收到用户指令后,智能体首先获取空间全局概览与索引入口以掌握知识边界,随后紧扣任务目标,沿目录与引用链接逐层深入检索,灵活补全所需上下文。
这种“渐进式披露”机制,如同人类员工接手项目时先通读目录与立项介绍,再针对性调阅细化文档,确保每次任务都能按需、精准地调用沉淀知识。
采集进程与任务调用彼此独立受控:系统可在后台保持静默采集与更新,智能体仅在用户授权时调阅知识;即便关闭任务调用,数据采集仍可正常运行,用户亦能随时自主浏览与检索已有文档。
用户始终拥有知识准入与智能体使用权限的绝对控制权。开启新任务时,用户只需专注于当下目标,而底层沉淀的知识体系将自然充当智能体的上下文智囊。
(调用示例:启用个人知识空间后,输入“介绍一下 jev”并发送,WorkSwarm 即可自动调阅知识库中的相关文档,直接输出包含核心机制、落地实践等维度的系统化回答。)
效果对比:提升任务通过率,减少任务耗时与 Token 消耗
借助个人知识空间,智能体能够先明晰已有资料的范畴,再精准定位与调阅关键文档,有效避免了在执行阶段盲目、重复地翻找原始材料。
研发团队通过 2 组基准对比测试,直观验证了该机制对任务完成度、执行耗时与 Token 占用的优化效果:
对比显示,在个人知识空间加持下,WorkSwarm 能够融会贯通客户档案、项目材料及进度规划,迅速梳理出清晰详实的项目复盘与后续待办;而在缺乏该空间时,智能体历经多轮检索仍难以触达核心背景,最终只能产出空泛的会议准备框架,并被动要求用户手动补足信息。
同样,启用知识空间后,WorkSwarm 可直接借力此前在浏览器收藏夹、知乎专栏等渠道沉淀的认知资产,大幅提升任务推进速度。
此外,openJiuwen 团队专门构建了包含 25 个真实场景的评测集,涵盖本地论文、浏览器收藏、飞书文档、GitHub、AtomGit、知乎和头条等 7 类典型数据源,深入覆盖单源检索、跨源整合、换题复用、事实缺失补全及无关干扰等多类场景,并预先确立量化验收标准。实测数据显示,开启个人知识空间后:
- 任务通过率提升 32%:智能体能够更快捷地命中所需信息,融合跨渠道碎片化资料形成完整答复,显著减少因资料缺失或遗漏导致的任务失败。
- 任务总耗时缩减 76.2%:背景资料在前期已完成预处理与结构化沉淀,任务执行时可直接调取成熟文档,省去了临时查找、通读与二次整理等繁重流程。
- 任务阶段 Token 总消耗降低 84.1%:沉淀后的知识具备高复用性,智能体按需精确抽取所需片段,大幅避免了重复喂入海量原始文档所带来的无谓消耗。
虽然在智能体处理模式下的预处理阶段会产生一定 Token 成本,但该部分可通过选用性价比较高、专精于内容抽取的轻量模型来控制;且随着知识成果在后续各类任务中被反复调用,单次摊薄成本将趋近于零。
结语
openJiuwen 个人知识空间旨在将分散孤立的个人信息系统化,转变为可长期复用的智力资产。在用户自主设定来源的前提下,系统自动完成增量同步与结构化重组,既方便用户日常查阅,也便于智能体按需调取,为多样化的复杂任务提供坚实的背景支撑。
面向未来,openJiuwen 个人知识空间将探索结合用户实际工作行为动线,自动捕捉业务目标与知识盲区,主动发起定向知识扩充,使积累沉淀更契合真实生产力场景,让办公智能体在深度协同中越用越顺手。
个人知识空间,让你积累的每一份资料,都成为下一次 Agent 协同进化的起点。
目前个人知识空间已在 WorkSwarm 全面实装,体验与代码获取途径:
- WorkSwarm 官网:https://openjiuwen.com/workswarm
- GitHub:https://github.com/openJiuwen-ai/jiuwenswarm
- AtomGit:https://atomgit.com/openJiuwen/