
LFM2.5-24B-A2B 是一款拥有 240 亿(24B)参数的推理模型,其激活参数仅为 20 亿(2B),专为在端侧实现快速、私密的智能体(Agent)而打造。它在回答前先进行思考,能够调用工具,并能在主流智能体框架(Agent harnesses)中执行多步任务。由于每个 token 仅激活 2B 参数,单次推理 token 的计算成本极低,使用户能够在自有硬件设备上持续运行智能体。
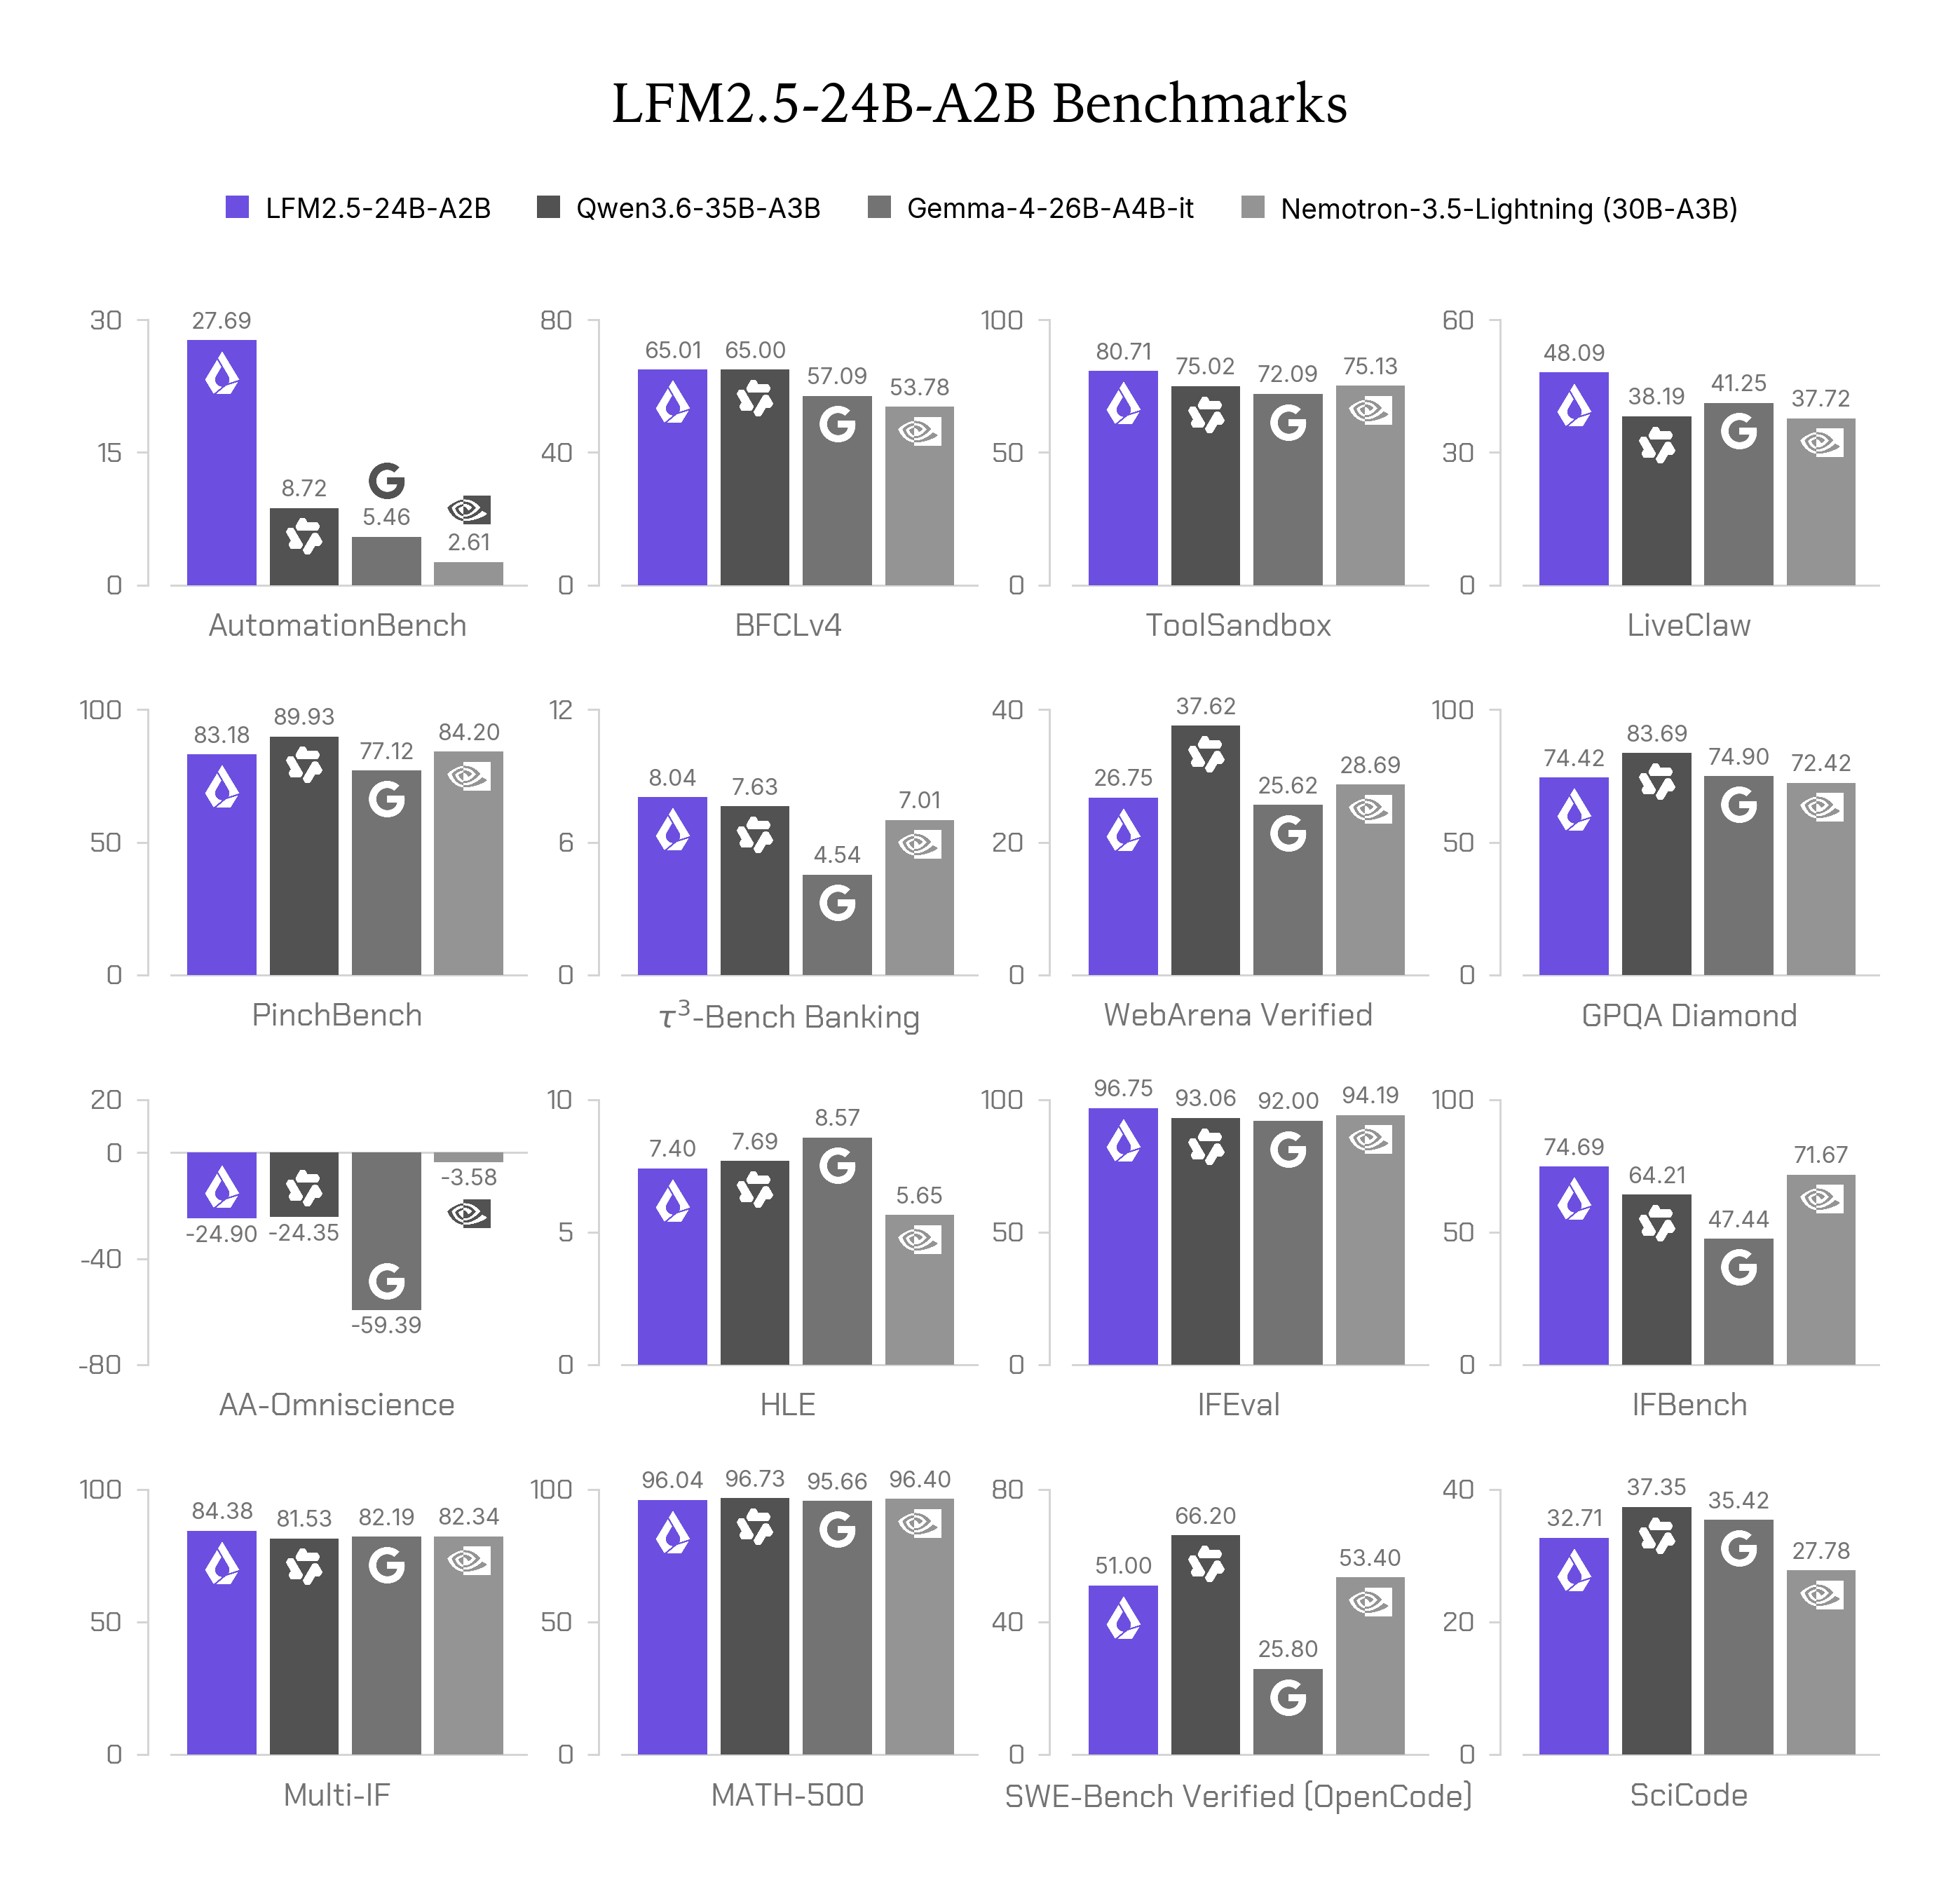
- 同类最佳智能体: 在智能体与工具调用任务上,足以媲美总参数和激活参数高出约 50% 的 Qwen3.6-35B-A3B,在 LiveClaw 评测中以 48.09 领先于后者的 38.19。
- MoE 级别的推理速度: 始终在回答前进行思考。每个 token 仅激活 2B 参数,使每个推理 token 的成本都十分低廉。
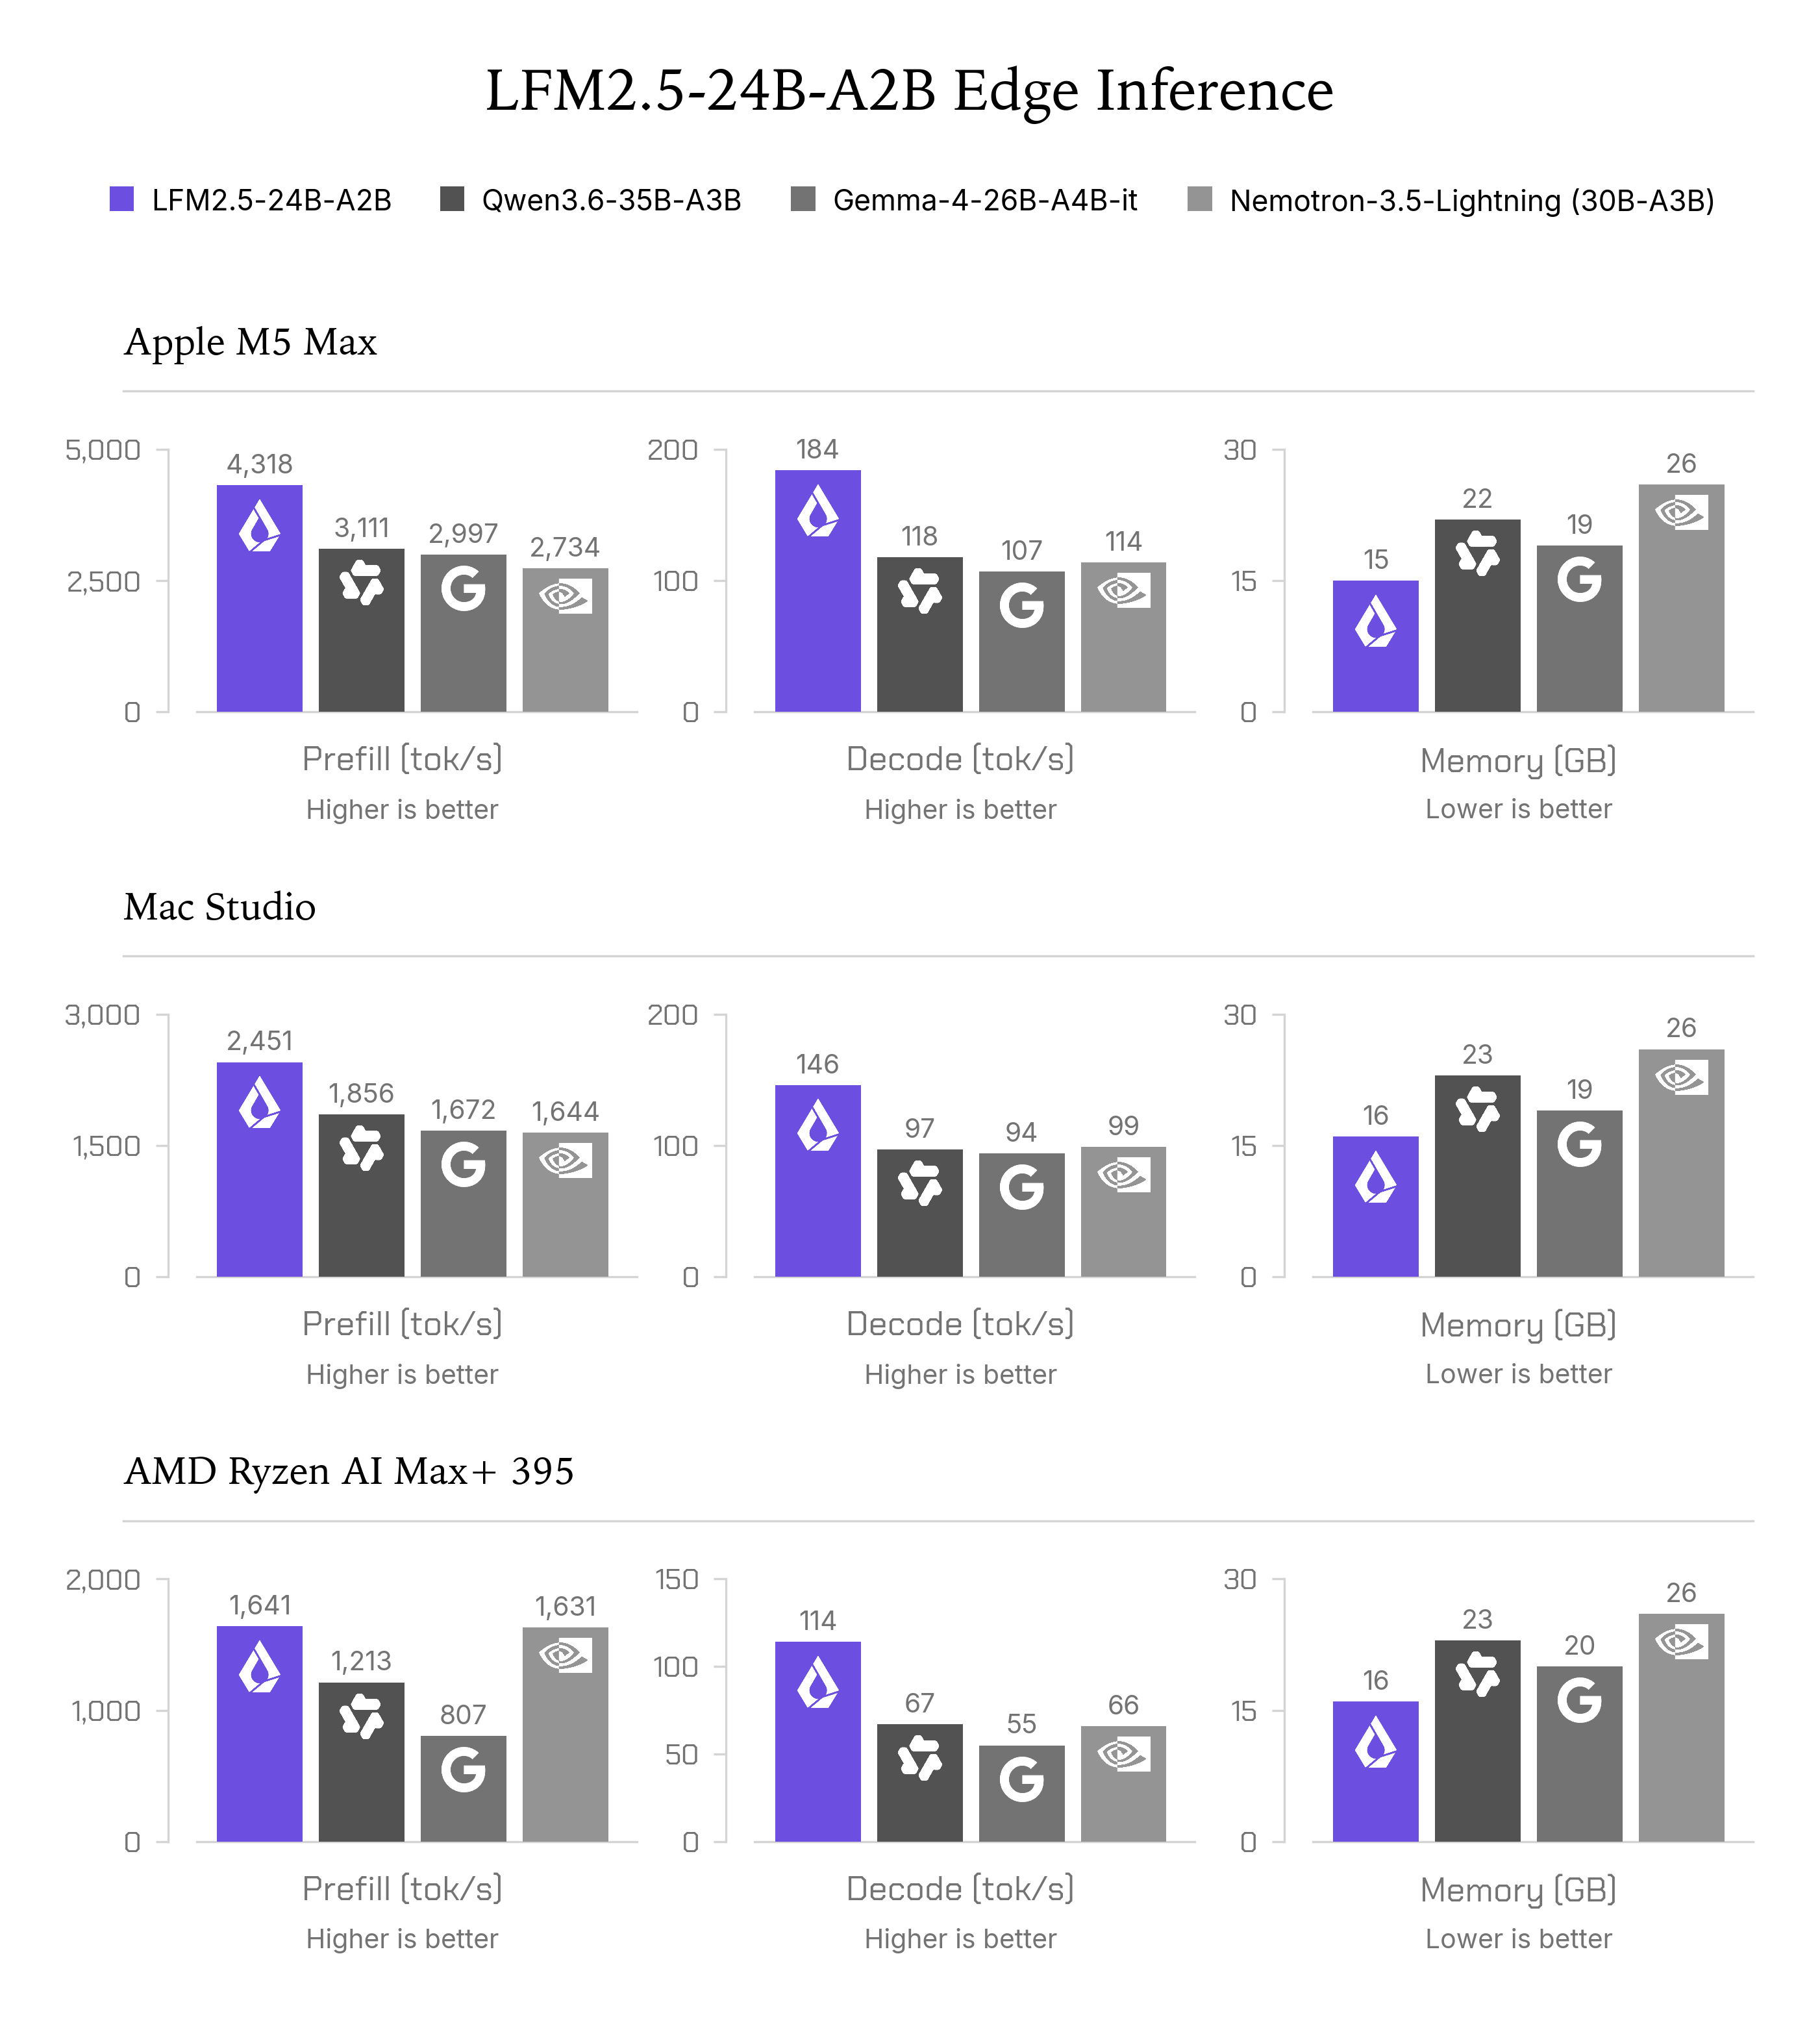
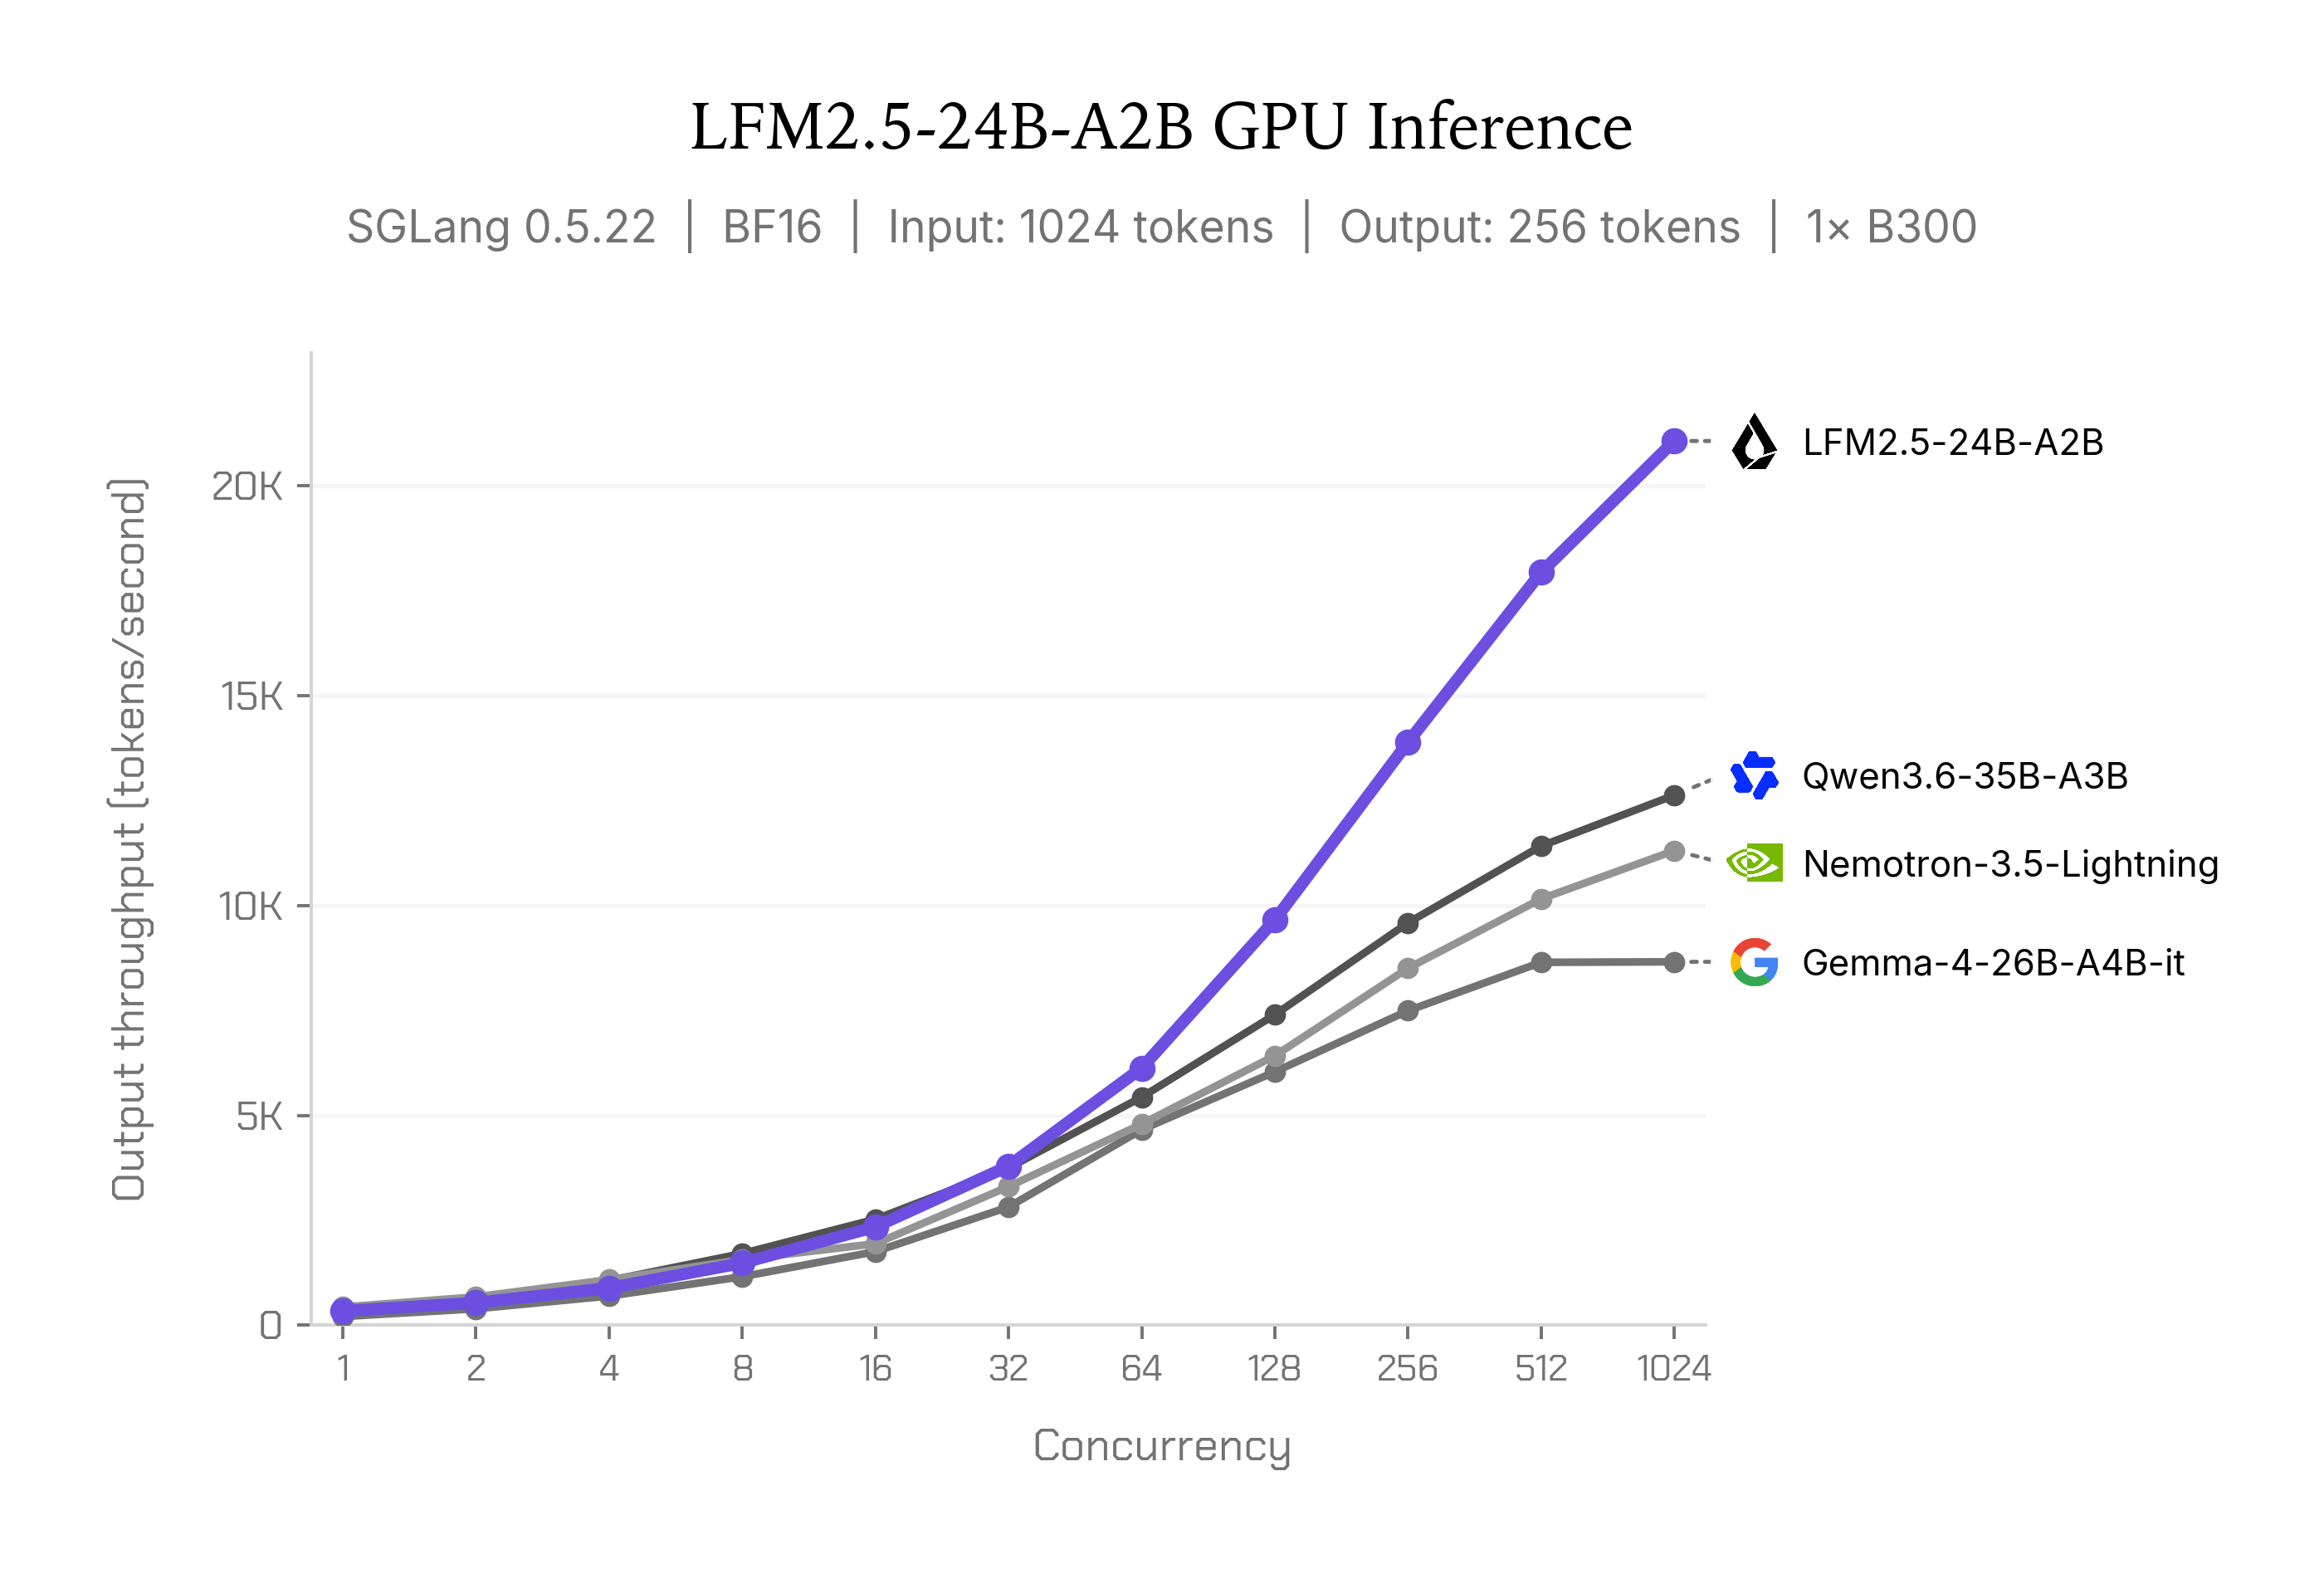
- 高效推理: 在 Apple M5 Max 上可达 184 tok/s,在单张 NVIDIA B300 GPU 上最高可达 2.1 万(21K)输出 tok/s。
我们如何构建一个仅需 2B 激活参数的推理智能体
LFM2.5-24B-A2B 基于 LFM2-24B-A2B 构建,并沿用了其模型架构:40 层网络,每个 MoE 模块包含 64 个专家且采用 Top-4 路由,并结合了门控短卷积(gated short convolutions)与分组查询注意力(GQA)的混合架构。上下文窗口从 32K 提升至 131K tokens,并通过原位分词器扩展(in-place tokenizer expansion)将词表容量从 65K 翻倍至 128K tokens,从而提升对非拉丁语系文本的分词效率。与前代不同,它是一款纯推理模型(reasoning-only model),在输出最终回答前会生成显式的思维链(Chain of Thought)。
预训练规模从约 17T tokens 增加到了约 33T tokens。随后,中期训练(Mid-training)在 32K 上下文下注入了 2T tokens,侧重于推理、数学、代码、指令遵循以及多语言文本;并在 131K 上下文下加入了 300B tokens,偏重长上下文数据。工具调用和多轮交互轨迹贯穿这两个阶段。后训练(Post-training)则通过五个阶段将基座模型打造成智能体:
- 监督微调(SFT)
- 教师模型专业化(Teacher specialization)
- 非智能体多领域同策略蒸馏(MOPD, non-agentic): 在非智能体任务上对专家教师模型进行蒸馏。
- 智能体 MOPD(MOPD, agentic): 聚焦于智能体任务的第二阶段蒸馏。
- 智能体强化学习(Agentic RL): 在智能体框架中训练模型,例如 OpenClaw、Hermes Agent、Pi 和 OpenCode。
基准测试结果
我们在涵盖工具调用与智能体工作流、通用知识、指令遵循、数学和代码的 16 个基准测试中,将 LFM2.5-24B-A2B 与 Qwen3.6-35B-A3B、Gemma-4-26B-A4B-it 以及 Nemotron-3.5-Lightning 进行了对比评估。虽然它是这组模型中参数量最小的,但其实力足以与总参数和激活参数高出约 50% 的 MoE 模型抗衡。
| 基准测试 | LFM2.5-24B-A2B | Qwen3.6-35B-A3B | Gemma-4-26B-A4B-it | Nemotron-3.5-Lightning (30B-A3B) |
|---|---|---|---|---|
| AutomationBench | 27.69 | 8.72 | 5.46 | 2.61 |
| BFCLv4 | 65.01 | 65.00 | 57.09 | 53.78 |
| ToolSandbox | 80.71 | 75.02 | 72.09 | 75.13 |
| LiveClaw | 48.09 | 38.19 | 41.25 | 37.72 |
| PinchBench | 83.18 | 89.93 | 77.12 | 84.20 |
| τ³-Bench Banking | 8.04 | 7.63 | 4.54 | 7.01 |
| WebArena Verified | 26.75 | 37.62 | 25.62 | 28.69 |
| GPQA Diamond | 74.42 | 83.69 | 74.90 | 72.42 |
| AA-Omniscience | -24.90 | -24.35 | -59.39 | -3.58 |
| HLE | 7.40 | 7.69 | 8.57 | 5.65 |
| IFEval | 96.75 | 93.06 | 92.00 | 94.19 |
| IFBench | 74.69 | 64.21 | 47.44 | 71.67 |
| Multi-IF | 84.38 | 81.53 | 82.19 | 82.34 |
| MATH-500 | 96.04 | 96.73 | 95.66 | 96.40 |
| SWE-Bench Verified (OpenCode) | 51.00 | 66.20 | 25.80 | 53.40 |
| SciCode | 32.71 | 37.35 | 35.42 | 27.78 |
*所有模型均使用 vLLM 进行评测,并采用各基准测试推荐的生成参数。
对于实际应用而言,它的核心优势在于工具调用和指令遵循。在 8 项工具调用与智能体基准测试中,LFM2.5-24B-A2B 在其中 5 项(AutomationBench、BFCLv4、ToolSandbox、LiveClaw 和 τ³-Bench Banking)上保持领先或追平对手;在 AutomationBench 上,其得分更是次优模型的三倍以上。同时,它在全部 3 项指令遵循测试中均位列第一。体量更大的模型在知识密集型测试(如 GPQA Diamond、HLE 和 AA-Omniscience)以及代码测试(如 SWE-Bench Verified (OpenCode) 和 SciCode)中依然保有些许优势,因此对于高度依赖知识的任务,建议将 LFM2.5-24B-A2B 与检索增强(RAG)或网页搜索搭配使用。
这些评测结果使 LFM2.5-24B-A2B 成为构建在本地设备上稳定运行、具备推理能力与工具调用能力智能体的强大底座。
CPU 和 GPU 上的推理速度
LFM2.5-24B-A2B 首发即提供全面的推理生态支持,包括 llama.cpp、MLX、vLLM、SGLang 和 ONNX。
端侧/边缘推理。 LFM2.5-24B-A2B 是对比的 MoE 模型中速度最快的一款,在 M5 Max 上的解码速度为 184 tokens/s,在 Ryzen AI Max+ 395 上为 114 tokens/s。比次优模型快了高达 1.7 倍,同时内存占用最低。
GPU 推理。 LFM2.5-24B-A2B 是同体量级别中速度最快的模型,在高并发场景下单张 B300 的输出速度超过 21K tokens/秒。
如何使用 LFM2.5-24B-A2B
若你需要构建兼具推理、工具调用能力且能在本地设备上稳定运行的智能体,LFM2.5-24B-A2B 是理想之选。
安装最新版本的 transformers(兼容 transformers>=5.0.0):
pip install -U transformers然后加载并运行该模型:
from transformers import AutoModelForCausalLM, AutoTokenizer, TextStreamer
model_id = "LiquidAI/LFM2.5-24B-A2B"model = AutoModelForCausalLM.from_pretrained(    model_id,    device_map="auto",    dtype="bfloat16",)tokenizer = AutoTokenizer.from_pretrained(model_id)streamer = TextStreamer(tokenizer, skip_prompt=True, skip_special_tokens=True)
prompt = "What is C. elegans?"
input_ids = tokenizer.apply_chat_template(    [{"role": "user", "content": prompt}],    add_generation_prompt=True,    return_tensors="pt",    tokenize=True,)["input_ids"].to(model.device)
output = model.generate(    input_ids,    do_sample=True,    temperature=0.1,    top_k=50,    repetition_penalty=1.05,    max_new_tokens=512,    streamer=streamer,)
在你的智能体框架中使用
在任意兼容 OpenAI 接口的本地后端部署运行 LFM2.5-24B-A2B,然后将你的智能体框架指向该端点即可。例如,使用 Hermes Agent:
hermes config set model.provider customhermes config set model.base_url http://localhost:8080/v1hermes config set model.default LFM2.5-24B-A2Bhermes config set model.context_length 131072hermes config set model.api_mode chat_completionshermes config set agent.tool_use_enforcement true具体端口取决于你所使用的推理后端:llama.cpp 与 MLX 使用 8080,vLLM 使用 8000,SGLang 使用 30000,LM Studio 使用 1234。关于 OpenClaw 和 Pi 的配置可查看模型卡片,完整搭建配置步骤请参阅官方指南。欢迎查阅我们的[发布博客](https: