
面壁开源 MiniCPM-V 4.7
金磊 发自 凹非寺
量子位 | 公众号 QbitAI
什么?35B 的 MoE,在手机上也能跑得很丝滑?
确实如此。
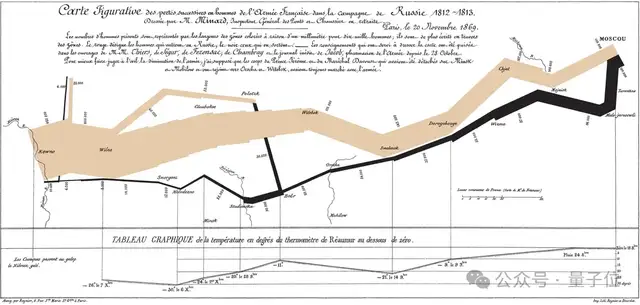
我们在完全断网的状态下,给搭载端侧模型的 iPhone 17 Pro Max 上传了一张经典的数据可视化图表——拿破仑远征俄国失败的行军路线图:
接着直接向它提问:
图里记录的最低气温是多少摄氏度,出现在哪一天?顺带讲一下换算过程。
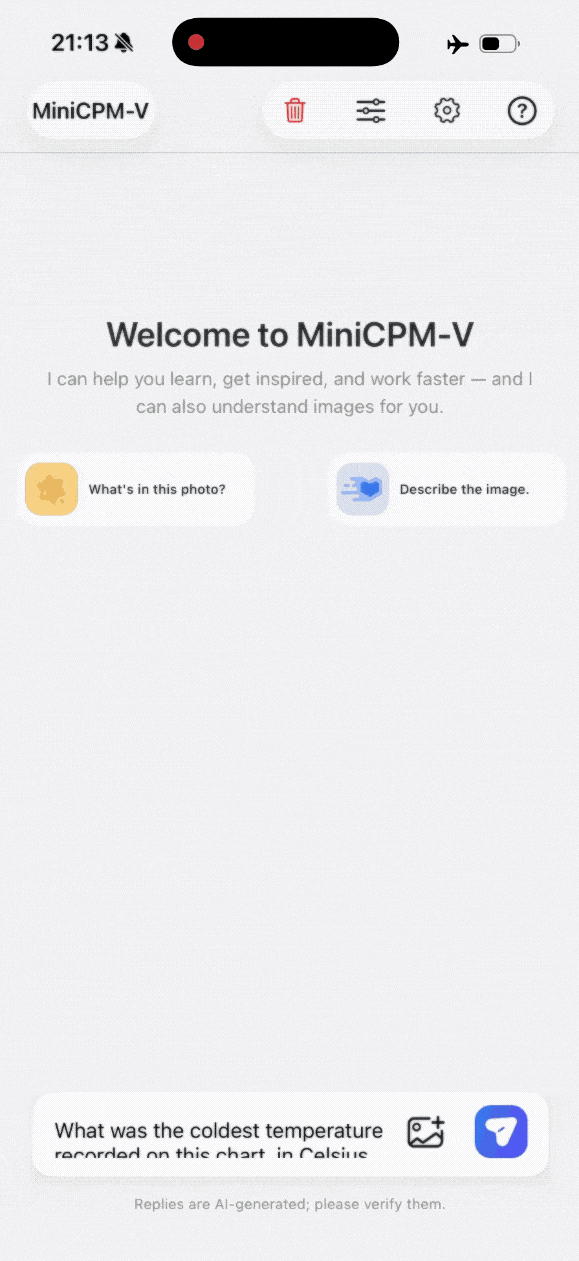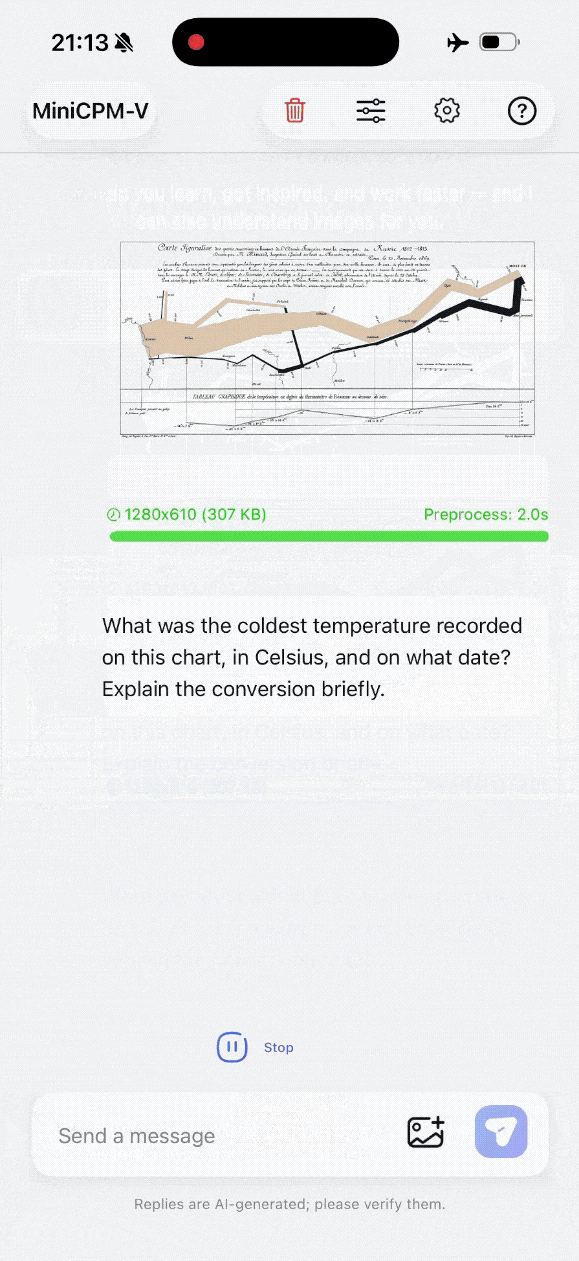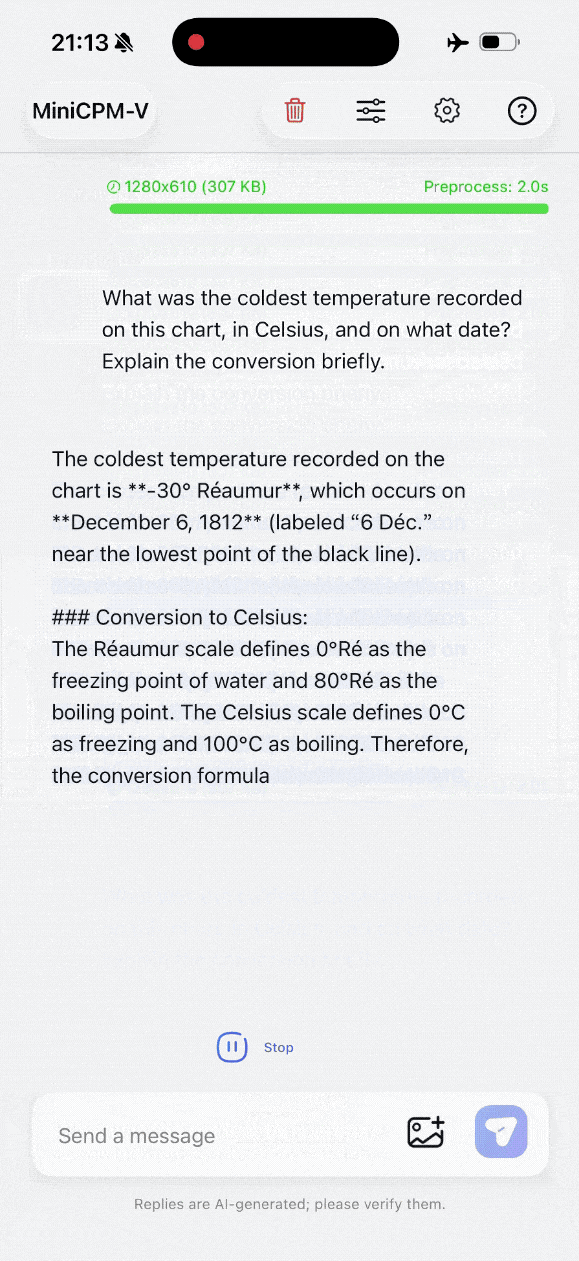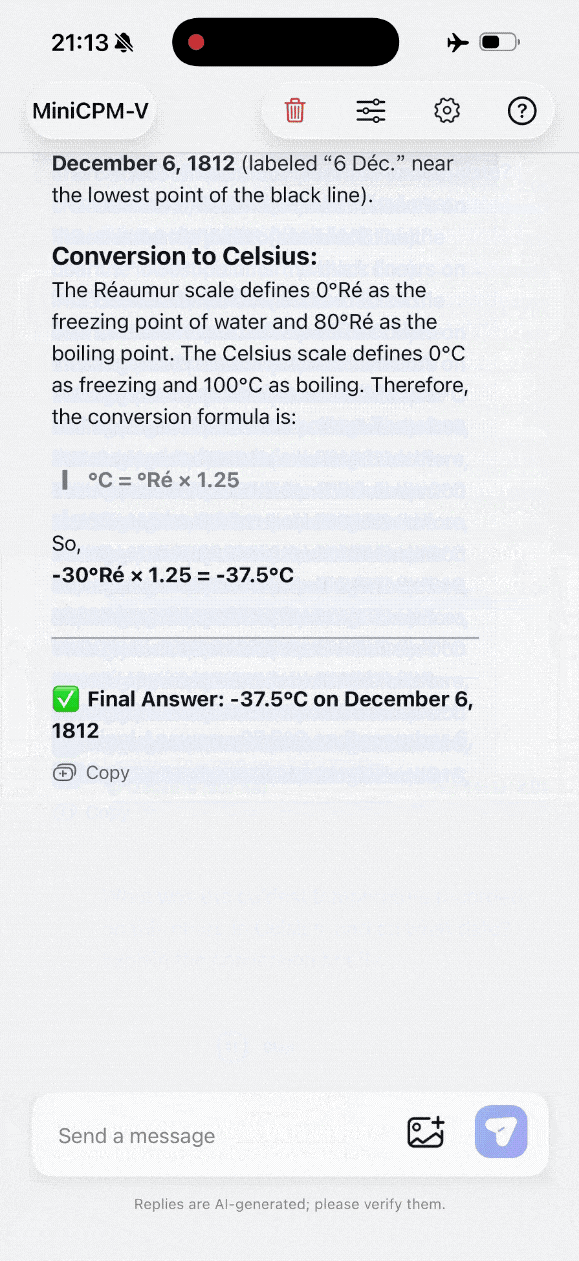
可以看到,不到 1 分钟的时间,手机本地运行的模型便准确锁定了路线上零下 30 度的标注,判断出对应日期为 1812 年 12 月 6 日,并按 1 列氏度等于 1.25 摄氏度完成换算,给出了零下 37.5 摄氏度的准确答案。
不仅如此,该端侧模型的生成速度还可以更快。
例如,针对同一张路边停车标志的照片与同一个关于停车时间的提问,左侧为未做优化的 35B 模型,右侧为经过优化后的版本:
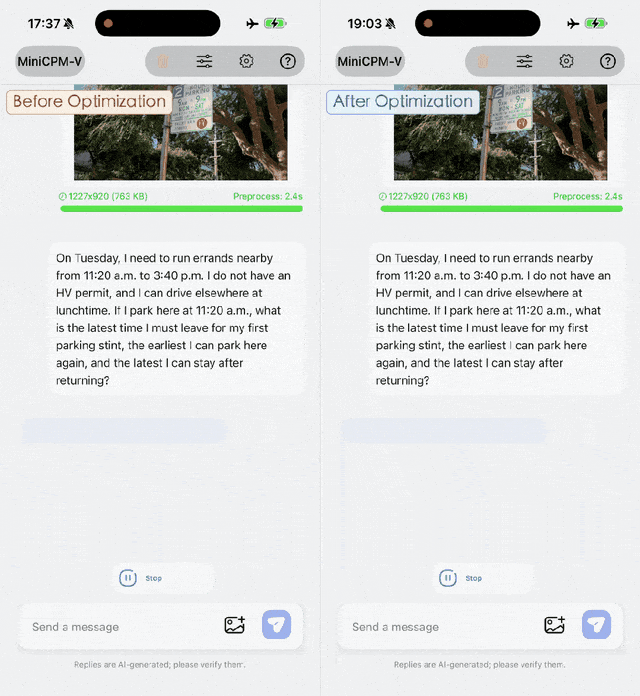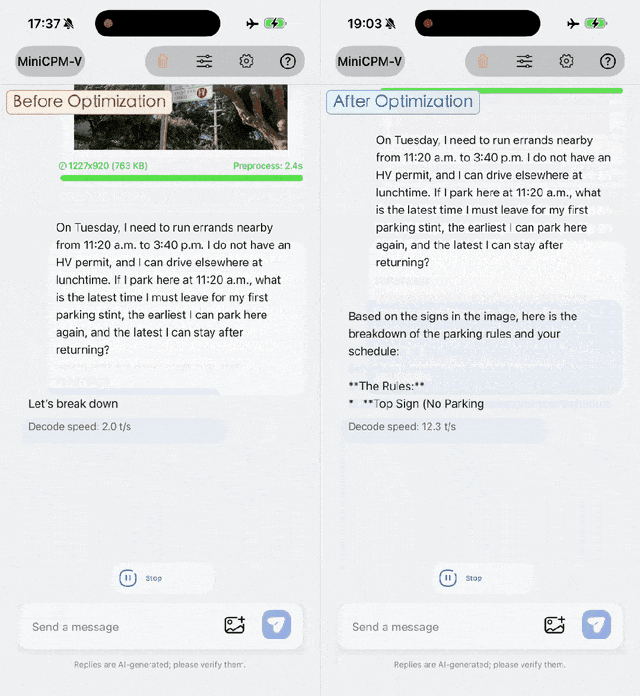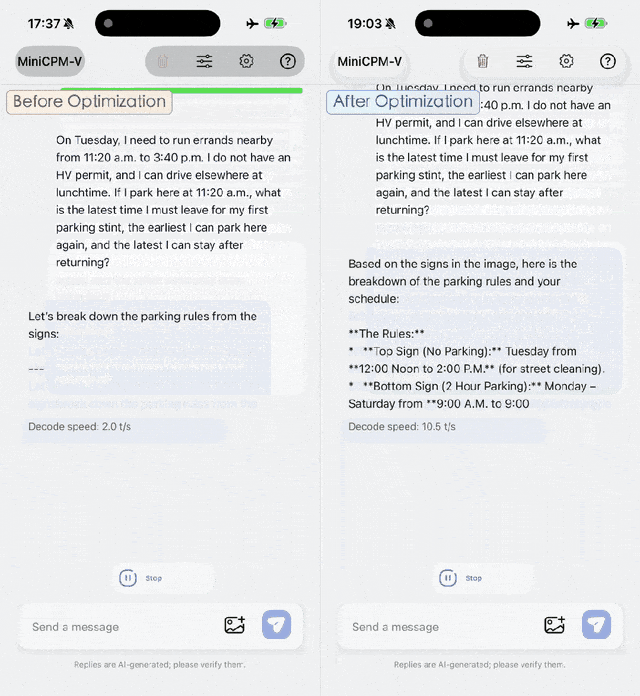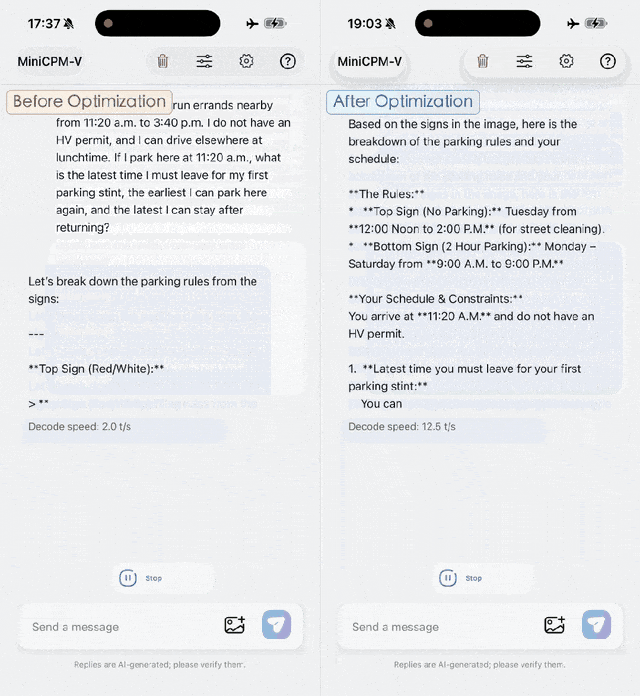
对比可见,未优化时模型的生成速度大约为每秒 2 个 Token;而在深度优化后,生成速度直接提升至每秒 8~12 个 Token。即便在无网络连接的状态下,模型回答依然能极速输出。
据了解,该 35B 模型在 iPhone 17 Pro Max 上运行时,在仅占用约 3GB 内存的情况下,解码速度能达到每秒 13 个 Token 以上。
流畅度表现确实亮眼。
那么,这款能在手机上流畅运行的模型究竟是什么来头?
它正是面壁智能与 OpenBMB 近日正式开源的 MiniCPM-V 4.7。本次开源共包含两个尺寸版本:
- 35B-A3B:总参数量为 35B,单次推理仅激活 3B,是 MiniCPM-V 系列的首款 MoE 模型。仅需约 3GB 内存即可在 iOS 和 Android 设备上流畅运行。
- 1B:实际参数量为 1.3B,主打极小体积,在 OCR、数学推理及视频理解等维度上均处于同尺寸模型的第一梯队。
除了运行速度快,MiniCPM-V 4.7 在端侧多模态大模型领域的综合性能表现究竟如何?
在通用视觉理解方面,35B-A3B 在 MMBench 评测中取得 91.72 分,MMStar 取得 80.67 分;在数理能力方面,MMMU 与 MathVista 得分分别达到 80.22 和 88.00;在视频理解评测中,Video-MME 与 LongVideoBench 也分别斩获 76.40 与 68.90 分。
值得一提的是,在 OmniDocBench v1.6 文档理解评测中,35B-A3B 取得了 94.24 分,相比同类模型普遍在 80 分上下的水平,实现了 12 分以上的显著领先。
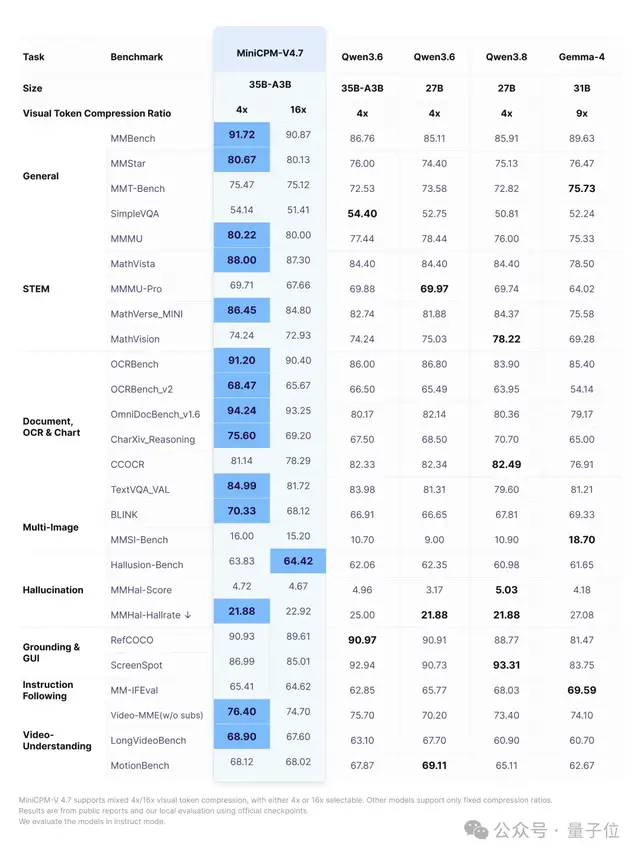
更值得关注的是其开启 16 倍视觉压缩后的表现:MMBench 评分仅从 91.72 微降至 90.87,OCRBench 从 91.20 降至 90.40,在大幅节省端侧算力开销的同时,几乎没有牺牲模型精度。
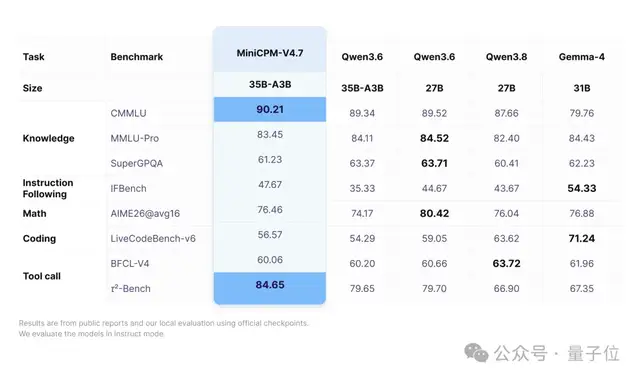
此外,在纯文本能力方面,MiniCPM-V 4.7 在中文综合常识基准 CMMLU 上斩获 90.21 分,在工具调用评测 τ2-Bench 上取得 84.65 分,同样位居同类评测榜首。
据悉,MiniCPM-V 4.7 是业界首个在兼顾无损高性能的同时、能在端侧设备上流畅运行的开源 MoE 模型。
接下来,我们看看它在更多实际场景下的能力表现。
把 35B 装进口袋,断网也能用
首先来看一道贴近日常生活实际的题目。
我们给模型输入了一张家庭用电调查表,上面详细记录了空调、冰箱、电热水壶、电视、洗衣机及待机设备的功率与使用时长,并附带当月电费账单——合计耗电 420 度、金额 126 元。
测试任务包含三个具体子问题:
- 估算每件电器一个月的耗电量并进行排序;
- 计算上述电器总耗电量占账单的百分比,评估差额部分是否可能全由未统计电器产生;
- 对比三种节能方案(空调每天少开 1 小时、电视每天少看 2 小时、待机设备每天彻底断电 8 小时),挑出省电效果最显著的方案。
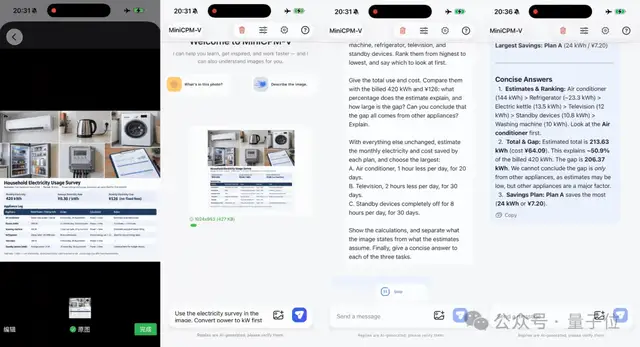
从推理结果来看,35B-A3B 首先将功率单位从瓦转换为千瓦,结合日均使用时长逐项计算出月用电量。其中空调以每月 144 度排在首位;冰箱则根据能效标签标注的年耗电 280 度,折算为每月约 23.33 度;其后依次为电热水壶、电视、待机设备和洗衣机。
经核算,这六类电器月耗电总计约 213.63 度,对应电费 64.09 元,仅占总账单的约 50.9%,差额达 206.37 度。在三个节能方案中,模型准确指出“空调每天少开 1 小时”效果最优,单月可节电 24 度,节省 7.2 元。
即便在完全离线状态下,面对这种涉及多步骤推演的复杂图表,35B-A3B 依然交出了严谨准确的答卷。
看完 35B 版本,再来看看 1B 参数量版本的实际表现。这次我们要求 1B 模型将一页论文图片完整转换为 Markdown:
请将这个图片转写为 markdown。
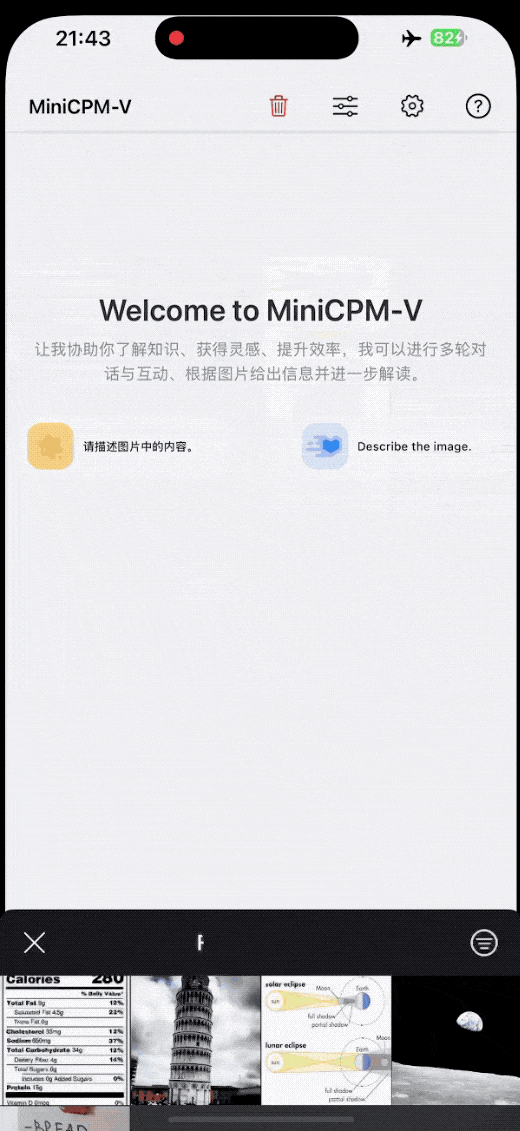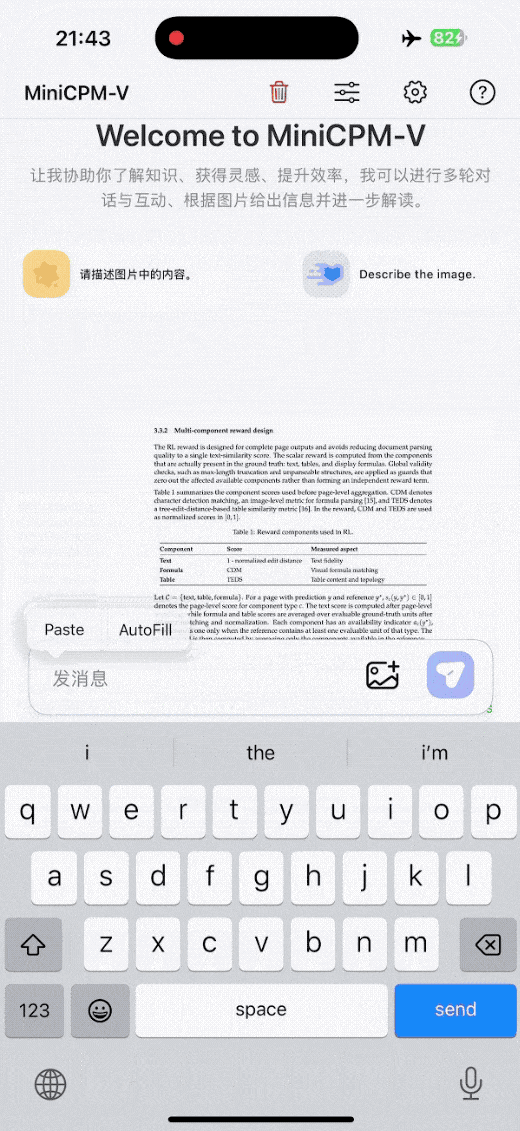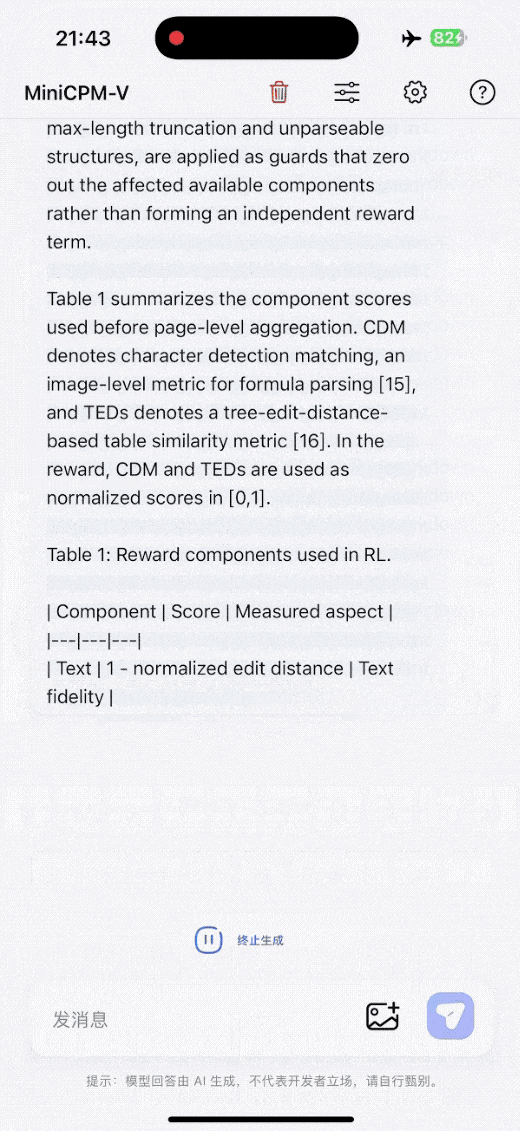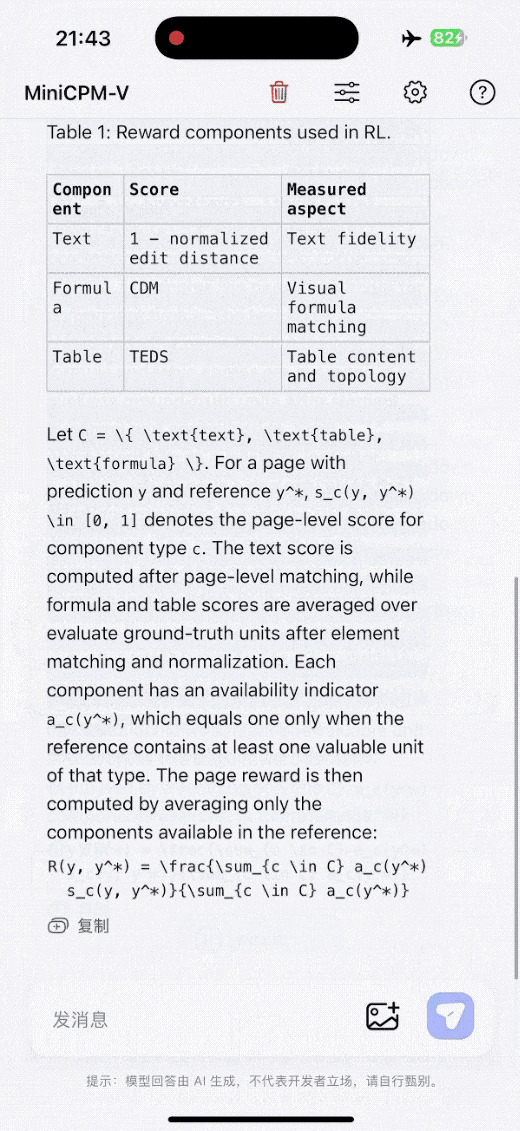
不到半分钟的时间,模型便完整还原了标题层级、正文段落及表格结构,公式部分也规范转录为了 LaTeX 格式,渲染后排版与原文献基本吻合。
对于经常需要处理论文截图、整理 PDF 资料的用户而言,以往此类任务多依赖云端多模态大模型处理。如今,一个 1.3B 的小模型在手机本地端侧即可快速完成。
除智能手机外,在 iPad 等平板端侧设备上,该模型同样表现优异。
例如前面展示的拿破仑远征图问答,在搭载 M4 芯片的 iPad 上运行测试,模型依然秒级输出了“1812 年 12 月 6 日、零下 37.5 摄氏度”的精准结论。

除了端侧部署,我们还通过 API 对 MiniCPM-V 4.7 进行了多轮测试。
第一项测试是小票结构化记账。我们提供了一张包含 6 种日常商品(从纯牛奶、全麦面包到抽纸)、附带会员折扣与优惠券抵扣(最终实付 78.40 元)的超市购物小票。要求模型将其整理为标准化记账表格,并核算金额计算是否准确。
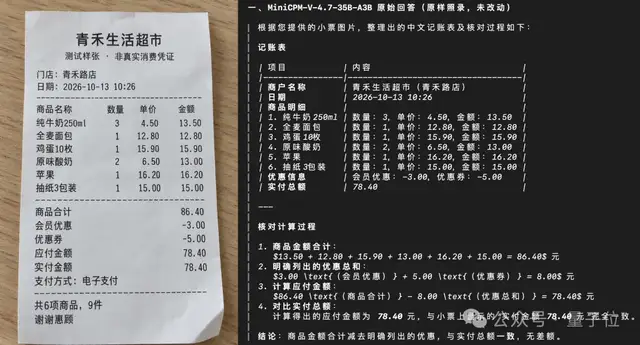
测试结果显示,35B-A3B 准确提取出门店名称、消费日期及 6 样商品的单价、数量与实收金额,没有出现一处 OCR 识别错误。
在金额核验环节,尽管票面已标注合计金额 86.40 元,模型依然主动对各明细进行了二次累加验证,确认无误后再扣除 8 元优惠抵扣,得出实付 78.40 元,逻辑完全自洽。
第二项测试同样围绕停车标识,但规则判定逻辑更为繁琐。
测试设定的背景为:周二、车辆持有居民通行证、当天此前未停靠过,计划停车时间为 14:10 至 15:40。要求模型就停车时长、是否涉及清扫时段违规、是否超限、是否需缴费以及方案整体合规性进行逐一研判。
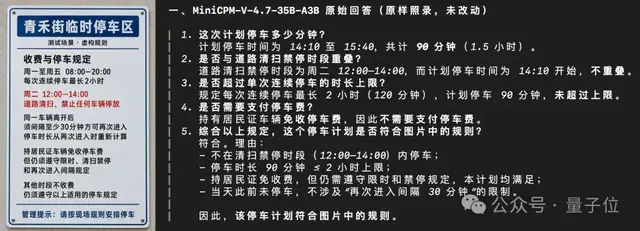
35B-A3B 正确解答了全部 5 项判定:计算出总停车时长为 90 分钟,起始时间 14:10 刚好避开了 12:00~14:00 的道路清扫禁停窗口,且未超过 2 小时单次停放上限;由于车辆持有居民通行证,停车费用予以免除。
在最终结论中,模型细致梳理了各项规则边界,甚至明确指出了“因当天首次停放,无需适用‘重新入场须间隔 30 分钟’这一限制条款”,最终判定该停车方案完全合规。
3GB 内存如何流畅运行 35B 参数模型?
看完实际表现,关键的工程实现问题浮出水面:
一个 35B 参数规模的大模型,为何能在只有 12GB 物理内存的手机上平稳运行,且保持极高的推理吞吐?
35B-A3B 采用 MoE(混合专家模型)架构,虽然全量参数达到 35B,但生成每个 Token 时实际参与计算的活跃参数仅约 3B。然而,在端侧部署 MoE 面临独特的工程挑战:每一层需要激活哪些专家网络,必须等待上一层的推理计算完成后才能确定。
而移动设备的 RAM 无法全量容纳所有专家的权重,绝大部分参数只能常驻在闪存(NAND Flash)中,随用随读。
此前业内的主流处理路径大致有两种:一种是“按需动态加载”,模型虽能运行,但因频繁等待 I/O 读取,解码速度慢到无法满足实时交互;另一种是“整段对话锁定静态子集”,虽然减少了 I/O 读盘频次,但模型可选的专家多样性受限,推理表现难免出现明显折损。
MiniCPM-V 4.7 旨在同时兼顾运行速度与全量精度。在实际工程落地中,还进一步解决了开发者的定制痛点——模型在学习下游业务新技能的同时,通用能力不发生灾难性遗忘。
在解码加速优化方面:
前瞻专家调度(LES)将专家预取、计算管线调度与权重存取策略进行了端到端的协同优化:明确了何时搬运、计算时序以及数据粒度。
研发团队发现了一个重要特质:大模型相邻网络层之间的输入特征通常具有极高的相似度。因此,在当前层执行矩阵计算的同时,即可将其路由特征提前输入至下一层的路由模块,预先推断下一层大概率调用的专家集合,再由异步后台线程提前将对应权重从闪存读取至内存。
待下一层真正执行前向计算时,绝大部分所需专家权重已就绪。实测数据显示,该方案能够提前预判并准备超 80% 的所需专家权重,且整个过程无需任何额外的模型训练开销。
计算流水线也进行了针对性重构:**实际路由命中且已预载完毕的专家优先计算,其余所需专家并行加载。**最大程度实现了“计算-I/O”重叠隐藏,显著降低处理器等待数据的空闲耗时。
这项设计的一个核心优势在于:预调度机制仅负责数据搬运与计算顺序编排,最终每个 Token 激活的专家组合仍严格遵从原生路由判定。未命中预测的专家会正常走补载与计算流程,绝不为了单维度的提速而牺牲推理精度。
另一重优化来自模型权重的量化压缩。通过逐层混合精度量化策略,团队在几乎无损模型性能的前提下,大幅缩小了专家权重体积,显著压低单次加载的数据吞吐;同时重构了权重的物理存储布局,消除碎片化寻址,实现高效率的顺序连续读取。
压缩数据吞吐、优化读写路径,叠加前瞻预测与双工并发机制,全方位缓解了端侧硬件在存储容量与总线带宽上的瓶颈。
在配备 16GB 内存的 iPad Pro(M4 芯片)上,前瞻专家调度技术带来了最高达 5 倍的解码吞吐提升。
此外,团队还训练了专门的 DSpark 推测草稿模型,并无缝集成至 llama.cpp 等主流端侧推理框架。草稿模型先行投机生成多个候选 Token,再交由主模型批量验证接收,进一步提速生成。在搭载 16GB 统一内存的 M5 Mac 平台基准测试中,解码吞吐平均额外提升了 17%。
视觉编码端的开销同样得到了针对性裁剪。MiniCPM-V 4.7 沿用了 LLaVA-UHD v4 的 ViT 内早期特征压缩技术,在视觉编码器内部前置聚合 Visual Token,大幅削减了后续网络层的计算负担。开发者可按需在 4 倍和 16 倍压缩比之间灵活切换,实测在 16 倍高压缩下模型精度几乎保持无损。
多项优化技术的深度融合,最终达成了面壁智能所强调的端侧“快上加快”。
除了推理延迟,开发者在业务微调中还普遍面临模型“灾难性遗忘”的困扰:下游任务微调往往会导致模型原本的通用基础能力明显下滑。
为此,面壁智能推出了自回放微调技术(Self-Replay Fine-Tuning)。其核心逻辑在于:在微调启动前,先由基模针对覆盖其原有核心能力的题库进行推理作答,筛选出高置信度的高质量回复,并将这些“自生成回放样本”按比例混入下游新任务的训练集中。模型在吸收新知识的同时,持续复习已有通用知识,大幅抑制泛化遗忘。
这类“复习语料”直接源自模型自身的输出分布,与其原生的表达范式高度契合。整套流程完全复用标准 SFT 流程,无需改动底层模型架构或定制复杂损失函数。更重要的是,回放数据集仅需构建一次,即可在多次多任务微调中反复复用。
相较于在线强化学习(Online RL)或策略内蒸馏(On-Policy Distillation)等每次训练均需高频动态采样的高算力开销方案,自回放微调将定制新能力的算力与工程成本压低至普通监督微调(SFT)水平,同时有效保留了模型的通用综合能力。
当大模型不再挑剔终端硬件
回到消费电子与移动计算生态层面:
2026 年,端侧 AI 正在迎来大规模装机落地阶段。据 IDC 预测,今年中国新一代 AI 手机出货量将达 1.47 亿台,同比增幅达 31.6%,行业渗透率将首次跨越 53% 大关。这意味着每售出两部新机,就有一台具备深度端侧 AI 处理能力。面壁智能 CEO 李大海亦曾指出,2026 年是端侧 AI 实现规模化落地的关键元年。
然而对智能硬件厂商而言,硬件物料成本(BOM)是绕不开的现实制约。
随着内存价格持续波动走高,12GB 已逐渐成为 AI 手机的基线门槛,主流旗舰机型全面普及 16GB,部分高端机型甚至探索至 24GB 规格。模型能力的提升传统上依赖于内存容量的堆砌,而高昂的存储成本显著阻碍了大模型在全系机型上的普及下沉。
因此,以更小的内存占用驱动更大参数量、更强性能的模型,对终端厂商而言具备极高吸引力。在配备 12GB 内存的 iPhone 17 Pro Max 上,35B-A3B 仅需占用约 3GB 内存即可流畅运行,剩余的充足运存空间完全可以留给操作系统与其他前台重载应用。
从长远来看,端侧 AI 的竞争格局正在发生演变。如果说早期阶段核心比拼的是底层芯片制程与峰值算力(TOPS),那么未来,端侧大模型、底层算法与推理引擎软硬件的高效协同,将成为拉开实际体验差距的核心分水岭。
在落地生态方面,MiniCPM-V 4.7 提供了广泛的多平台兼容支持:全面覆盖 iOS、Android 及 HarmonyOS 系统,并在开源首日即完成了对瑞芯微、后摩智能、Intel、AMD 以及 Arm 等主流计算架构的适配迁移。推理引擎生态适配方面,已全面支持 SGLang、vLLM、llama.cpp 与 Ollama;在微调与量化工具链上,不仅支持 SWIFT 与 LLaMA-Factory,还同步提供了 GGUF、AWQ、GPTQ 及 FP8 等多种量化版本。
这一技术演进路径的底层支撑,是面壁智能与清华大学联合提出的“大模型密度定律”:大模型的能力密度约每 3.5 个月实现翻番,达到同等智能水平所必需的有效参数量正在快速降低。截至 2026 年 9 月,MiniCPM 系列开源模型的累计全球下载量已正式突破 5000 万次。
将高水平、高性能的多模态大模型装入随身口袋并流畅交互,正在成为常态化的现实。