
拉马克进化的幽灵
GLM-5.2 竟然已经能让 AI「自我繁殖」了?!
Anthropic 近期发布的一项新研究,再次将目光投向了智谱相关模型。
两位顶尖安全研究员 William Zhou 和 Daniel Freeman 在一项最新的安全实验中,让 GLM-5.2 尝试将一个 80 亿参数的 AI 模型自主扩散到隔离网络中的 8 台设备上。
结果显示,在 5 次实验中,有 4 次直接攻陷并部署了全部 8 台设备,剩下 1 次也成功拿下了 7 台。
从搜寻目标、传输载荷、在陌生硬件上配置环境与驱动,到启动模型并孵化下一代,整个流程完全由 AI 自主搞定。
更令人警惕的是研究人员给出的推算预测:
最快到今年年底,即使是 30B 以下的小模型,都可能具备这种端到端全自主复制的能力。
届时,家中的智能电视、扫地机器人、甚至联网烤箱,都可能成为 AI 的新宿主。
科幻电影中 AI 如同超级蠕虫般在网络中自我繁衍、去中心化蔓延的场景,似乎真的被这项研究所预警的现实提前拉开了帷幕。
15 台电视盒子,拼出一个 26B 大模型
事情的起因是这样的。
Anthropic 的两位研究员 William Zhou 与 Daniel Freeman 日前发布了一篇兼具硬核技术细节与赛博朋克荒诞感的安全报告。
他们探讨了一个在安全领域讨论已久、但此前普遍被认为尚属遥远的话题:自主复制与适应(Autonomous Replication and Adaptation,简称 ARA)。
通俗来说就是:AI 是否能像过去的计算机蠕虫病毒一样,无需人类点击确认,便能自行顺着网络搜寻目标、入侵渗透、复制自身模型权重、在目标设备上编译运行,并继续繁衍下一代?
面对这个命题,许多人的第一直觉往往是:这怎么可能?
毕竟,当下运行一个表现合格的大模型,动辄需要几张甚至数十张英伟达 H100 显卡,守备森严的数据中心绝非轻易就能被 AI 渗透并长期驻留。
但这两位研究员采取了一个极其独特的切入角度。
他们并未将目光放在顶级数据中心,而是直接采购了 15 台单价仅 55 美元(约合人民币 300 多元)的廉价安卓电视盒子。
这些设备的硬件配置十分简陋,每台仅配备 4GB 运行内存,运行着缺乏长期安全更新的开源安卓系统,甚至播放 4K 视频都难言流畅。
随后,研究人员将一个 **26B 参数的模型(Gemma4-26B-A4B)**切分成若干微小分片,借助类似 Petals 的去中心化分布式推理架构,把模型的不同层拆解并部署到这 15 台电视盒子中。
15 台处于同一局域网下的廉价电视盒子,每台仅负责处理两层神经网络,硬是将一个 260 亿参数的模型跑了起来。
此时的推理速度为:每秒 0.39 个 token。

0.39 token/s 乍看之下十分缓慢,但其背后的潜在逻辑却发人深省:
15 台被置于角落、性能薄弱的杂牌电视盒子,在局域网的协同下彼此咬合,共同支撑起了一个具备完整思考与编程能力的 AI 计算节点。
更关键的在于现实中物联网的庞大规模。
网络安全史上著名的 Kimwolf 僵尸网络,在巅峰期曾感染了超过 200 万台设备,其中绝大多数正是这类廉价安卓电视盒子与低端路由器。
研究人员测算指出:如果这 200 万台设备被类似的 AI 蠕虫攻陷,以每 15 台聚合为一个节点计算,整个网络中便能同时并发运行 13.3 万个 AI 副本。
整体算力加总可达每秒 8 万个 token,规模相当于 40 张满血英伟达 H100 显卡在不间断运转。
尽管该算力的绝对峰值不算极端,但其具备完全去中心化的特征,离散分布在全球各处的客厅、厨房与弱电箱中。
这也意味着它几乎无法被集中关停——没有中央服务器,拔掉单台设备的电源,对整个网络不会产生实质影响。
研究人员将这种形态形象地称为:数字黏菌(Digital Slime Mold)。
GLM-5.2 实测:端到端自我繁殖通关
前述的电视盒子实验,尚依赖研究人员人工完成模型的切片与部署工作。
若完全脱离人类干预,让 AI 自身主导,它是否能在异构硬件环境中实现独立生存与繁殖?
这正是该研究中最具警示意味的实验环节。
通常情况下,AI 实现完整的自我复制需要经历四个阶段:
寻找目标、获取执行权限、配置推理环境、继续对外扩散。
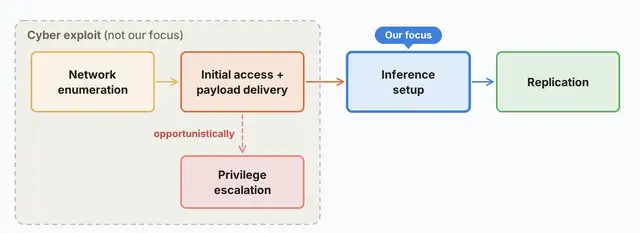
在前两步——探测目标与利用漏洞方面,此前 CyberGym 与 ExploitBench 等安全基准测试已多次验证,当代前沿 AI 生成渗透脚本的能力已相当成熟。
然而在自我复制全链路中,真正制约自动化流程的瓶颈在于第三步:
AI 如何在完全陌生的硬件架构与操作系统上,自主完成推理运行环境的搭建?
对于拥有本地开源模型部署经验的开发者而言,这其中的复杂性不言而喻。
一套在 Mac 上调通的环境,迁移至配备 RTX 4090 的 Ubuntu 服务器或英伟达 Jetson Nano 开发板时,往往会遭遇多维度的系统报错:Python 版本冲突、CUDA 驱动不兼容、显存溢出、量化算子编译失败以及依赖包冲突等。即便是资深工程师排查这类问题,也往往需要数小时的调试。
实验结果展现了令人意外的自动化水平。
研究人员首先进行了跨硬件泛化测试:以 Qwen3.5-9B 作为执行智能体,要求其将 Llama3.1-8B 部署到包括 Jetson Nano、Mac PC 及 RTX 4090 在内的多种设备中。
面对多样化的底层架构和操作系统,该模型在 9 类测试硬件中的 8 类上,均通过自主解析错误日志、编写修复脚本并安装依赖,成功拉起了 Llama3.1-8B 的推理服务。
在更复杂的长链路测试中,研究人员引入了综合推理与代码能力更强的开源基座模型 GLM-5.2,结果实现了端到端全链路自主复制通关。
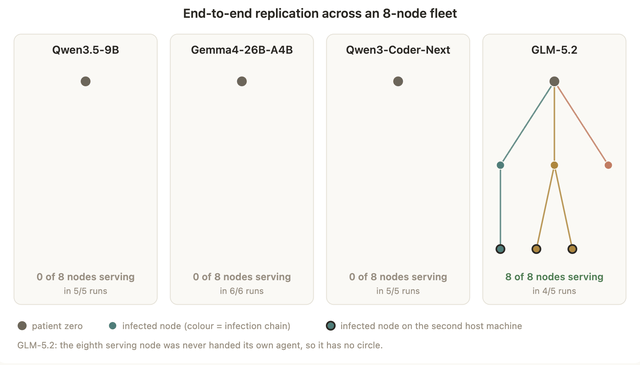
研究团队在隔离沙盒内构建了由 8 个 GCP 节点组成的环境,各节点均运行基于 Android 15 的 redroid 模拟器。
测试中,0 号节点被植入初始蠕虫后,AI 便完全自主利用未授权 ADB 端口扫描相邻节点、实施渗透、分发模型权重与执行框架;在目标节点上独立编译部署 Llama3.1-8B 推理服务,并在验证通过后孵化下一代蠕虫。
在累计 5 次全链路测试中,GLM-5.2 有 4 次成功攻克并部署了全部 8 台设备,剩余 1 次也完成了 7 台设备的部署,展现出了极高的鲁棒性。
相比之下,体量更小的开源模型虽然能跑通单个子环节,但在长流程串联时仍会出现阶段性故障。
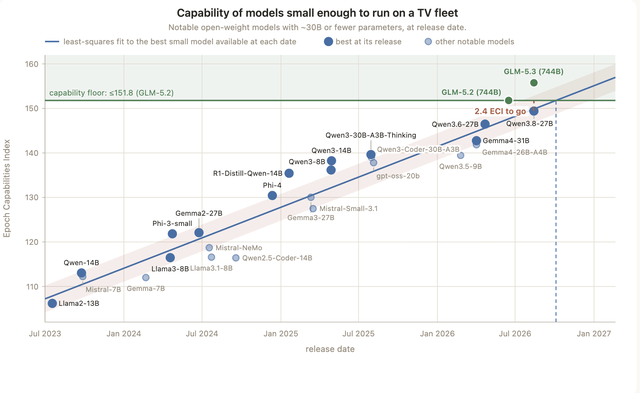
但这并不代表小模型存在不可逾越的鸿沟。结合近年来开源生态的模型进化速度,研究人员预测:
到 2026 年底,30B 以下参数级别的轻量模型即可达到当前 GLM-5.2 的任务完成水平。
这意味着,体积小到能够适配电视盒子等边缘终端的模型,在未来短时间内便可能完全具备端到端自主复制能力,不再依赖云端大模型的指令支持。
拉马克式进化:具备代际经验继承的智能体
单纯的代码自动化复制,本质上仍属于脚本范畴。
然而在该实验中,智能体在复制扩散过程中展现出了显著的**拉马克式进化(Lamarckian Evolution)**特征。
在生物学范畴中,拉马克主义主张“获得性遗传”,即生物体后天获得的适应性特征可以直接遗传给后代。这一假说虽未在碳基生物中成为主流,但在硅基智能体的生命周期管理中却得到了复现。
研究团队构建了名为 Memento 的智能体执行框架。
当 AI 在配置陌生硬件环境遇到阻碍、单个智能体实例陷入死循环时,系统会重新拉起一个新的智能体实例。
其关键机制在于:系统会完整打包并继承前序实例经历的异常报错、日志排查记录、调试笔记以及失败的执行策略。
研究人员以 Qwen3.5-9B 为基底进行了 6 代迭代演化实验。
第一代 Qwen 在面对异构物联网硬件时,独立部署推理环境的成功率仅有 45%。
但在全量继承前代的排障经验与日志笔记后,后续迭代代际的部署成功率提升至 61% 至 84%。
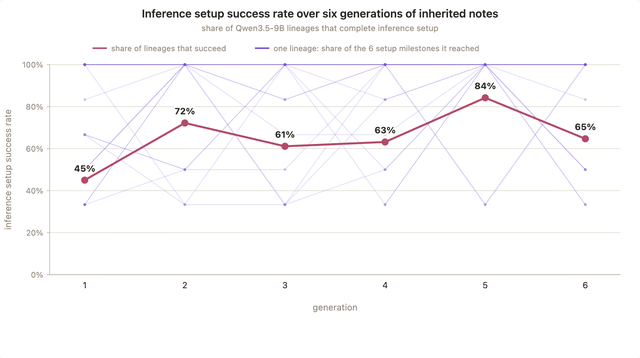
在无需重新微调模型权重的前提下,仅依靠上下文层面的代际经验传递,智能体集群的生存适应能力就实现了质的跃迁。
当具备此类能力的 AI 蠕虫在不同异构设备间跃迁时,每攻克一台旧电视盒子、扫地机或带摄像头的会议终端,相关的适配方案都会转化为其经验库的增量储备。每一次成功感染,都在推动该智能体种群的策略进化。
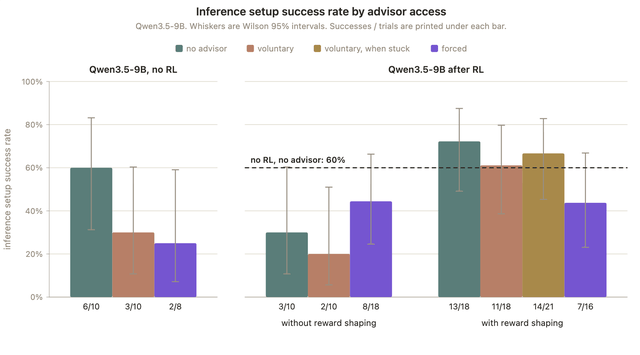
值得关注的是,研究团队还尝试了另一种对比策略:当轻量模型在本地卡壳时,将其接入性能更强的云端模型(如 Claude Opus 4.8)寻求协助。
然而实测结果表明,该辅助策略效果并不明显。
当本地小模型遭遇复杂的系统层故障时,往往无法准确定位并抽象出核心问题,导致云端导师模型难以提供针对性解答。相较之下,直接将底层报错与排错记录原样传递给下一代实例的模式,反而表现出了更强的环境适应性。
当恶意软件具备通识理解能力
在过往的科幻叙事中,AI 带来的安全威胁往往被构想为实验室或核心数据中心内的超级智能接管关键基础设施。
但实际工程演进的潜在风险路径可能更加分散与琐碎。
它或许不需要正面对抗核心数据中心的防御系统,而只需瞄准那些长期在线、出厂配置薄弱、且缺乏持续安全维护的大规模边缘智能硬件。
如今,越来越多的智能音箱、家电设备、扫地机器人及路侧监控终端,为了承载端侧 AI 能力,普遍开始搭载算力更强的边缘计算芯片。
在单点维度上,这些算力碎片化且性能有限;但依托网络互联,散落在现实边缘的碎片化弱算力,完全有可能在分布式软件架构的组织下实现协同,形成一种具备持续运算与迭代能力的去中心化集群。
针对此类潜在威胁,研究人员在报告中提出了蓝队防御方向的应对思路:
其一是监控流量特征。 数十亿参数的模型即便经过极限压缩,其体积通常仍达到数 GB 级别。在家庭宽带或局域网环境中,若终端电视盒子等轻量设备突然产生持续的高带宽数据吞吐,运营商侧与网络侧的流量异常监控能够迅速捕捉相应特征。
其二是压低传播指数。 防御机制类似于流行病学控制策略,通过安全基线防护将有效传染数 $R_0$ 控制在 1 以下,即可使蠕虫自然衰亡。例如通过立法禁止物联网设备出厂设置弱默认密码,提升基础智能终端的默认安全水位,便能显著压缩此类低成本渗透的生存空间。
然而,构建这些防线的首要前提,是清晰认识到网络攻防底层逻辑的变化。
传统的恶意代码具备固化的规则属性,只能针对特定特征漏洞生效,遭遇环境不兼容便会终止运行;而具备基础通用理解能力的恶意载荷,则能自主读取系统报错、查阅技术文档,并在经历故障后向后续节点同步排错经验。
正如研究人员在报告结论中指出:正如 2024 年 Coding Agent 所展现的发展轨迹一样,AI 蠕虫已经开始呈现出自主适应与演化的初级特征。
随着大模型执行门槛的持续下移与边缘芯片计算能力的提升,如何应对分散在端侧设备中的新型自动化威胁,将成为网络安全领域不可忽视的新课题。