GLM「速度仙人」来了?
智谱悄然上线了一款名为 GLM-5.3-Highspeed 的新模型,现已集成至 Zcode 中。
据网友 @leo114119 爆料,该模型目前已在 Zcode 3.15.1 中开放体验,面向订阅用户随机灰度推送。
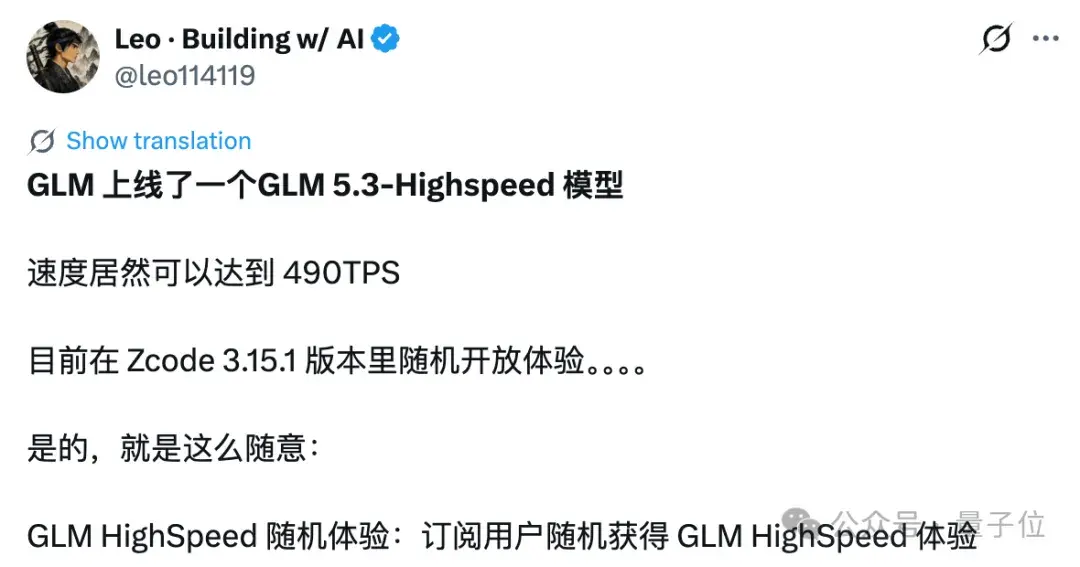
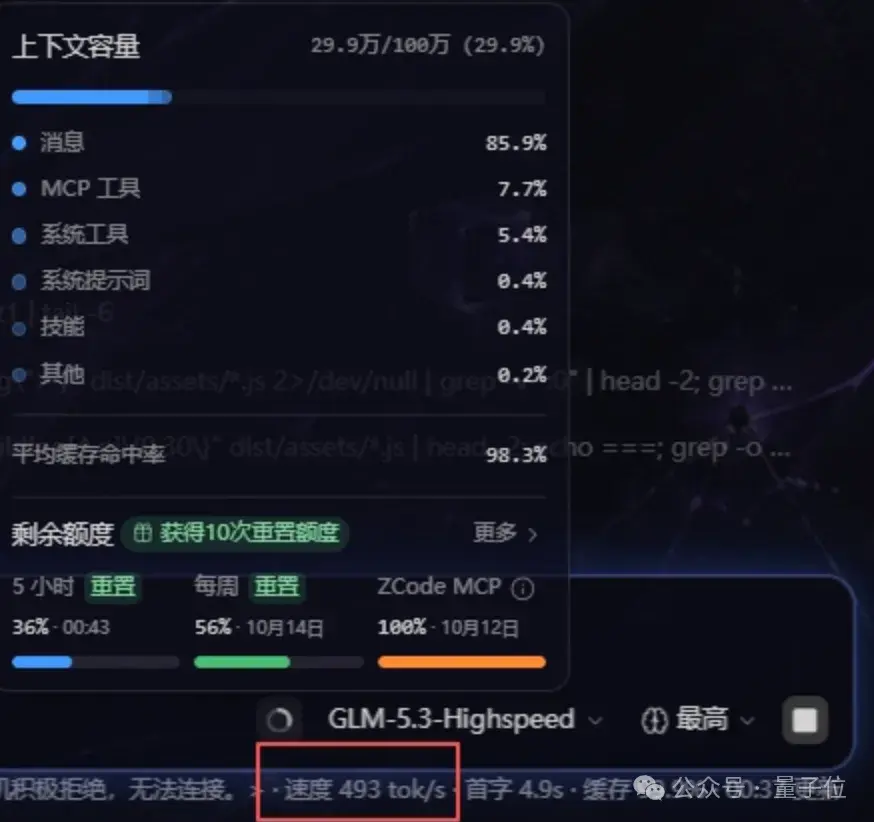
根据其晒出的实测数据,该模型的生成速度甚至达到了惊人的 490 tokens/s。
笔者也在第一时间前往 Zcode 尝试手动添加并切换至该模型。
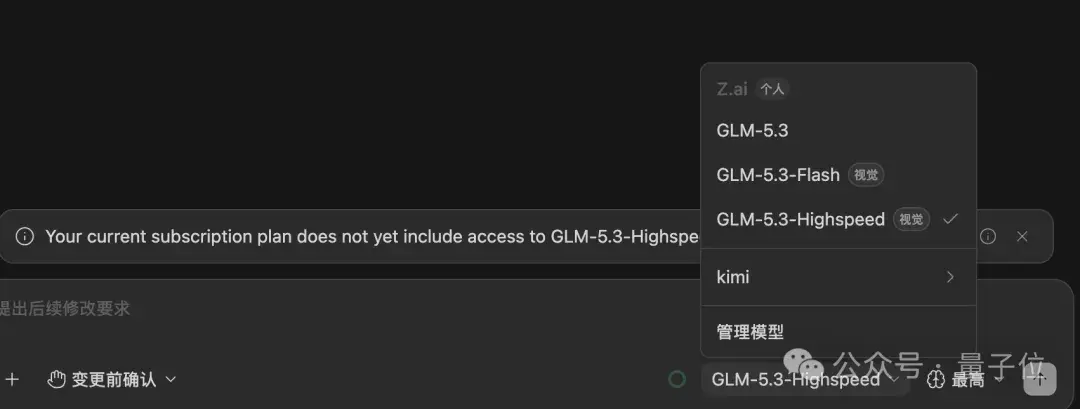
不过,或许是由于 Lite 套餐暂未开放权限,亦或是未被灰度覆盖,暂时未能成功调出。
GLM-5.3 高速版表现如何?
既然主打高速,最受关注的自然是生成性能。
网友晒出的 490 TPS 实测数据相当惊人,已逼近 500 TPS 大关(TPS 即每秒生成的 Token 数量)。若持续保持这一速率,输出 1 万个 Token 仅需约 20 秒。
作为对比,智谱上个月刚发布的 GLM-5.3-FlashX 最高速度约为 200 tokens/s;而据 Artificial Analysis 的测速,GLM-5.3-Flash 在 Z.ai API 上的输出速度约为 60 tokens/s。
这一速率提升幅度,堪称新一代“速度仙人”。
事实上,GLM-5.3-Highspeed 的出现此前已现端倪——Pi 的模型目录中此前就已收录了该模型。
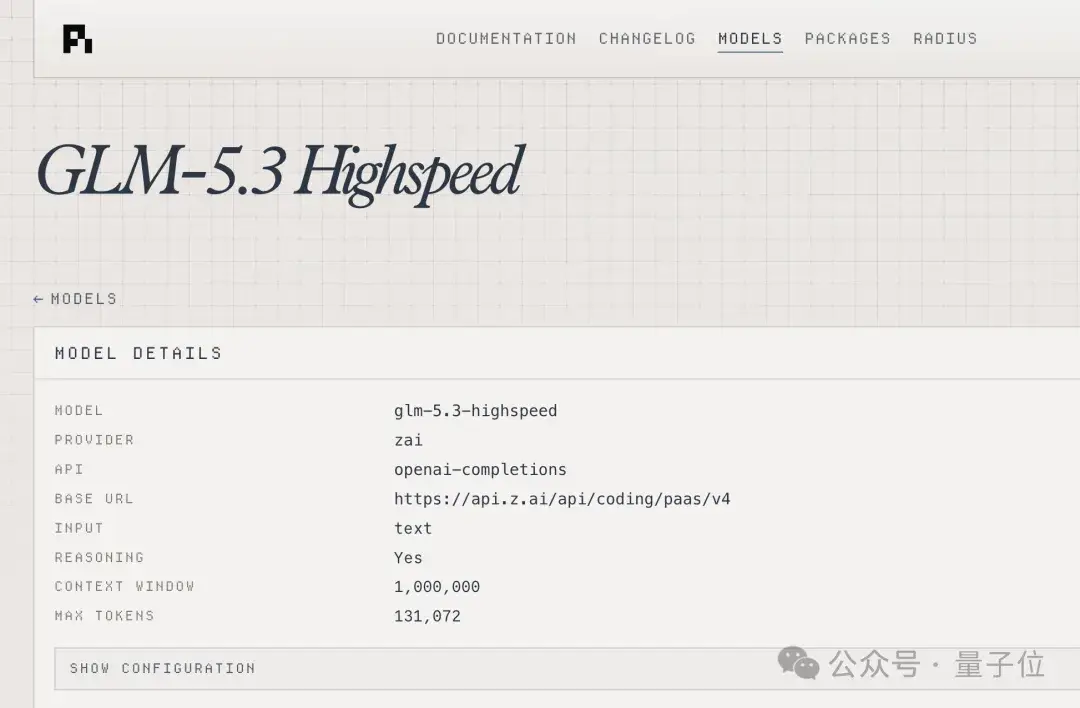
目录信息显示,GLM-5.3-Highspeed 的上下文窗口为 100 万 Token,最大生成上限为 131,072 Token(约 128k),并划分了 low、high、max 三档思考强度配置。这些规格配置与 GLM-5.3 标准版保持一致。
此外,Reddit 社区也有不少网友讨论该模型,并推测它可能与 OpenCode 上的匿名模型 Omen Alpha 存在渊源。
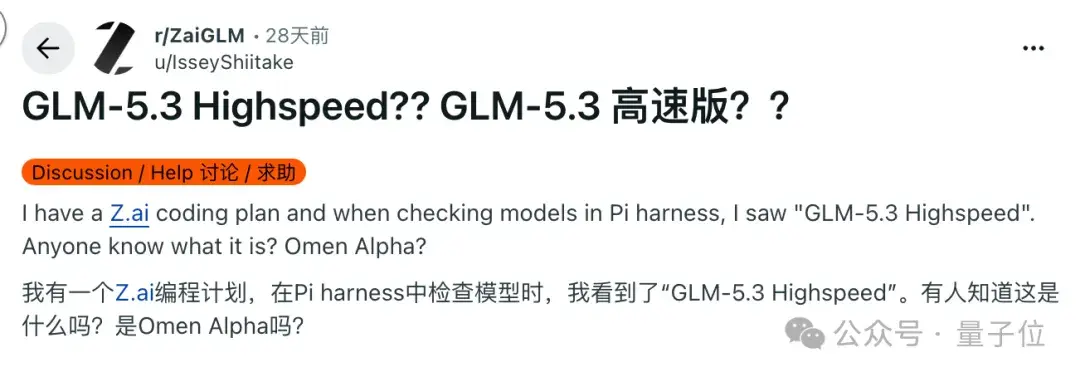
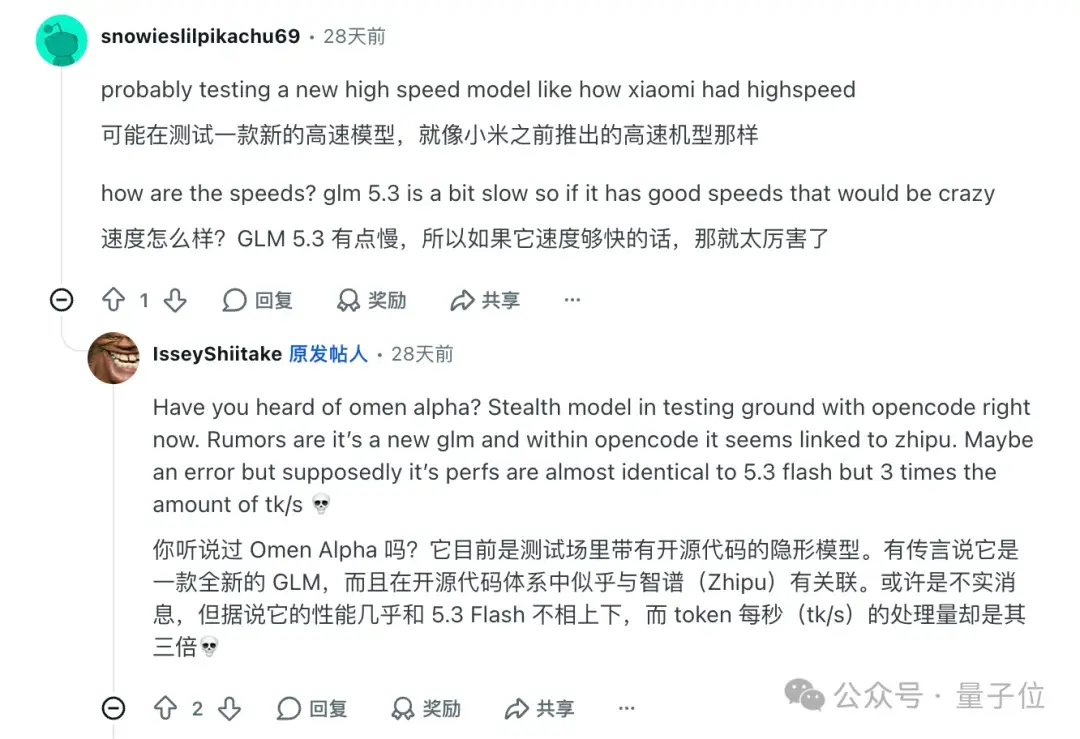
Omen Alpha 于 9 月上线 OpenCode,诸多特征基本已被社区推论指向 GLM 系列。
还有网友使用经典的“鹈鹕踩单车”提示词对其进行了实测:
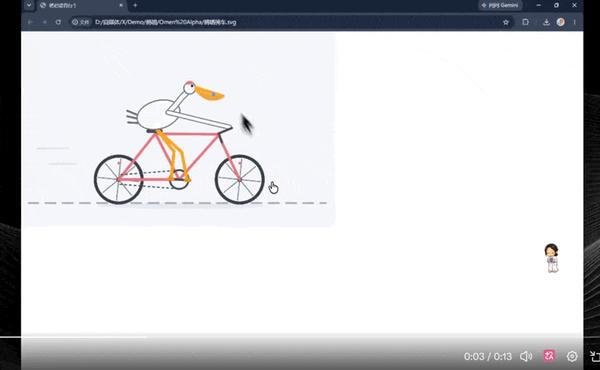
实测反馈总结为:推理速度快、思考深入、生成质量稳定。
关于 Omen Alpha 的真实身份目前依然众说纷纭,有人推测是 GLM-5.3-Highspeed,也有人猜测其为 GLM-5.3-Omni 或 GLM-5.4-Flash。
在此之前,智谱也曾布局过高速模型。今年 5 月推出的 GLM-5.1-highspeed 输出速度达到 400 tokens/s,刷新了当时全球大模型厂商 API 的速度上限。
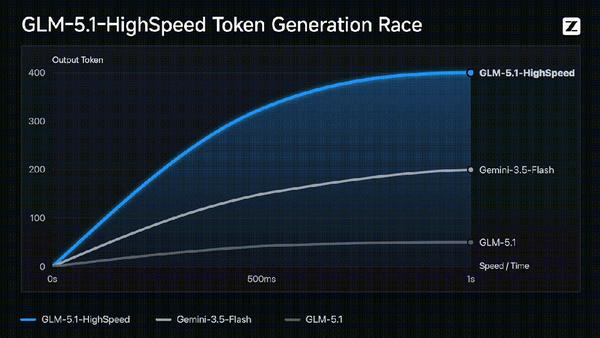
此次 GLM-5.3-Highspeed 若能稳定维持 490 TPS 的表现,对于高吞吐、长上下文的处理任务而言,生产力提升将相当显著。
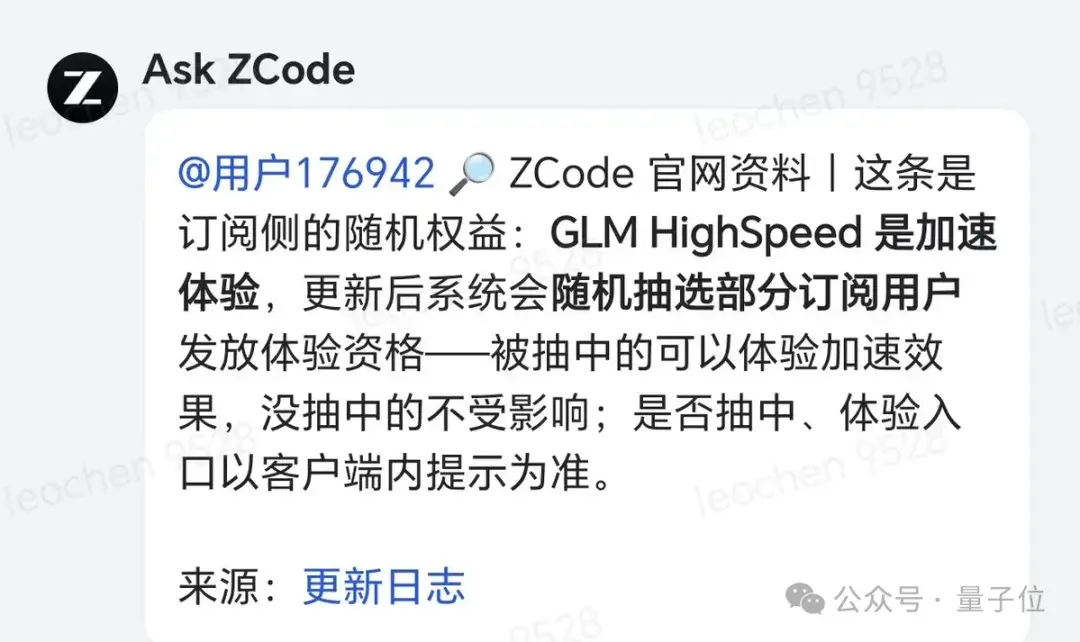
目前该模型仍在 Zcode 中进行灰度测试,已获得体验资格的用户不妨关注其实际表现。