
游戏打到21:0,AI甚至不用再调用大模型了
一边打游戏,一边给自己升级?
华为这项最新研究,直接让 AI 学会了“边玩边变强”。
由华为诺亚方舟实验室联合 UCL 等团队推出的 AI 智能体系统——Memento 3,直接通关了 ARC-AGI-3 公开数据集中的全部 25 款游戏、共 183 个关卡。
这绝非依靠暴力试错硬闯。
人类玩家完成同样关卡平均需要 17,135 次操作;而 Memento 3 仅用了 7,518 次,操作步数比人类减少约 56%,并在 RHAE(相对人类行动效率)指标上斩获 100 分满分。
更引人注目的是,该系统以 Claude Opus 5 为基座模型,全程未更新模型权重,也未针对游戏任务进行微调。
它完全依靠自主上手试玩、推导运行规则、编写代码模拟环境,并在失误时自我反思与修正,最终达成满分通关。
对比之下,Claude Opus 5 在 ARC Prize 官方标准测试框架下的平均 RHAE 仅约 40.7 分。在基座模型完全相同的情况下,仅通过这套智能体系统架构,成绩便大幅提升了 59.3 分。
不仅如此,该方法不仅适用于解谜类游戏,研究团队还将其应用于经典 Atari 街机游戏 Pong(乒乓球)。结果显示,AI 自主摸索出控制策略后,后续无需再向大模型发送推理请求,便连续三局以 21:0 零封对手。
脱离大模型实时推理,游戏为何依然能稳定运行?
核心机理正体现在本项研究的主题中:基于世界模型的递归自我改进(Model-Based Recursive Self-Improvement)。
华为 AI 通关 25 款游戏,操作次数比人类减少 56%
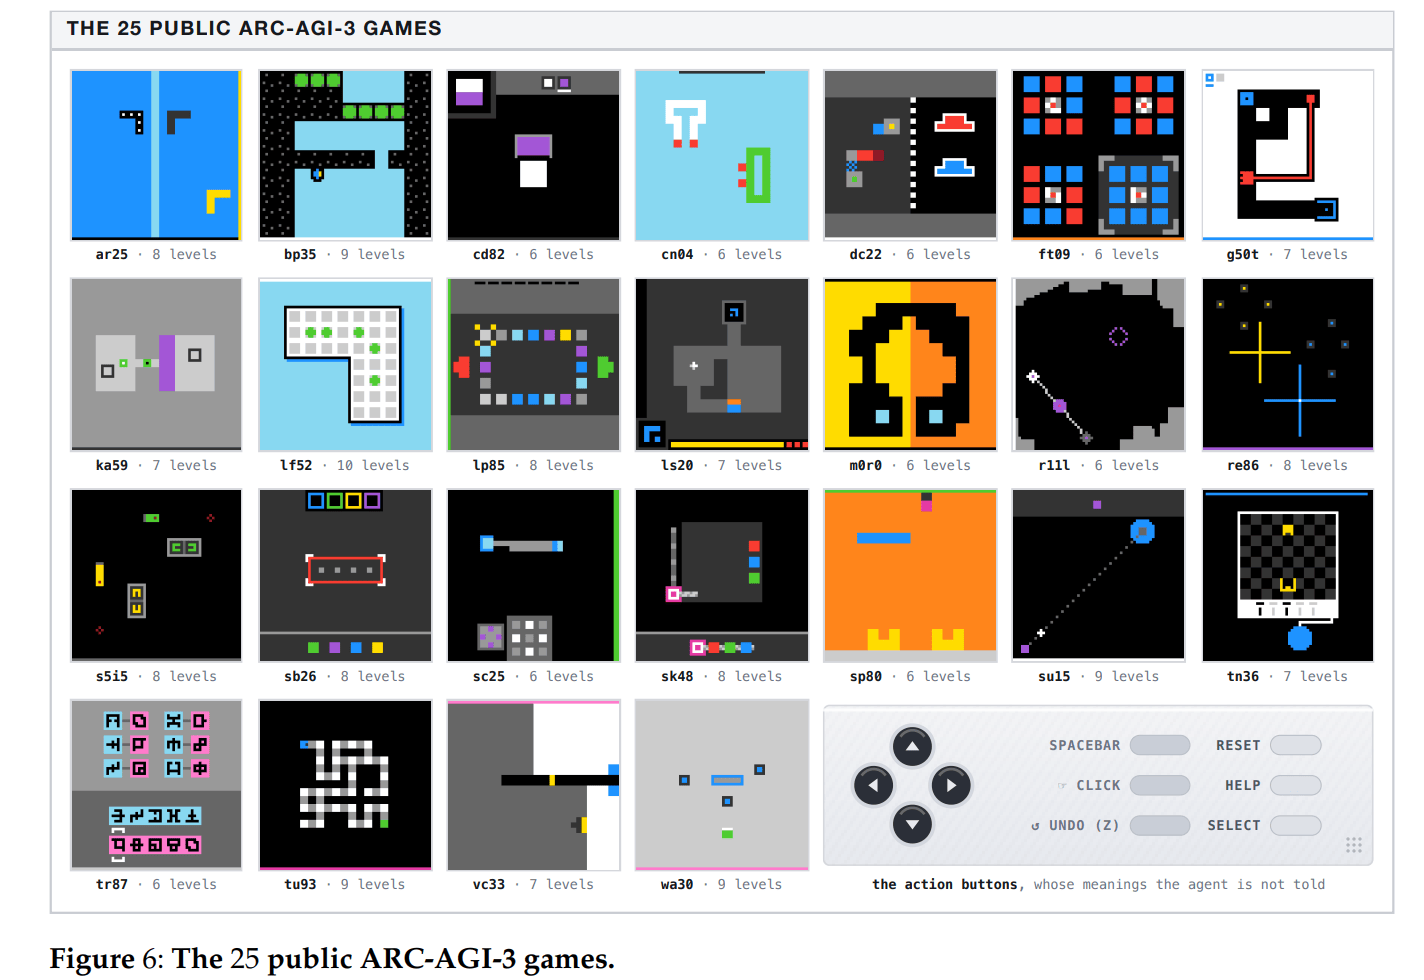
这 25 款测试游戏出自 ARC Prize 推出的 ARC-AGI-3 评测基准。与前代 ARC 测试相比,这一版本呈现出根本性转变:
不再局限于静态的“输入-输出”答题模式,而是直接将 AI 置入未知的交互式游戏环境中。
游戏规则需要 AI 自行摸索,通关目标需要自主发掘,各类操作的反馈效果也全靠试错感知。
这 25 款公开游戏共包含 183 个关卡,画面大多由简单的像素、网格、色彩与几何图形构成,风格类似复古微型游戏。
然而简朴的画风之下,隐藏着极高的推理难度。对 AI 而言,动作控制并非难点,最棘手的是环境运转机理完全未知:踩踏特殊地块会引发什么连锁反应?门无法开启是因为颜色不符还是几何形状不匹配?更严峻的是,后续关卡还可能引入全新机制,甚至彻底颠覆此前建立的规律。
即便对人类玩家而言,这类游戏也极具挑战性。
ARC Prize 测试数据显示:在需要控制变形虫移动与变色的益智游戏 r11l 中,10 名测试者全员通关;但在考验符号破译机制的解谜游戏 tr87 中,12 名挑战者仅有 6 人成功通关。
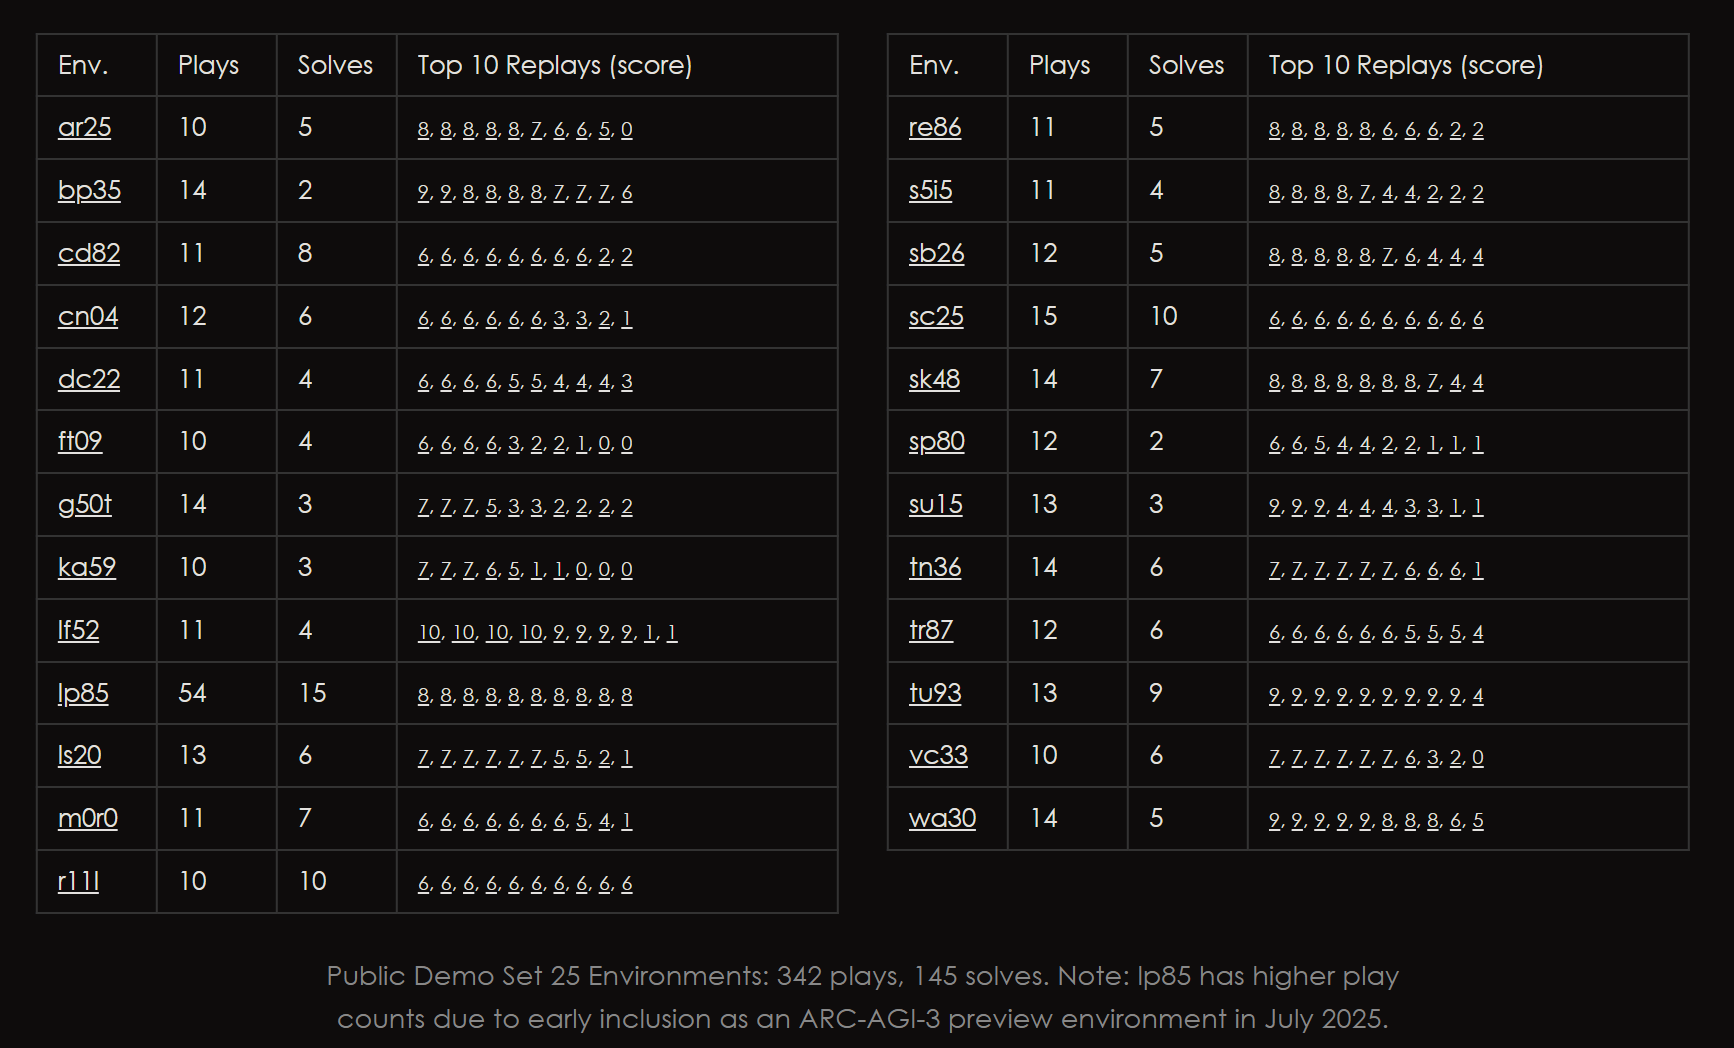
此前,各研究团队在该赛道上的竞争已十分激烈:
- 普林斯顿大学推出的 Continual Harness 仅通关 3 款游戏,取得 20.5 分;
- 英伟达研究人员参与研发的 DreamTeam 通关 6 款,得分为 38.1 分;
- 独立研究者 David Courtis 开发的 OPINE-World 与英伟达团队的 NOOA,分别取得 78.4 分和 85.1 分;
- 独立开发者 Sergey Rodionov 打造的 baseline1 表现尤为突出,通关全部 25 款游戏,斩获 99 分,距满分仅一步之遥。
而华为联合团队的 Memento 3,则填补了这最后 1 分的差距。
Memento 3 不仅以 100 分满分通关全部 25 款游戏、183 个关卡,更将总操作步数压缩至 7,518 次,相比 baseline1 的 8,347 次减少了 829 次,实现了通关率与行动效率的双重超越。
它是如何做到的?
无需微调大模型:以代码为媒介构建自我迭代机制
论文显示,Memento 3 的核心范式被称为 Code as Model(代码即模型)。
其设计思想在于让智能体在探索过程中自主构建两项核心资产:一份实时更新的规则笔记,以及一套可模拟游戏物理规律的可执行代码。
- Rulebook(规则手册):一份 Markdown 格式文档,记录 AI 推导出的环境规律,包括操作反馈、通关判定条件以及尚未明朗的边缘规则。
- Executable World Model(可执行世界模型):AI 将归纳出的规则直接编写为可独立运行的 Python 代码,相当于在内存中自主构建了一个轻量级游戏仿真模拟器。
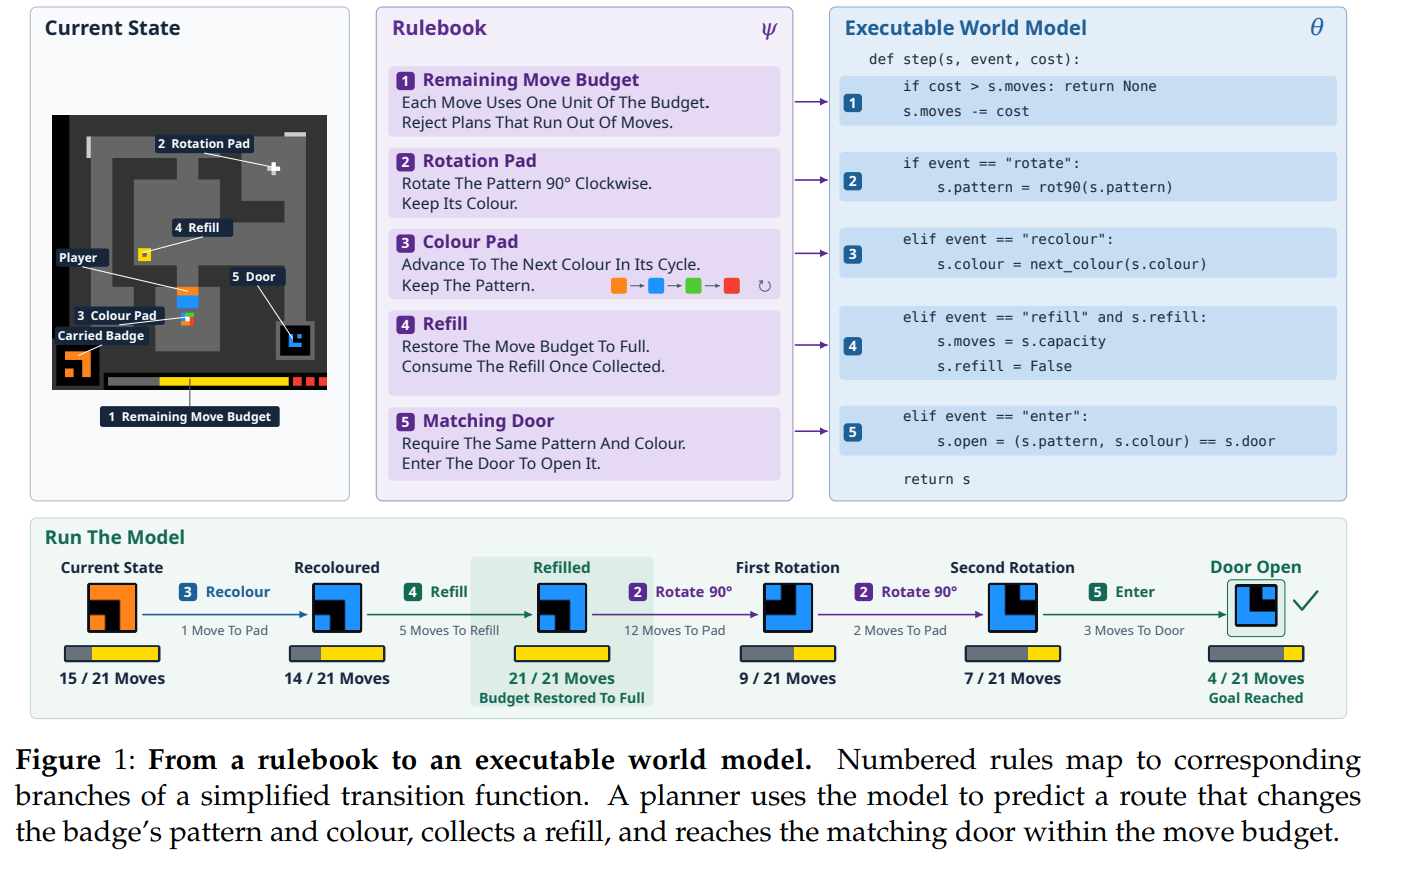
依托这两套工具,AI 能在真实执行动作前,先在代码模拟器内部进行多路径推演与剪枝,从而选出最优动作序列。
然而,若初始归纳的游戏规则存在偏差,系统该如何处理?
Memento 3 具备自省与证伪机制:一旦实际观测与模拟预测冲突,便会主动重构规则。
论文展示了一个典型案例:在某款解谜游戏中遇到特殊地块时,AI 最初推测角色踏上地块后图案会根据切入方向发生镜像翻转;但在真实执行后,系统发现图案实际上是顺时针旋转 90 度,且与进入方向无关。AI 随即修订了规则手册,并同步重写了底层的 Python 仿真代码。
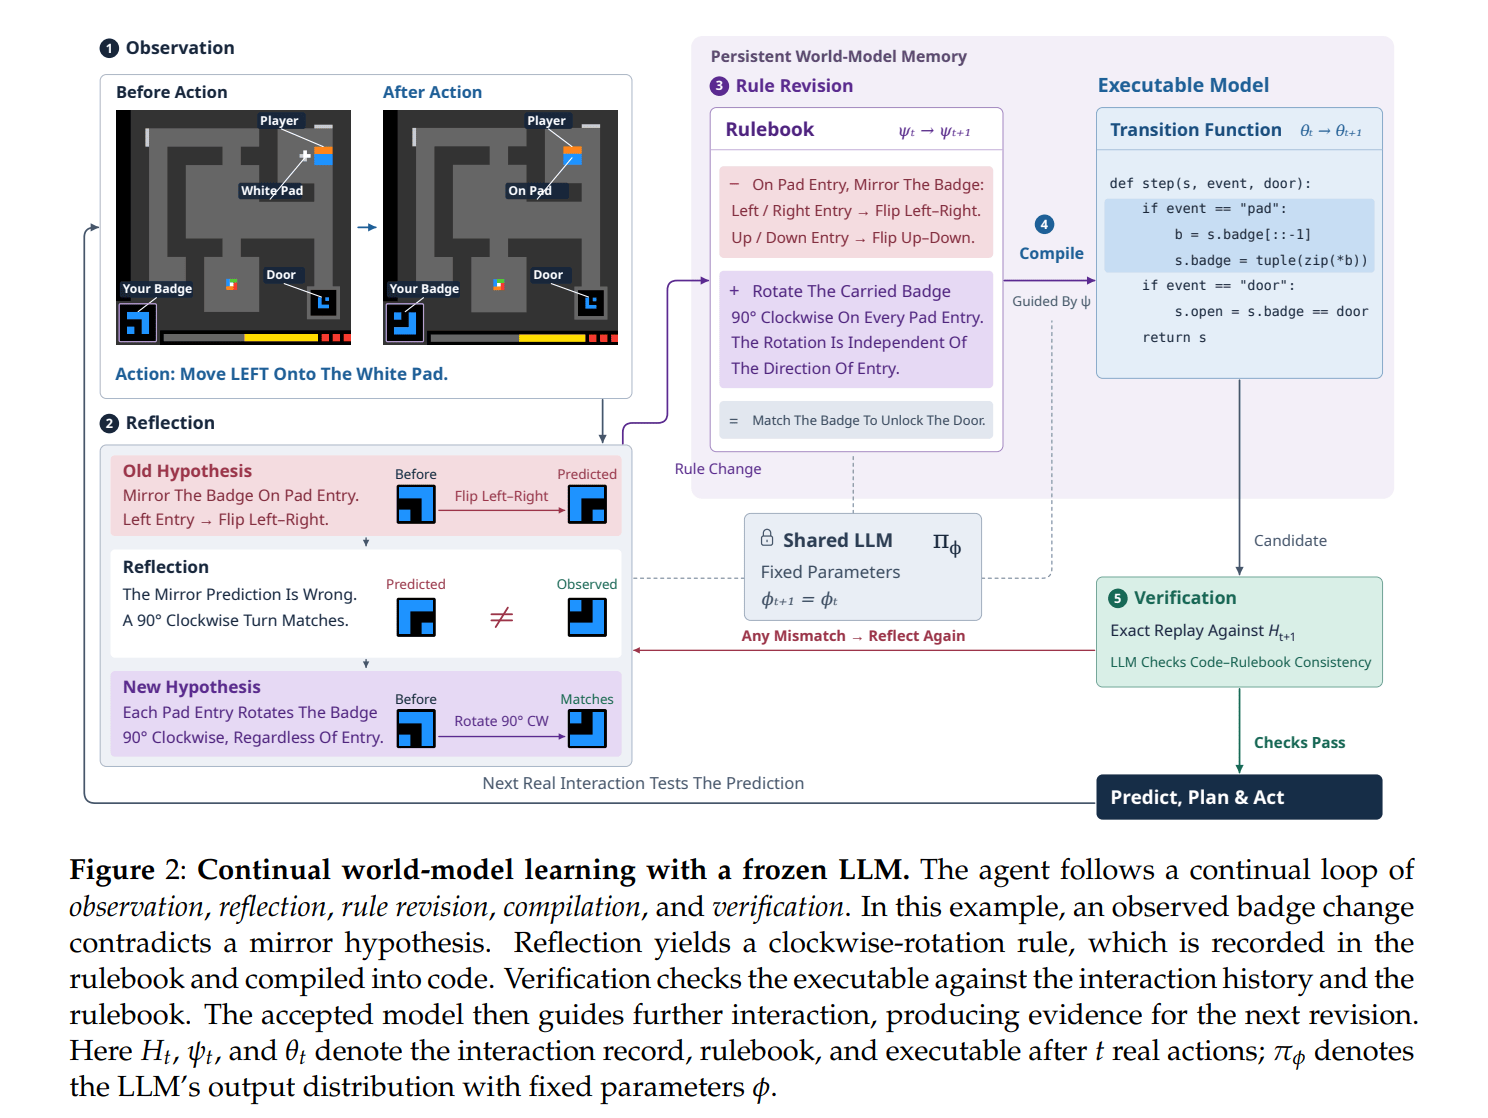
规则更新后,系统还会启动校验流程:重新回放先前的操作序列,逐像素对比 64×64 的画面状态,验证代码能否精确复现真实结果;若仍有出入,则继续微调代码逻辑,直至模拟器与真实环境严格对齐。
此外,先前关卡沉淀的先验知识能够无缝迁移至后续关卡。
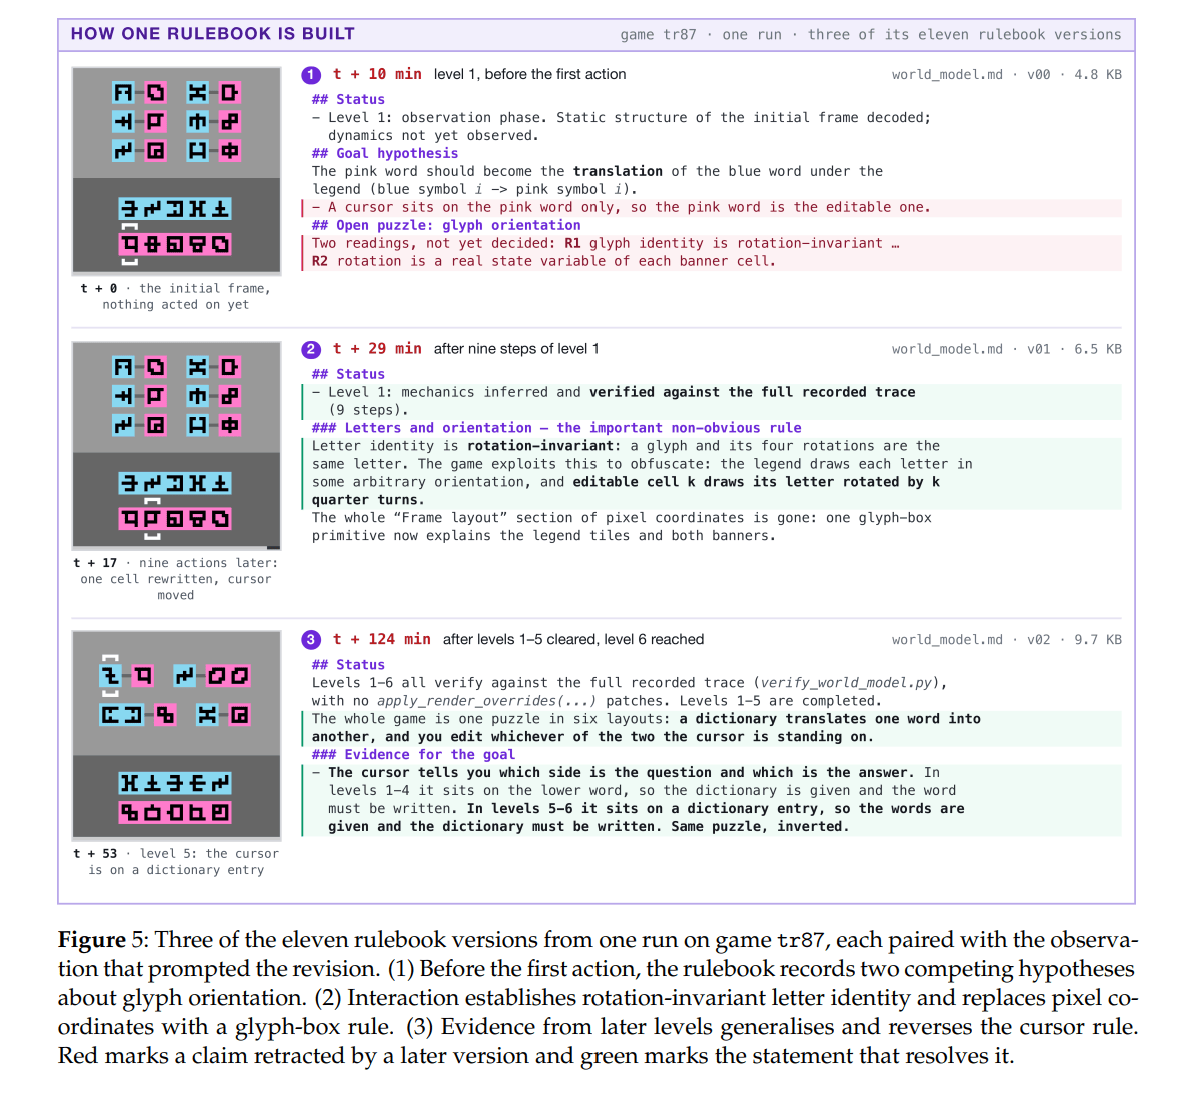
以符号解谜游戏 tr87 为例,AI 最初无法确认符号朝向是否承载语义,后续逐步摸清不同朝向符号可对应同一字母;随着新关卡出现,它又及时修正了游标位置的判定逻辑。整局游戏推进过程中,同一份规则手册共经历了 11 次版本迭代。
为保障状态可追溯性,研究团队还引入了 Git 版本控制。规则与代码的每一次改动都会生成提交记录,若后续推演出现逻辑漂移或错误,系统可回滚至历史版本重新分支探索。
这构成了研究所指的递归自我改进(Recursive Self-Improvement, RSI)闭环:在模型本体参数冻结的前提下,智能体通过持续沉淀经验、迭代规则与演化代码,实现策略表现的自主跃迁。
消融实验进一步证实了规则手册的价值:在三款游戏的对照测试中,保留规则手册时,AI 通关共消耗 617 次操作;若剥离规则手册仅保留代码世界模型,操作次数升至 677 次。规则手册使得操作步数减少约 9%,智能体交互轮次减少约 18%。
研究团队还探索了双模型架构:让 AI 并行维护两套世界模型,共享交互轨迹,但各自承载不同的规则假设与反事实推演。实验显示,在游戏 wa30 中,单模型通关需 899 次操作,而双模型架构将步数压降至 597 次,操作效率进一步提升约 34%(目前该双模型增益主要在 wa30 上完成验证,向其他环境的泛化性尚待进一步测试)。
这些结果表明:即便不重新训练或微调基础模型,AI 也能通过不断修正外部世界模型,实现自主能力的演进。
零封对手 21:0:策略固化后脱离大模型实时推理
为测试该方法在动态连续环境中的泛化潜力,研究团队将 Memento 3 置于经典街机游戏 Atari Pong(乒乓球)中。
与离散网格式解谜游戏不同,Pong 涉及球体的连续运动、反弹与碰撞预测,要求智能体在推断物理规律的同时,具备对球拍移动的实时轨迹决策能力。
测试过程展示了系统的适应能力:
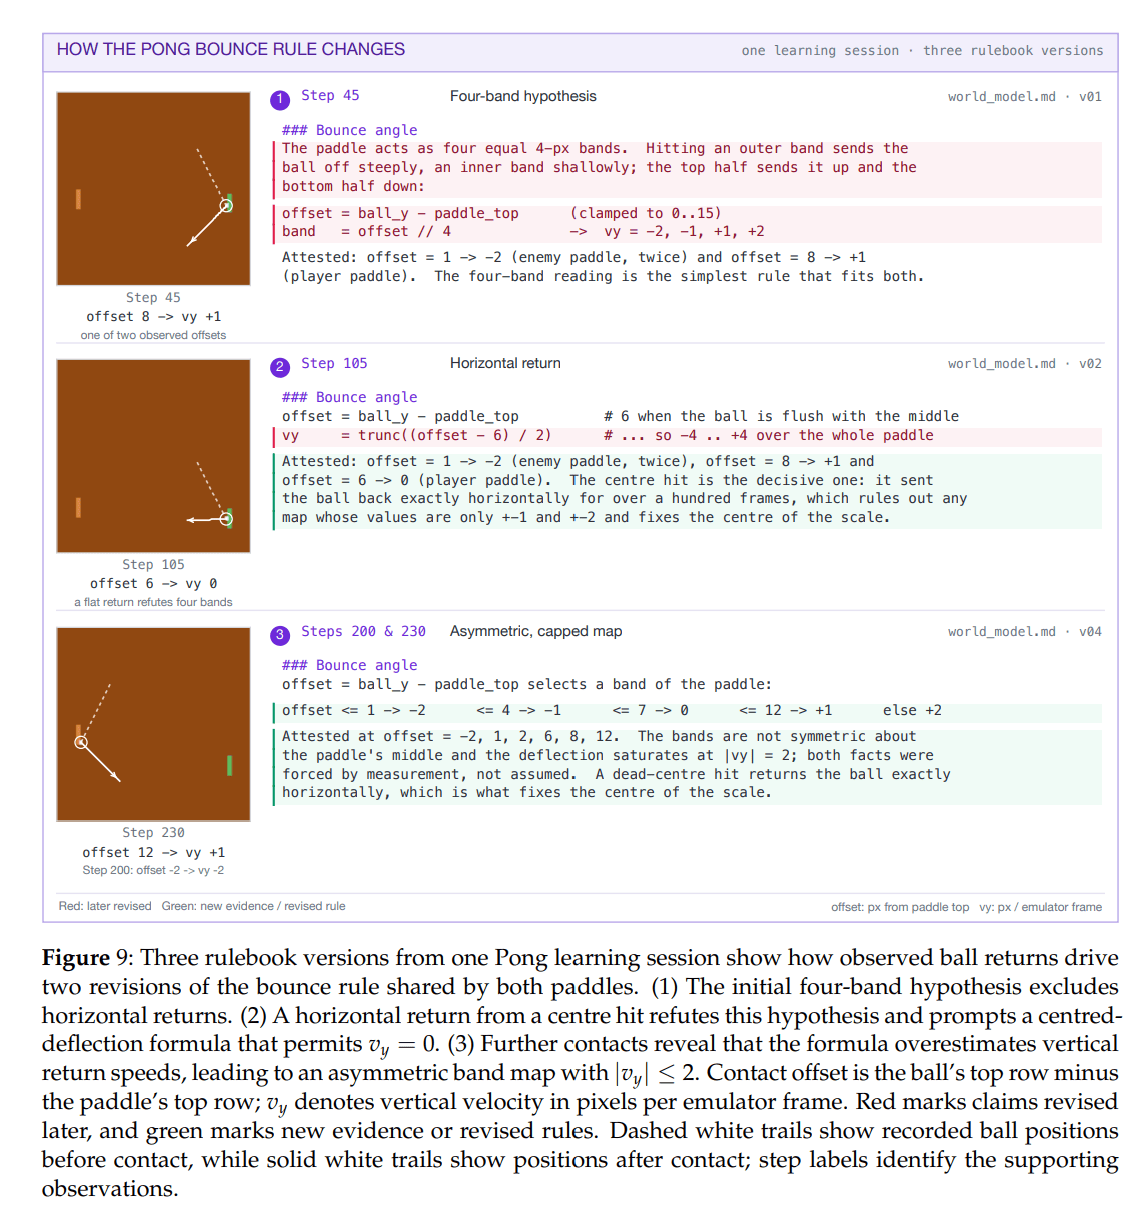
起初,AI 对小球弹跳物理定律缺乏先验认知,只能在试探中归纳规则。它最初假设球拍分为四个反射区间,不同落点决定对应出球角度;但在交互中,系统遭遇了一次水平反弹。
检测到观测冲突后,AI 重新计算碰撞点参数并重构了反弹动力学公式,随后在后续偏差中持续微调,最终拟合出贴近真实运行规律的物理模型。
当控制策略收敛并固化后,研究团队将生成的程序脱离大模型独立运行——不再调用 Claude Opus 5 接口,亦停止更新规则。
在这一离线状态下,AI 在三个不同开局设定下,均以 21:0 完胜对手。
此时,大模型已无需参与逐帧动作决策。它的定位转变为:在初期负责规则探索与策略合成,待逻辑完备后将其编译为确定性的执行代码。
对比实验显示,若不引入世界模型、仅依赖大模型逐帧根据输入图像生成动作,最终得分仅为 -19,表现接近随机操作的 -20.7。
相较于让大模型在每一步执行高成本的前向推理,先借助大模型提炼规律、再交由轻量级程序执行,展现出了更高的效率。
数据表明,Memento 3 仅需约 9,500 帧游戏画面 即可收敛出有效的控制策略;而部分传统强化学习基准通常需要数十万乃至上亿帧的采样数据。
当然,该方案依然存在开销考量:Memento 3 在探索期调用了高推理强度模式的 Claude Opus 5,代码生成、静态分析与验证过程耗费了相当规模的 Token 与计算算力。此外,当前实验场景主要聚焦于规则闭环明确的游戏沙盒,在开放、随机性强的现实复杂任务中的有效性仍有待进一步验证。
但这项工作为具身智能与通用智能体的构建提供了一个重要启示:
递归自我改进(RSI)未必依赖模型底层权重的频繁更新。通过构建可检查、可执行、可回滚的外部世界模型,参数冻结的通用大模型同样能在陌生领域中完成自我迭代与能力跃迁。