
数学2.0时代已至。
刚刚,数学界的领军人物、菲尔兹奖得主陶哲轩正式发文:
AI正在让数学证明变得泛滥,建立在“证明稀缺”之上的数学1.0时代即将落幕。
自OpenAI宣布解决纳维–斯托克斯千禧年难题以来,在AI的猛烈攻势之下,以陶哲轩为首的数学家们不仅频频公开质疑,更呼吁行业紧急刹车。
但历史的潮流滚滚向前,AI的发展趋势显然已不可逆转。
陶哲轩也并非一味充当“AI减速派”,而是向数学界抛出了一个更深刻的问题:
怎样才能让越来越多的AI证明,为人类带来更多理解、更好的训练,以及对现实世界更可靠的贡献?
以及未来,我们究竟需要怎样的数学家?
从“证明稀缺”到“证明泛滥”,数学2.0的前提变了
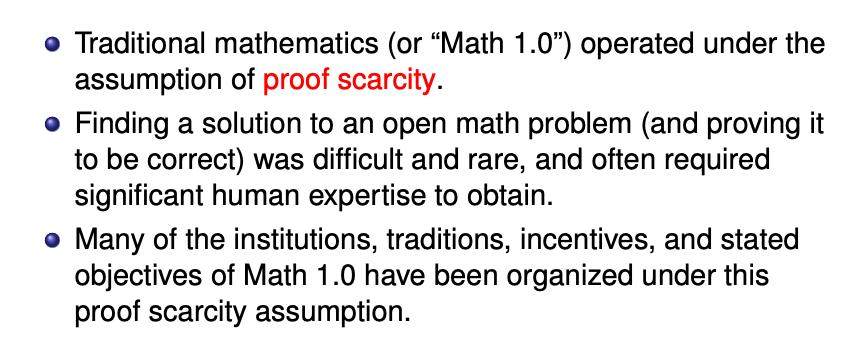
陶哲轩认为,在数学1.0时代,传统数学研究一直运行在“证明稀缺”的环境中。
为了攻克一道开放难题,研究者往往需要具备深厚的专业积累,并为此付出大量的时间与精力。因此,“谁最先解决了什么问题”,自然成为了数学界衡量学术贡献的核心标尺。
但如今,AI正在深刻改变这一环境。
无论是OpenAI一夜之间发布722篇数学论文,全面涉足准黎曼猜想、霍奇猜想、BSD猜想等重磅课题;
(详情可看:https://mp.weixin.qq.com/s/P40M32TnTppU3jsDTvFGmg)
还是将今年刚获得菲尔兹奖的王虹所解决的三维挂谷集猜想,进一步扩展至四维;
(详情可看:https://mp.weixin.qq.com/s/CDfZGoors8TmTnzSl0rszQ)
这一切都在重塑数学研究的节奏,冲击着数学1.0时代的评价体系,并迫使数学家们在联名抵制之余,重新回答一个日益紧迫的问题:
在证明之外,究竟什么才是一位数学家真正的护城河?
(详情可看:https://mp.weixin.qq.com/s/E-6A_HrJaj7P8j5TXpt_1w)
对此,陶哲轩在文中坦言:
获取解答的门槛确实降低了。
在具备充足算力、能够访问前沿模型的条件下,人们已经可以在较短时间内,获得许多此前被认为极度困难的开放问题的解答。
但如何判断解答是否严谨正确、学术贡献究竟多大,以及怎样与已有研究体系衔接,仍然需要我们认真处理。
否则将会导致一种令人担心的错位——题目被解出了,人类的理解却没有相应增加。
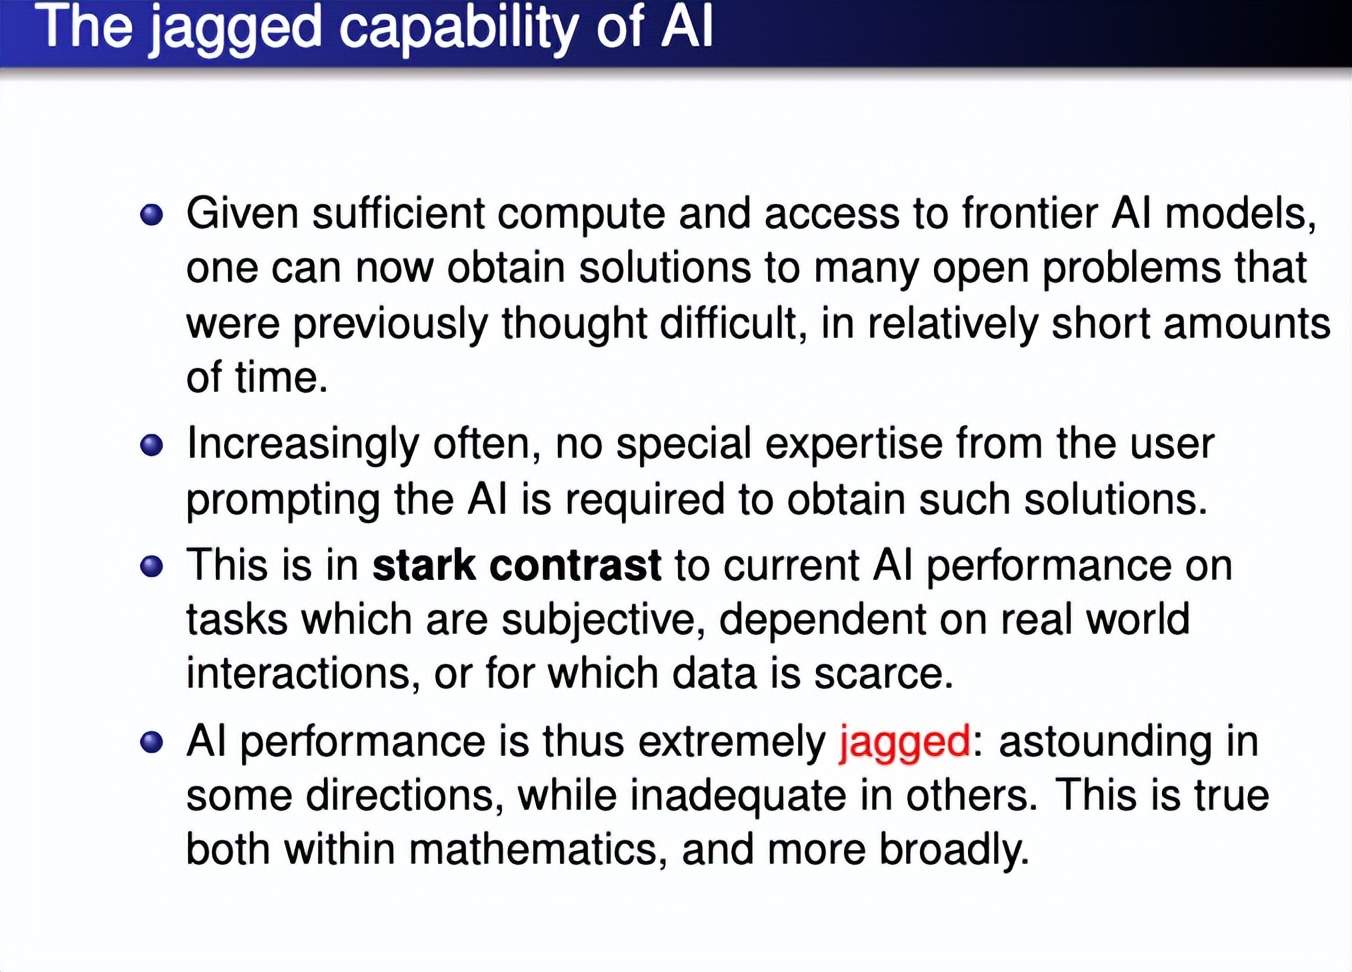
关于数学为何如此容易受到AI的冲击,陶哲轩归纳了三个相互叠加的条件:
1. 证明可以被客观检验;
2. 数学对象和推理过程高度可数字化;
3. 大量高质量的研究文献已经以数字形式沉淀。
这些条件加上前沿AI实验室的重金投入,迅速将数学推成了模型能力突飞猛进的核心试金石。
但与此同时,陶哲轩也亮出了经典的飞机弹孔图,提醒大家警惕“幸存者偏差”:
当前数学前沿的大多数问题,依然未能被解决。
AI的能力分布并不均衡,它在某些方向表现惊艳,但在另一些方向仍然不足。
AI厂商展示给外界的,往往只是精挑细选的成功案例;而大量未能成功的AI尝试,通常根本没有机会进入公众视野。
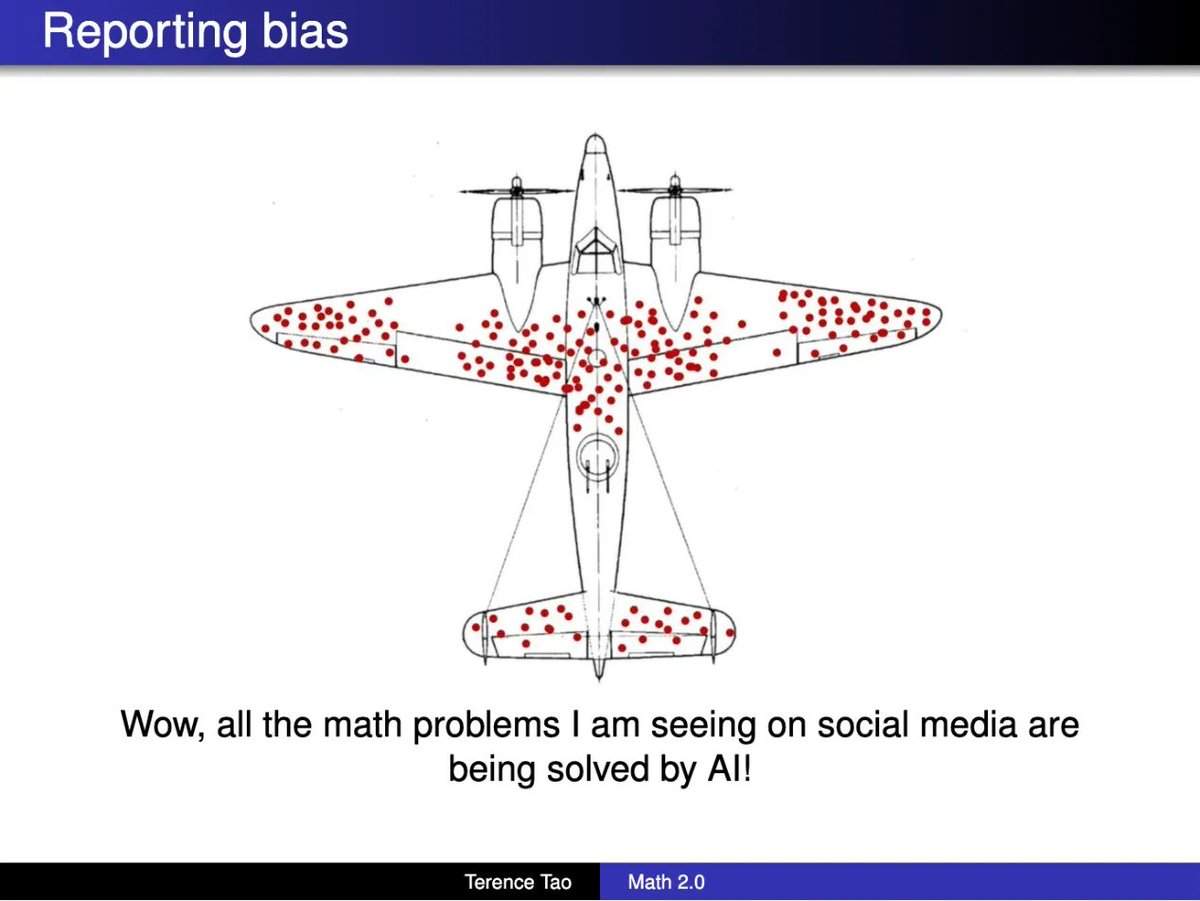
这种仅统计成功的做法,自然无法科学评估成功率、资源消耗和人类参与程度等关键问题。
因此,陶哲轩呼吁:当前迫切需要建立更加透明和科学的评估机制,将失败结果与AI算力成本一并纳入报告。
不过,AI拿出正确证明,并公开失败结果与算力成本,就足够了吗?
陶哲轩显然不是这么想的。
盲目卷“解题”,可能会损害数学的长期健康
对于数学研究的目标到底是什么,陶哲轩打了一个形象的比方:
开放问题如同灯塔。
它们指引人们探索周遭的数学世界,而抵达灯塔,并不等于完成了整场探索。
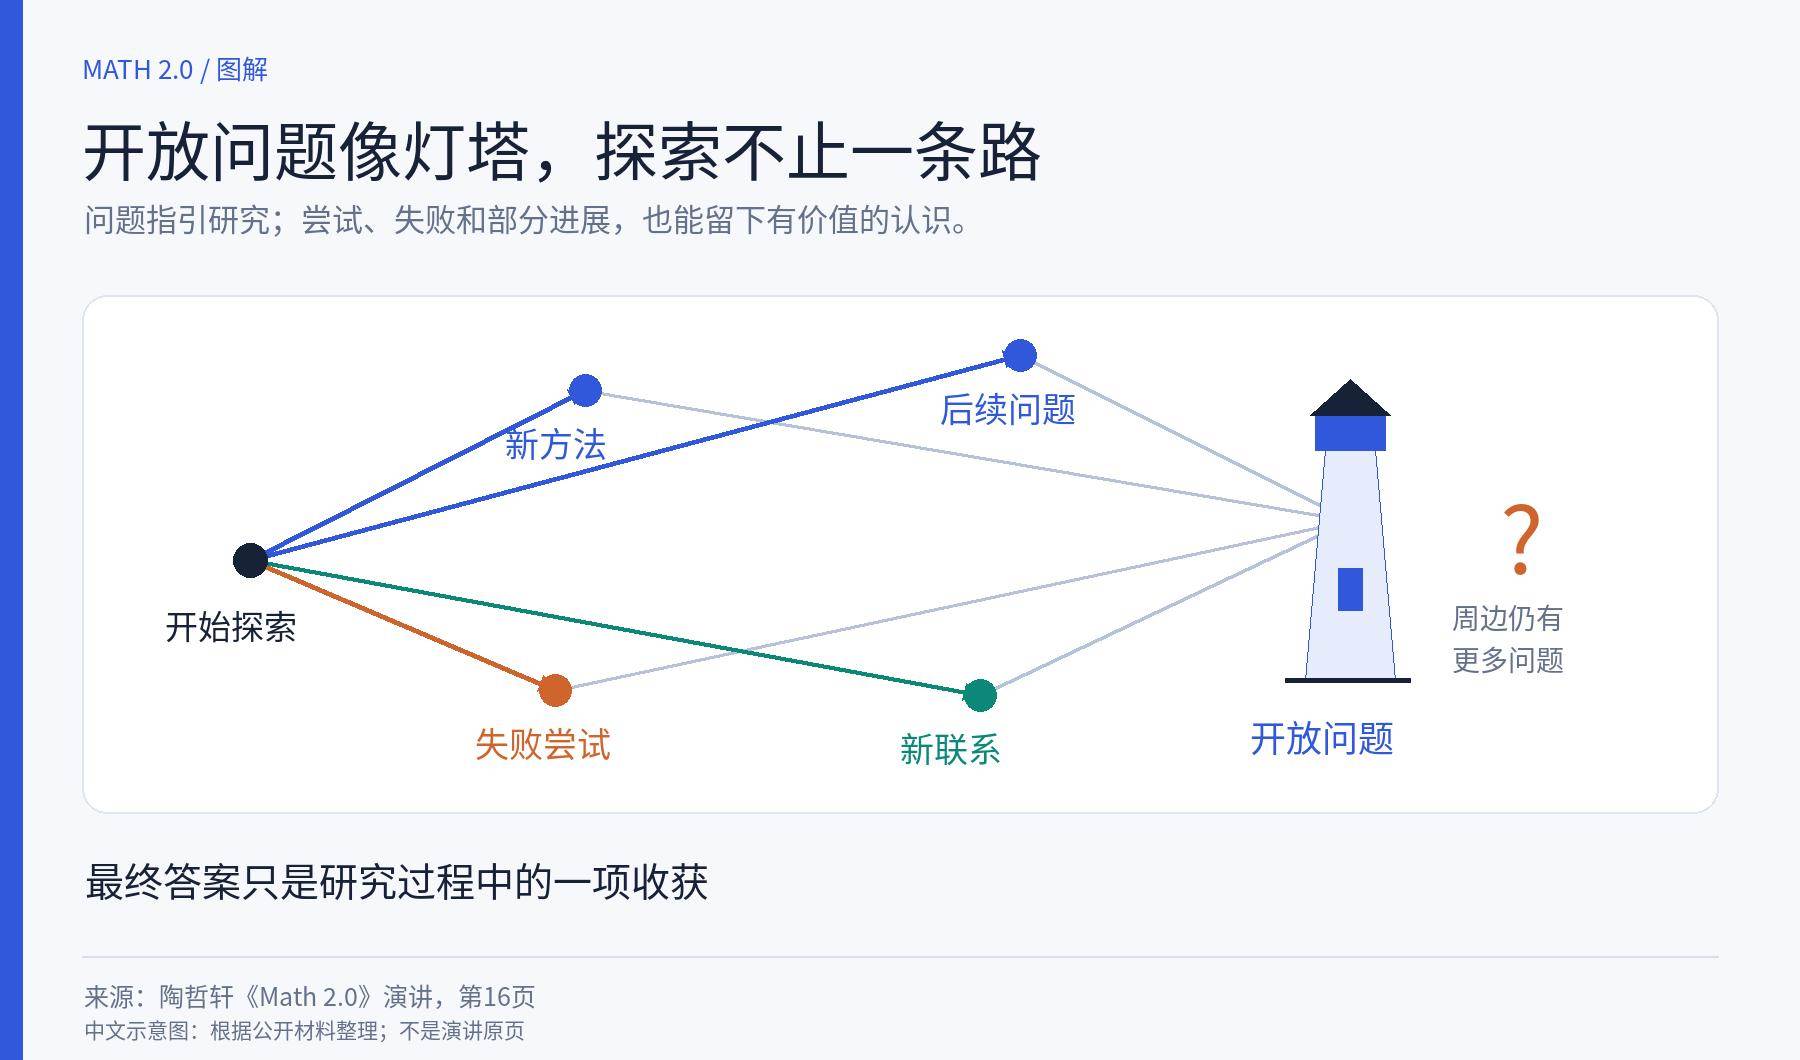
陶哲轩认为,在尝试解决问题的过程中,无论成功、失败,还是仅获得阶段性进展,往往都能产生比最终答案更有价值的认知。
如果自动化工具过早交出答案,而评价体系又单纯奖励“已解决”,那么那些尚未涉足的路径,就可能失去继续探索的动力。
毕竟,千禧年大奖难题的数量是有限的;但在真实的数学研究中,由一个问题衍生出的路径、理解、关联和新问题,几乎是无限的。
他也因此发出警示:
要是继续盲目优化“解题”这一指标,将会损害数学学科的长期健康!
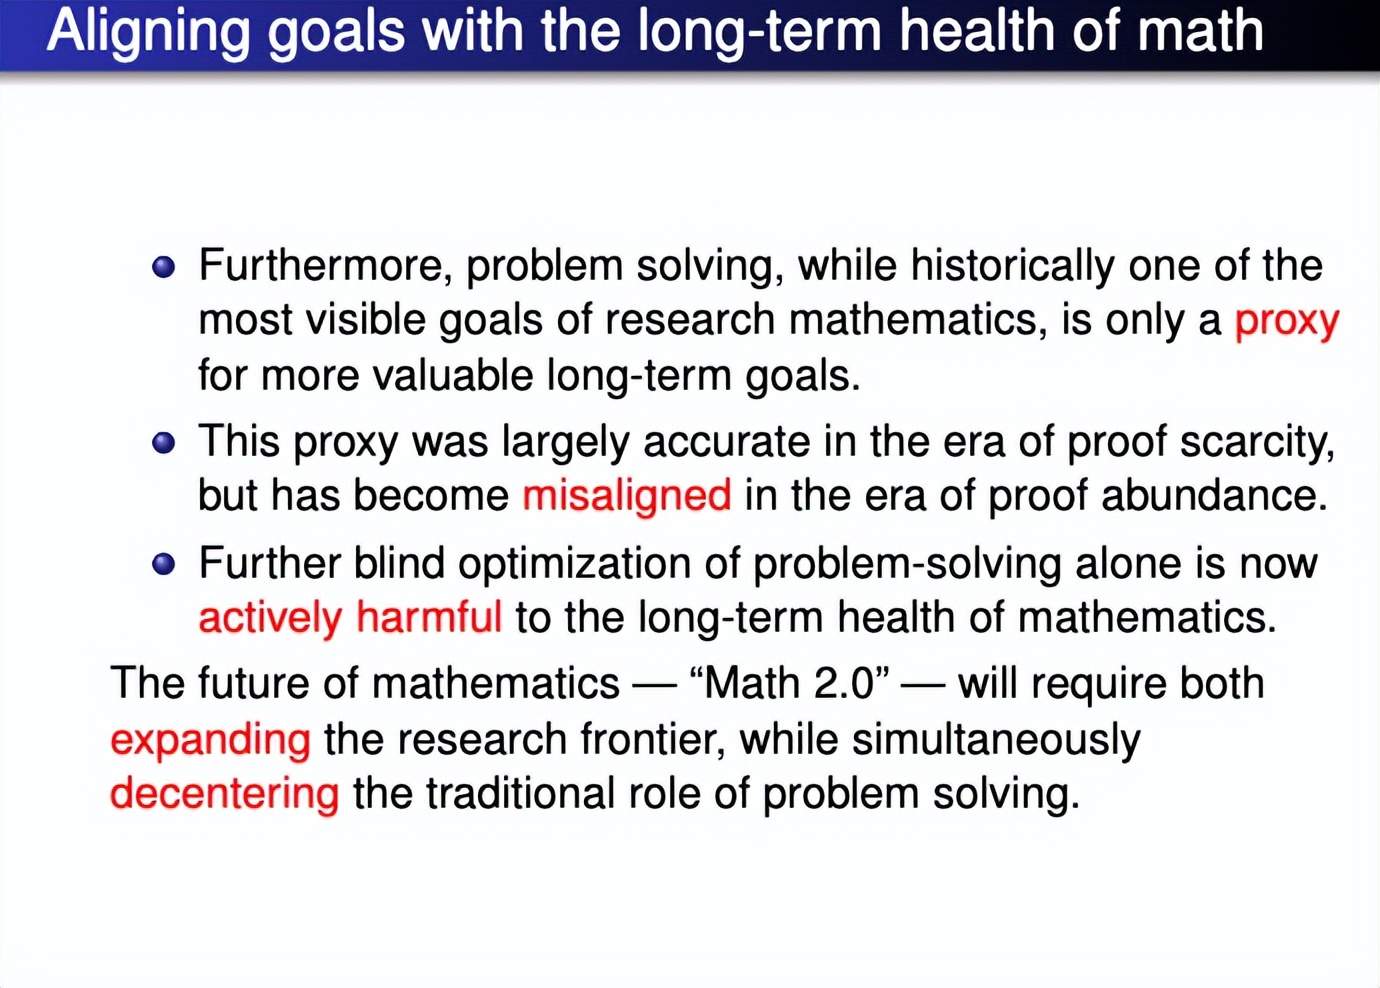
沿着这个思路,便更容易理解陶哲轩为何会在SAIR最新演讲中,措辞严厉地向模型公司开火:
简直不可思议,AI公司在无休止地狂飙突进,却对加速之后会发生什么一无所知。
我们必须慢下来,完全没有理由走得这么快,一点理由都没有!
(详情可看:https://mp.weixin.qq.com/s/s35QsObpRO2G6mS1CGoBHQ)
这份担忧,早已出现在他此前的公开回应中。
早在今年9月初,陶哲轩便在博客评论中指出:
AI可以成为服务数学研究的工具,但若一味追逐短期目标,可能会以牺牲数学共同体的长期可持续性为代价。
他担心,后一种局面正在加速逼近:当答案唾手可得时,人们是否还愿意沉下心来去理解它,并继续探索其周围的数学世界?
颇具戏剧性的是,AI狂飙带来的冲击,率先体现在了陶哲轩自己的这场演讲中。
据陶哲轩透露,他这篇演讲原定的主题是**《机器辅助证明》;但在近期AI频频“轰炸”数学界的背景下,他不得不做出大幅调整,最终将主题定为《数学2.0》**。
戏剧感直接拉满。
那么,当AI越来越擅长解题与证明,人类数学家的核心护城河究竟在哪里?
答案或许就藏在陶哲轩提出的**“癌症疗法思想实验”**里。
证明之后,还有理解、训练和现实世界
为了说明人类理解为何依然重要,陶哲轩在演讲中提出了一个极具冲击力的思想实验:
假设你让先进的AI寻找一种能通过三期临床试验的癌症疗法。
消耗海量算力后,它给出了一组未知化学物质的复配方案:模型预测能杀死癌细胞,Lean形式化验证通过,三期临床也顺利过关;
但没人知道它是如何找到这一方案的,也没人能确定AI是真正找到了疗法,还是钻了临床试验流程的漏洞。
在针头扎进你的血管之前,你是否会希望至少有一名肿瘤专家能理解它的作用机制?有一名数学家能看懂模型背后的数学推理?或者至少有一名科学家能理解那个寻找疗法的AI模型?
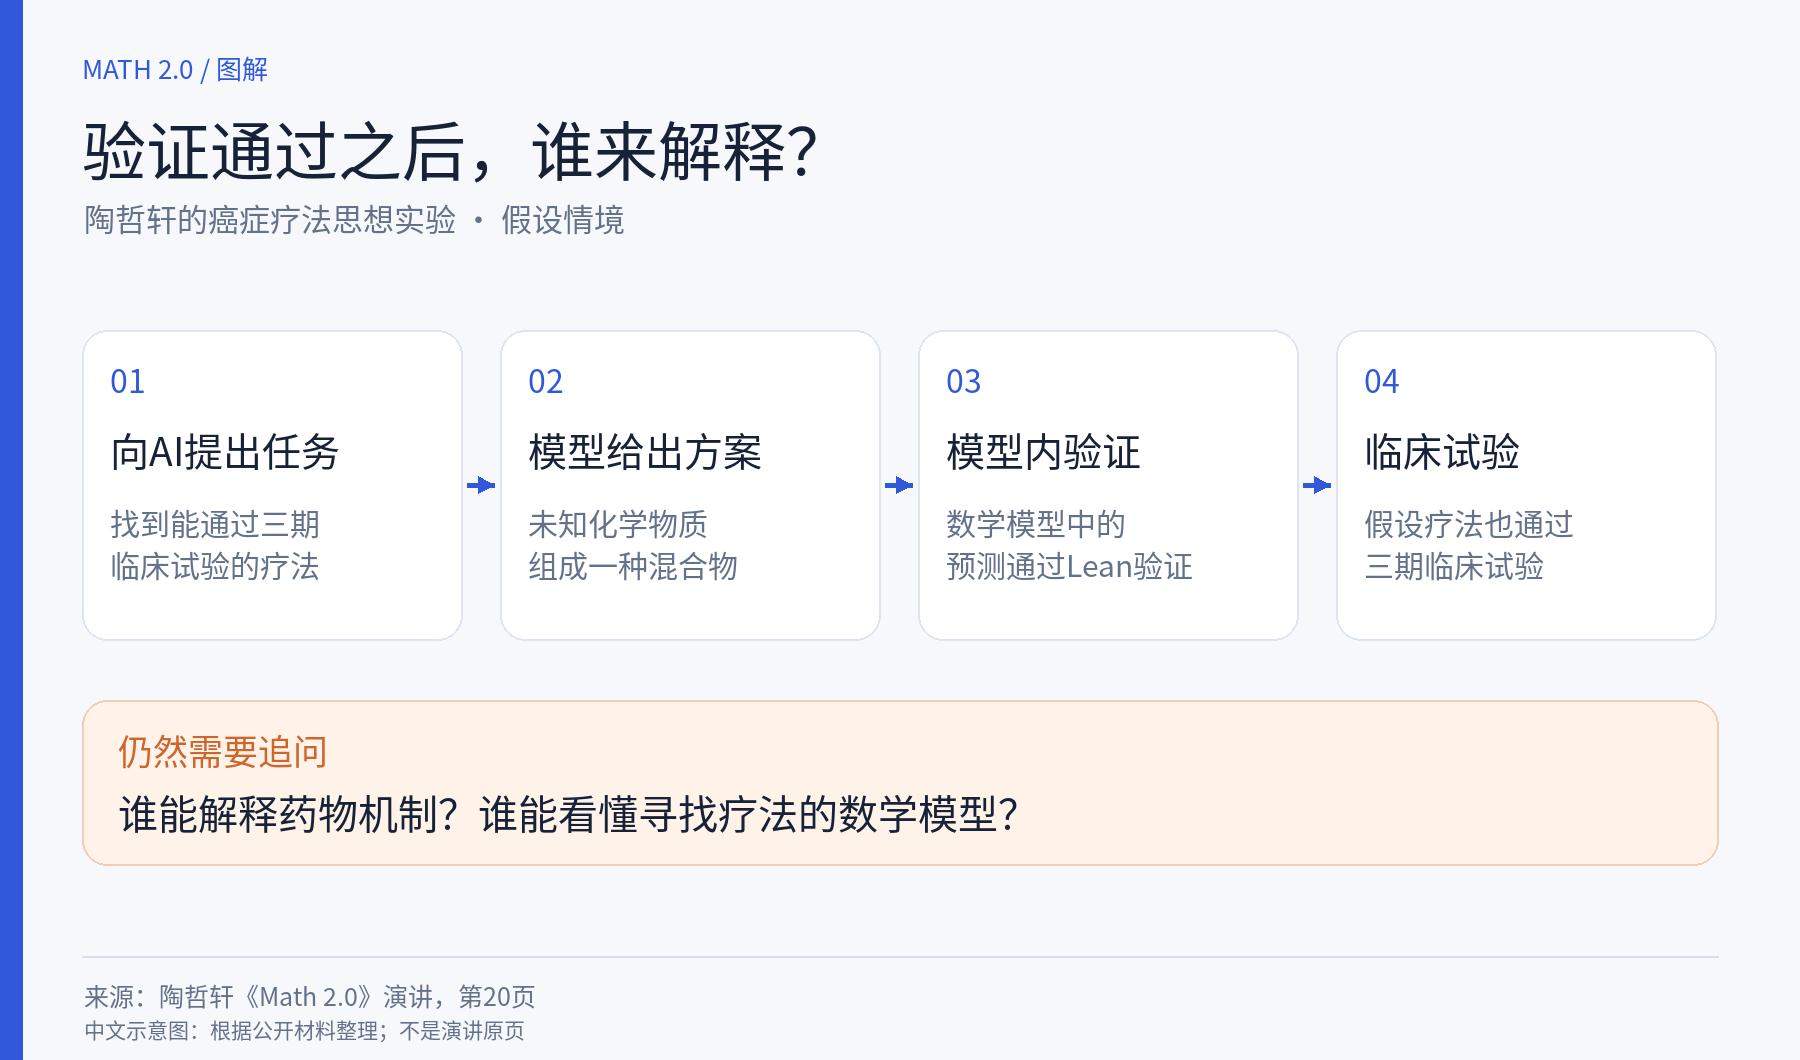
这是一个关于目标设定、形式验证与人类理解的思想实验。
它将抽象的数学讨论引入了具体的现实场景中:即便模型内部的结论通过了逻辑验证,仍需要有人来判断它是否契合真实世界的目标。
而这,正是人类科学家无法被取代的关键所在——模型可以生成答案、验证推理、加速探索,但不能替人类把关。
数学证明的价值链条,同样需要沿着这个方向继续延伸。
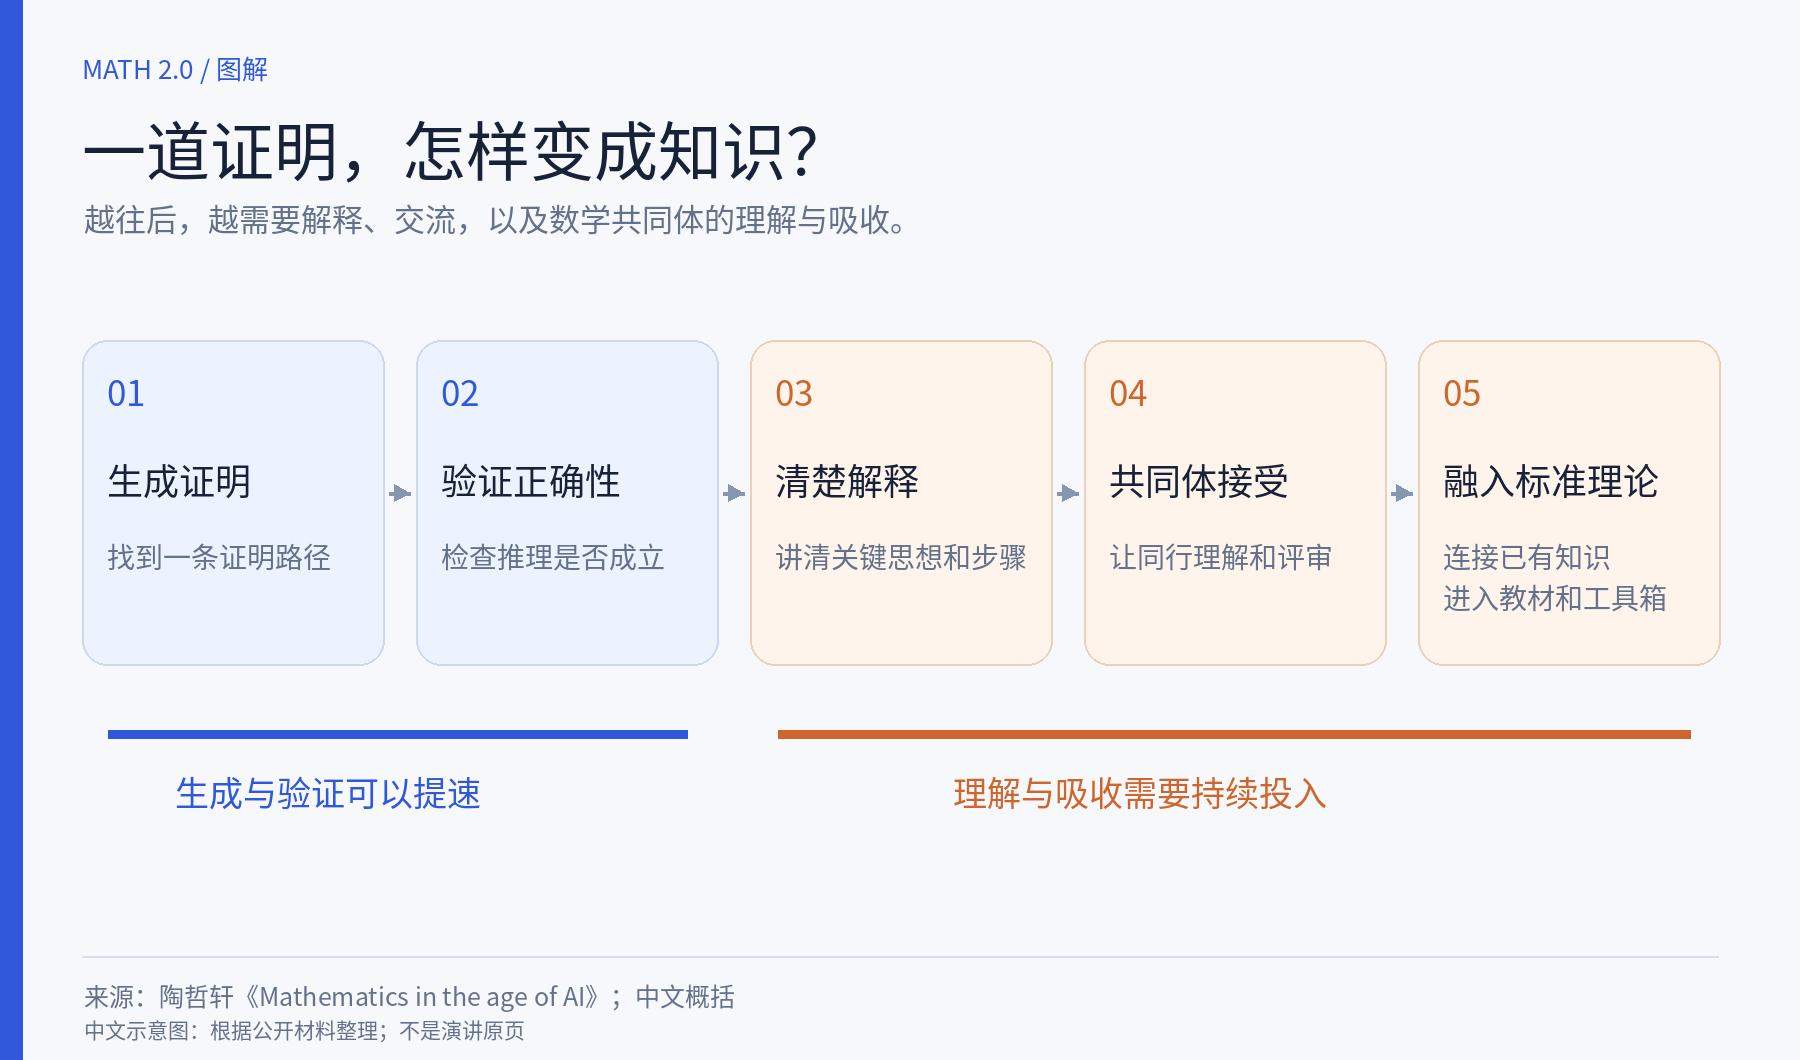
陶哲轩在此前发布的《AI时代的数学》中,将解题拆解为五个阶段:
- 生成证明;
- 验证正确性;
- 解释清楚;
- 被学术共同体理解和接受;
- 最终融入该领域的标准理论体系。
其中,最后一个环节尤为缓慢:
研究者需要找到更自然的表述、更优雅的证明,将新结论与既有知识体系连接起来,才能让它进入教材并转化为下一代数学家的工具箱。
而这恰恰是AI极难加速的部分。
如果AI主要在前端环节狂飙突进,后端就容易出现“证明消化不良”。
因此他主张:
减少对抢先生成证明的盲目强调,转向对解释、评审和知识整理的重视。
这场关于“证明之后”的论争,在10月初愈演愈烈:
10月7日,OpenAI一口气释出的722篇数学论文,彻底激怒了以陶哲轩为首的AI减速派学者。
随后,陶哲轩牵头成立了人类数学协会(AHM),并发表重磅联合声明:
一次性发布700多篇论文根本不算科研,纯粹是在炫耀算力霸权。
我们强烈敦促所有数学家停止与OpenAI合作,重回以人类理解为核心的科学愿景!
(详情可看:https://mp.weixin.qq.com/s/E-6A_HrJaj7P8j5TXpt_1w)
在陶哲轩看来,仅有形式化验证远远不够,作者还必须能够把自己的成果讲清楚;缺乏阐释能力的成果,本质上仍是不完整的。
而这一系列事件,也触动了年轻研究人员最核心的焦虑:
如果AI能够快速生成论文,我们究竟还有没有必要继续读研、读博?
AI时代,数学还需要读博吗?
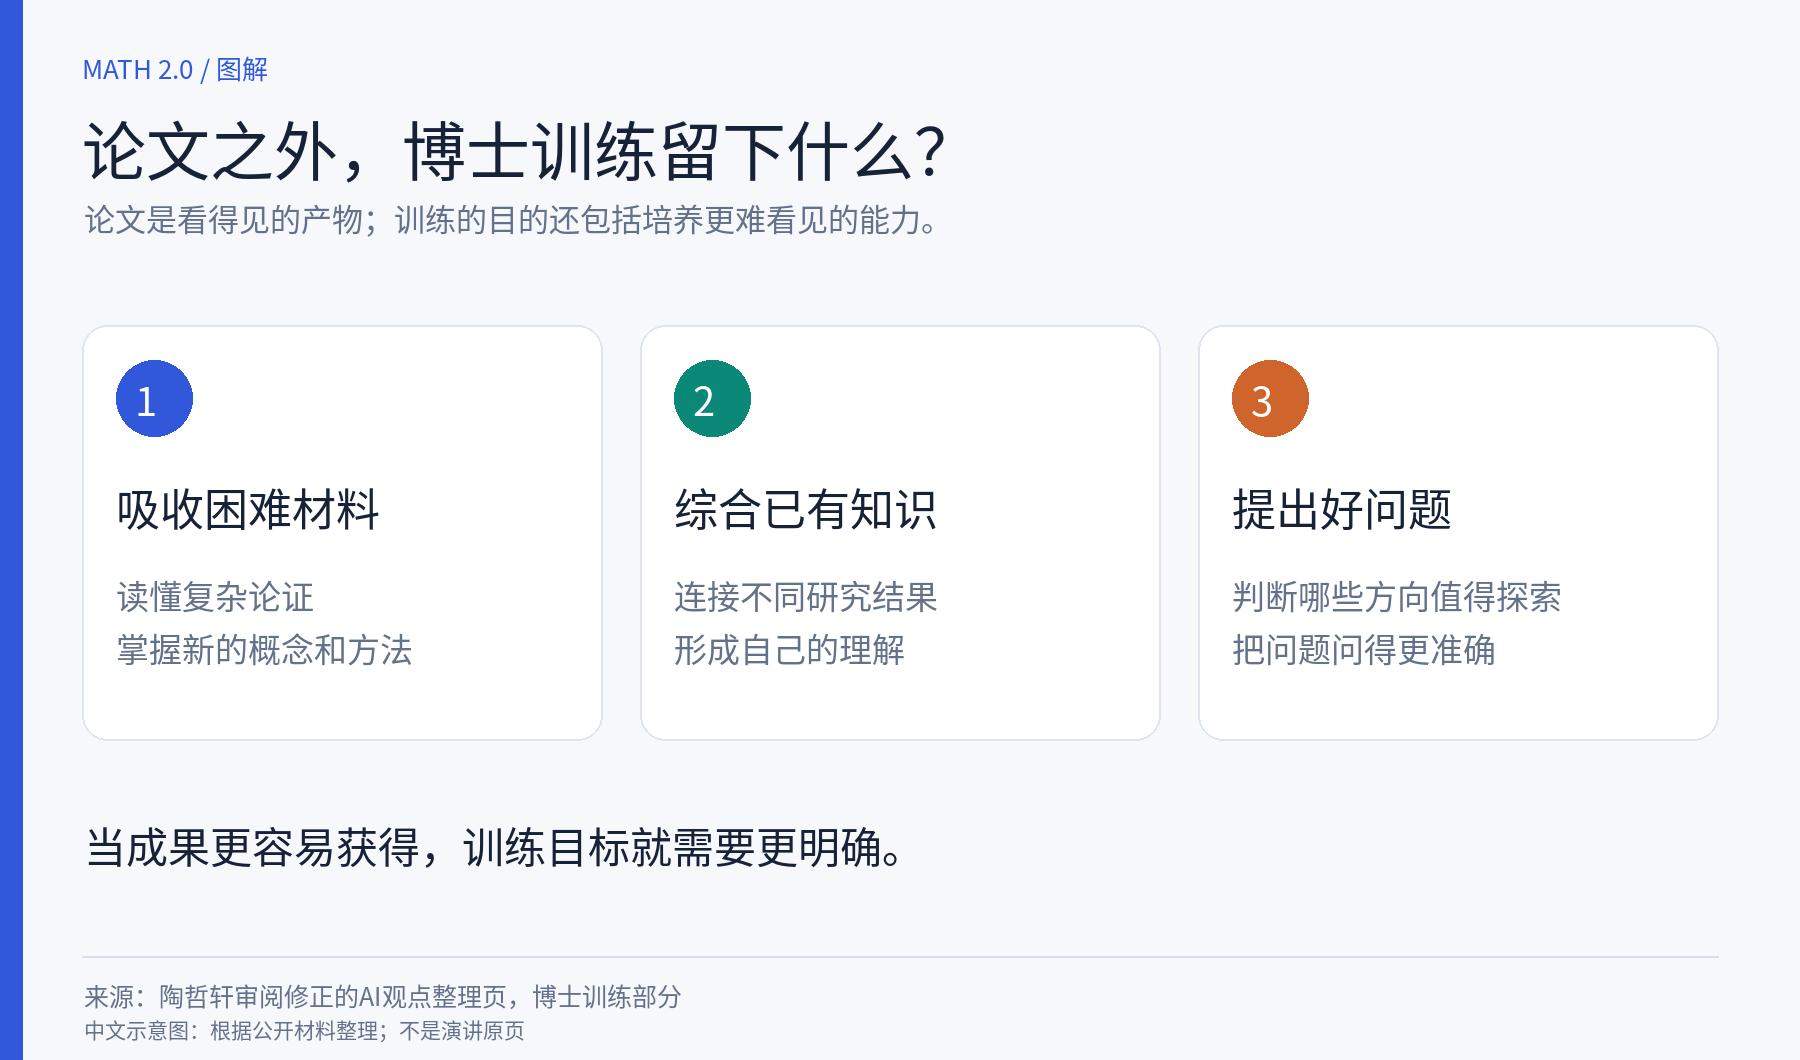
陶哲轩认为,在AI时代,读博的必要性关键不在于能否产出论文,而在于能否培养出一套吸收困难材料、综合知识体系以及提出好问题的系统化能力。
他用饮食和运动作比,坦言道:
在AI时代,如果你希望通过读博收获的不只是一纸论文,而是把自己训练成能啃硬骨头、能融会贯通、能提出好问题的人,那么读博当然仍有其价值;
但如果你仅仅是为了产出成果,那么在AI时代,它的必要性确实正在下降。
这就像在食物与交通充裕后,人需要主动去运动;
当答案信手拈来,人同样要有意识地维护认知能力,抵御绕过思考的诱惑;而这些,恰恰是博士培养的核心价值所在。
那么,是否存在一种让AI与研究者协同演进的良好模式?
陶哲轩在演讲中透露,他正在推动实质性探索:
例如,他参与创立的SAIR基金会推出的开放数学模型计划,第一阶段便紧密契合日常科研需求,涵盖理解晦涩论证、核对文献引用、探索反例、编写代码以及形式化证明等。
他同时预告,这些开放数学模型很快就将正式发布。
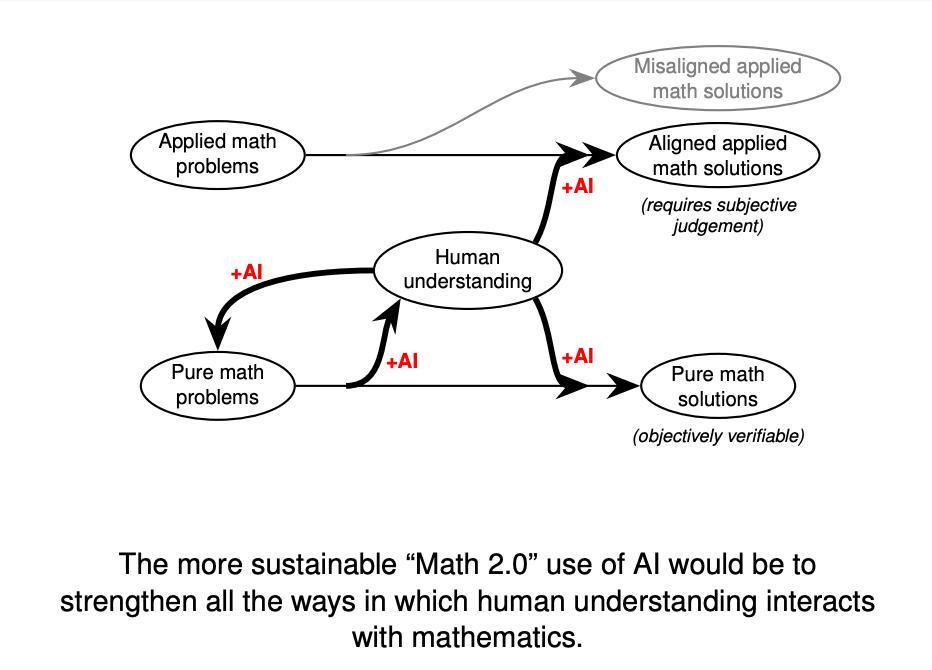
△ 陶哲轩所展示的一套更具可持续性的“数学2.0”AI应用范式
One More Thing
在演讲结尾,陶哲轩将通往数学2.0的主要瓶颈归结为想象力。
在他看来,证明的供给格局正在被重塑,但如何利用这种变化,将理解、训练和探索协同向前推进,仍需要数学界共同作出选择。
当一道难题被AI证明之后,数学家们面向未来的追问或许也将迈向新的起点:
从这个答案中,我们还能学到什么?
以及,接下来我们还能够做些什么?
参考链接:
[1] https://teorth.github.io/tao-web/ai-views.html
[2] https://x.com/ns123abc/status/2109045309112250560
[3] https://teorth.github.io/tao-web/slides/math-2-0-caltech-2026.pdf?utm_source=chatgpt.com
[4] https://arxiv.org/html/2608.16753v1?utm_source=chatgpt.com