
多模态模型的视觉原生 Harness,来了!
最近,何恺明团队在最新论文《VISTA: A Visual Harness for Reasoning in an Interactive World》中,提出了一套视觉原生的 Harness——
VISTA。
它让现有的多模态模型可以直接观察环境、保存原始画面,并在推理时随时回看、放大和检查细节,全程无需从头训练。
相比于传统将环境抽象为文本或代码的做法,VISTA 完整保留了原始视觉信息。模型可以根据当下面临的问题,将过去观察过的画面重新调入上下文,参与当前的判断与推理。
基于这套方法,视觉经验转化为模型可随时调用、反复核查的上下文信息;多模态模型也因此拥有了围绕视觉记忆搭建的原生脚手架。
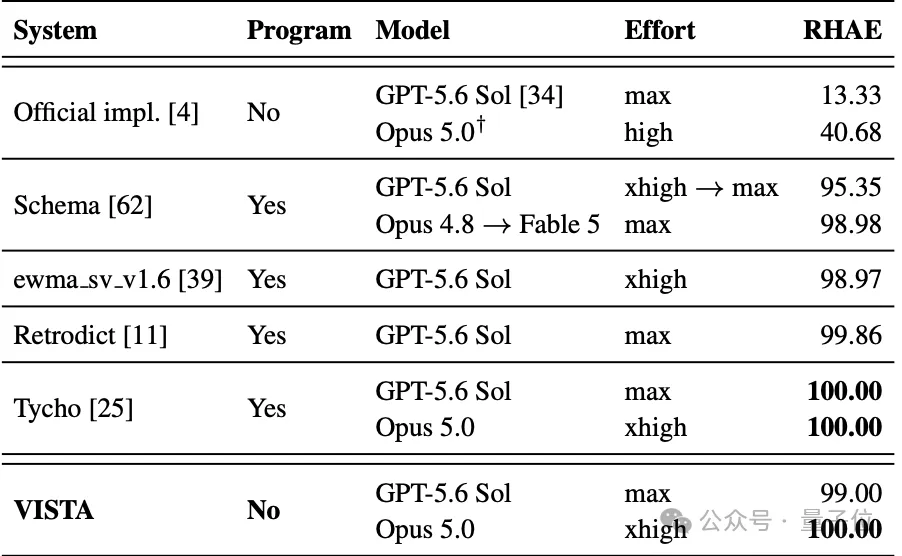
在基准评测中,搭配 VISTA 的 Claude Opus 5.0 通关了 ARC-AGI-3 全部 25 个公开游戏,相对人类动作效率得分达到满分 100,所用游戏动作数比首次游玩的人类基线少 57.4%。
换用 GPT-5.6 Sol 同样实现全量通关,得分高达 99。
不仅如此,团队还在浏览器游戏、迷宫及连线题中验证了该方法的有效性,并将更贴近物理世界的具身任务列为了后续研究方向。
这一方案具体是如何实现的?
视觉原生的脚手架
从 ResNet、Mask R-CNN 到 MAE,视觉感知与表征学习始终是何恺明研究的一条核心主线。
这一次,VISTA 将目光投向了一个新命题:如何让模型在持续交互中积累、保存并高效利用视觉经验?
答案是 Harness。
去年 11 月,Anthropic 曾以长时间编程任务为例,介绍了 Harness 如何帮助模型跨越多个上下文窗口持续推进任务。
具体而言,Harness 会通过任务清单记录待办事项,并通过进度文件与代码记录保存已完成的工作。
这样一来,即使模型进入新的上下文窗口,也能通过读取这些状态记录,清晰获知历史进展与后续规划。
复杂任务由此得以分步执行、逐步校验,并在跨上下文窗口时无缝接续。
可以说,这套主要依托文本与代码保存任务状态的 Harness 机制,在很大程度上推动了此前 Agent 能力的集中爆发。
然而在现实场景中,仅凭文本记忆显然远远不够。
一旦置身于真实的视觉环境,模型不仅需要记住物体的坐标与朝向,还要准确理解每次动作前后环境产生的细微动态变化。
更为关键的是,模型初次观察画面时,往往无法预判哪些细节会在后续步骤中发挥关键作用。
这些丰富的视觉信息,既很难预先借助一份文本笔记做到巨细靡遗地记录,更无法保证后续调用时依然完备可用。
在 ARC-AGI-3 这一基准中,一种常见的既有思路是:先将画面转化为由数字构成的文本网格,再让模型编写程序以模拟环境规则、推演行动方案。
注:ARC-AGI-3 是一套交互式视觉推理基准,不预先提供游戏规则与目标,智能体必须通过自主观察与试错操作摸索通关策略。
但这种方式的局限在于:随着环境复杂度提升,物体的外观特征、空间拓扑以及动态演变极难被无损转译为文本与代码。且伴随交互轮次的拉长,早期的视觉帧会被逐步挤出上下文窗口,或被高度压缩的文本摘要所替代。
基于此,VISTA 聚焦于解决这一核心问题:
如何在不重新训练基础模型的前提下,让智能体在推理需要时,能够重新调取并核验历史视觉信息?
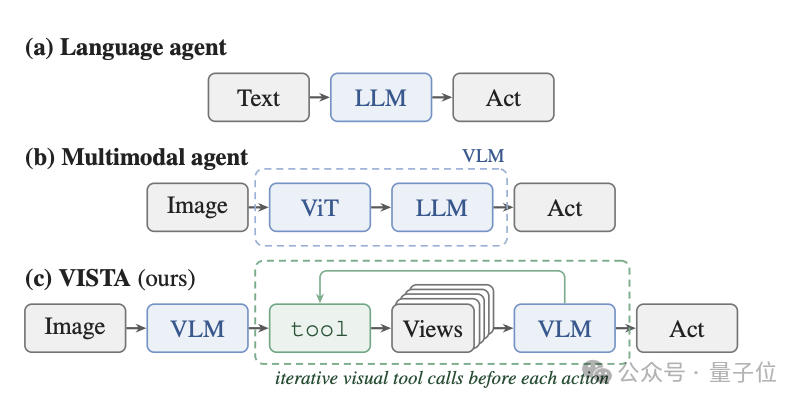
VISTA 的解法是:将环境返回的每一帧画面原样保存在上下文之外(包括动作执行过程中的动画过渡帧),待模型需要时再定向调取。
在 ARC-AGI-3 评测中,系统既支持跨时序比对多帧画面,也支持局部裁剪放大,用以核验方块上的朝向标记等细粒度信息。
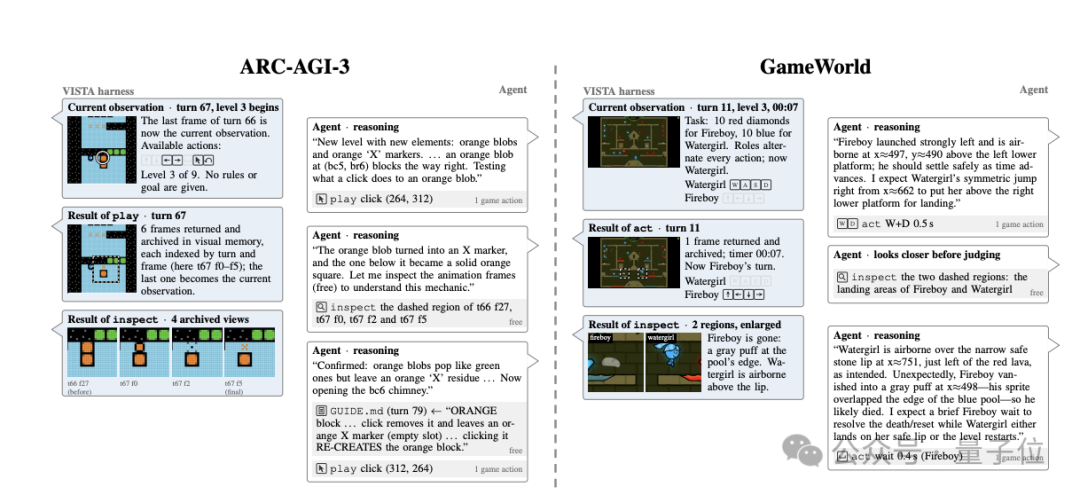
在该架构下,文本笔记负责沉淀模型当前的阶段性认知,原始画面则作为可供反复复核的客观凭据。
研究团队将这一机制定义为针对交互历史的“显式注意力”——模型可根据当前的推理诉求,自主决策引入哪些视觉数据回流至上下文。
为了实现这一目标,底层系统必须完整封存原始图像流,并提供敏捷的检索与质检工具链。
具体实现
为赋予模型持久化存储与回溯视觉经验的能力,VISTA 构建了三大核心组件:
视觉观测、无损视觉记忆与主动视觉检查。三者协同配合,分别负责画面的输入呈现、历史留存与按需调阅。
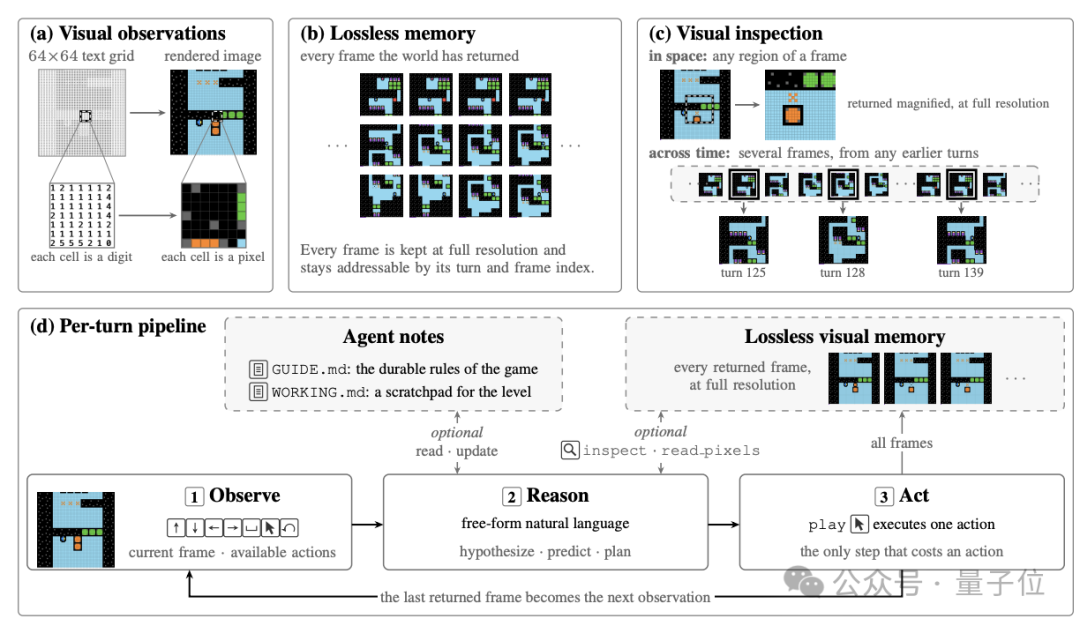
第一,视觉观测:负责向模型提供高保真环境画面。
在 ARC-AGI-3 实验中,VISTA 将官方提供的 64×64 画面放大至 512×512 的 PNG 图像,完整保留色彩、形态及空间拓扑关系,确保模型能直接对物理特征展开感知。
第二,无损视觉记忆:负责对模型所见画面进行结构化存储。
每次执行动作后,VISTA 都会无损留存环境回传的所有图像(含动作演进中的动画中间帧),并依托回合编号与帧序号建立索引系统。
模型无需在前序阶段仓促判断哪些特征值得记录,而是将所有视觉经验先行沉淀为底层资产,按需随时调取。
第三,主动视觉检查:负责支持模型按需回溯与深挖历史帧。
借助 inspect 工具,模型既能按指定回合调出对应历史图像,也可以进行局部切片放大以审查像素级细节。
若需厘清某项操作引发的具体状态演变,模型还能跨回合拉取多帧画面进行差分比对。
该机制相当于为多模态模型装配了一套随时可供检索的“视觉档案库”。模型不仅能立足当下视野,更能自主回溯历史轨迹,为后续决策提供实证支撑。
在具体运作流程上,三大组件遵循严格的时序协同:
每个回合伊始,模型先解析当前画面与合法动作空间,结合先验经验研判系统状态,进而提出下一步动作假设。
若当前感知置信度不足,模型即可激活工具链,调阅历史切片、放大局部视域,甚至读取离散像素数值以印证猜想。
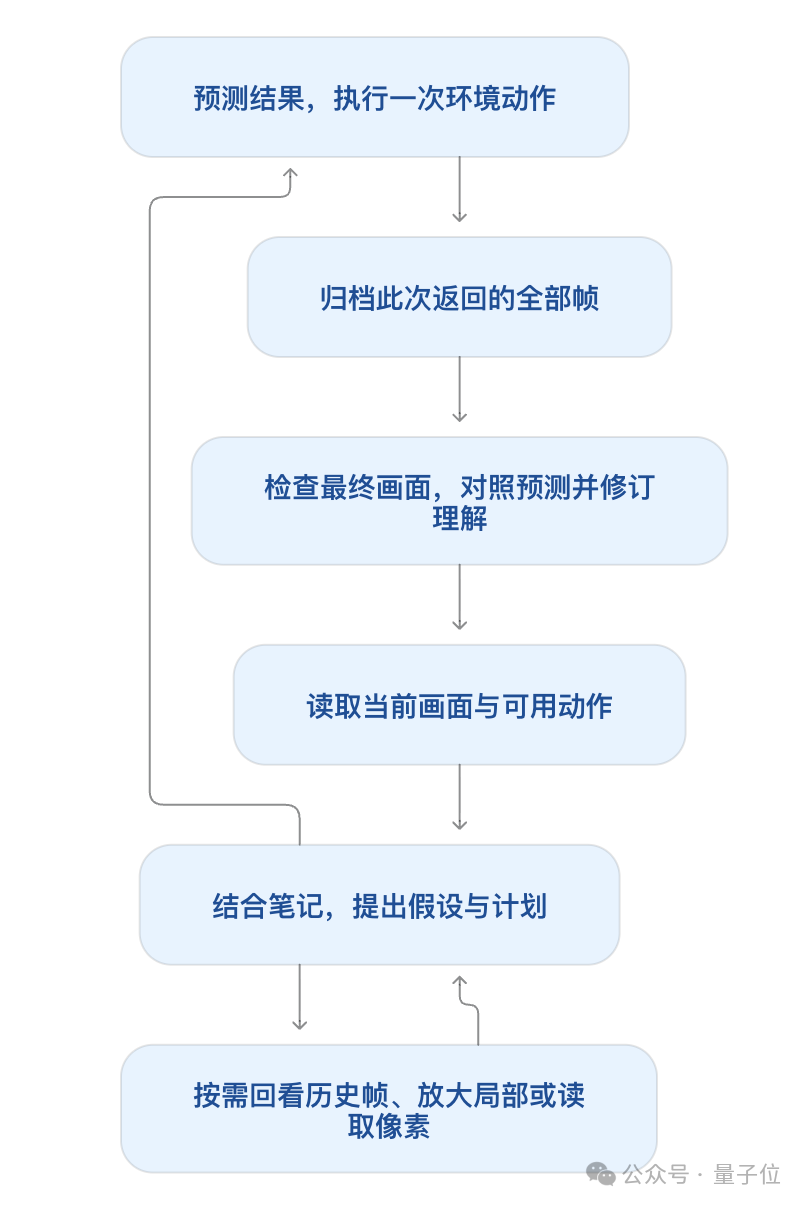
完成证据链闭环后,模型并不急于盲目操作,而是先行对动作反馈做前向预测。
待执行完毕,再将真实状态反馈与预期进行比对校验,以此动态修正对底层规则的认知框架。
通过这一闭环,智能体在持续交互中同步推进环境探索与知识演进。
为保障长程任务的上下文连贯性,VISTA 辅以两份结构化文本备忘录:
GUIDE.md:沉淀可跨关卡复用的普适性规则与策略模式。WORKING.md:记录当前任务的具体状态、实时进度及后续调度计划。
当上下文窗口接近容量上限时,模型会先行生成阶段交接摘要,随后平滑迁移至新窗口继续运转。既有的文本记录、动作日志与底层视觉资产均得以完备承接。
值得注意的是,VISTA 虽然做到了视觉历史的无损全记录,却并未采取暴力填塞上下文的做法。
在全功能方案中,单次回合执行后,框架默认仅将末尾帧注入活跃上下文,动画过渡过程帧则统一托管在外部存储架构中,等待指令定向唤醒。
这种解耦设计既避免了海量图像帧吞噬宝贵的上下文容量,又守住了视觉信息的无损性。
更为重要的是,VISTA 并未引入任何新的模型权重训练。
场景理解、推理决策与路径规划完全依托既有多模态基座模型,Harness 则专注于工具调度、经验管理和证据交付。
可以说,VISTA 并非重塑模型结构,而是从工程架构上革新了多模态智能体捕获、沉淀与调度视觉经验的方法论。
实验验证
除 ARC-AGI-3 外,团队还在 GameWorld、AI GameStore 及 BabyVision 三个基准集上对 VISTA 进行了全面评测,覆盖网页游戏、迷宫导航及拓扑连线等多种任务形态。
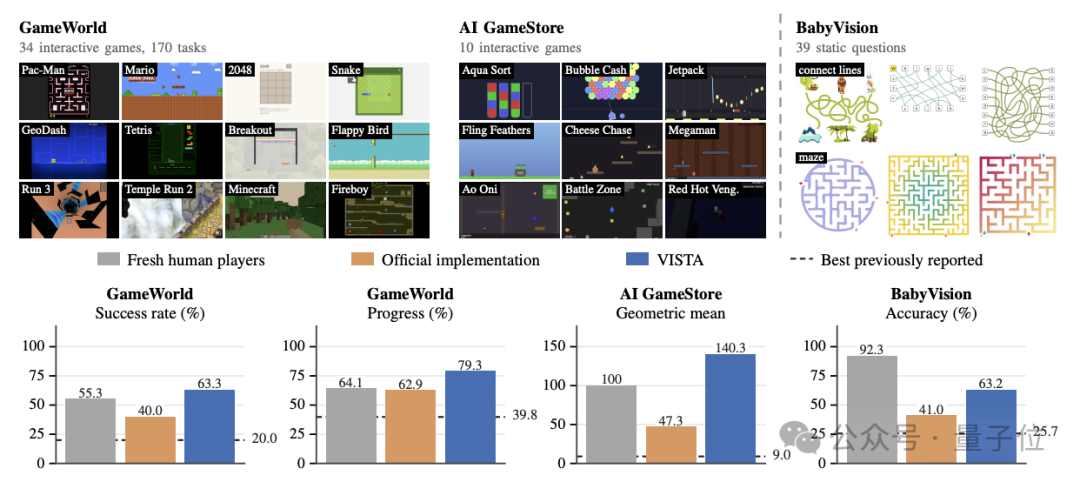
在统一接入 GPT-5.6 Sol 的基准下,对比官方基线方案:
- 在 GameWorld 的 170 项任务中,VISTA 将通关成功率从 40.0% 大幅拉升至 63.3%;
- 在 AI GameStore 的 10 项游戏中,综合基准分从 47.3 跃升至 140.3(人类中位数归一化为 100);
- 在 BabyVision 选取的 39 道静态迷宫与拓扑连线题中,准确率由 41.0% 提升至 63.2%。即便在纯静态任务中,模型亦可通过局域放大与像素比对显著纠偏推理逻辑。
数据证明,通过无损沉淀并按需检索历史图像,能极大释放已有大模型的深层视觉潜能。
同一套 VISTA 范式仅需微调适配,即可无缝迁移至迥异的游戏逻辑与益智推理任务中,展现出良好的工程泛化属性。
团队表示,未来的演进方向将聚焦于物理维度的具身智能任务:探索模型如何在高度动态的非静态环境中,高效保存、复验并调优自身的时空视觉记忆,从而做出更精准的物理决策。
作者介绍
论文的三位共同第一作者为 Qiushi Han、胡珂雅与 Linlu Qiu,通讯与合作作者包括 Cathy Wu 及何恺明。
**Qiushi Han(Josh Han)**目前是 MIT 运筹学中心在读博士生,师从 Cathy Wu。
**胡珂雅(Keya Hu)**目前为 MIT 电气工程与计算机科学系(EECS)博士生,由何恺明与 Jacob Andreas 联合指导。
胡珂雅本科毕业于上海交通大学 ACM 班,研究方向集中于视觉与语言的交叉领域,致力于研发兼具高样本效率与强泛化属性的通用智能体。
Linlu Qiu目前为 MIT EECS 及计算机科学与人工智能实验室(CSAIL)博士生,导师为 Yoon Kim 和 Jacob Andreas。
其研究聚焦于自然语言处理与机器学习,曾先后在 Google Research 与 Meta FAIR 开展学术研究。
Cathy Wu目前担任 MIT 土木与环境工程系及数据、系统与社会研究所(IDSS)副教授,长期深耕利用机器学习与强化学习优化复杂交通系统等课题。
她本科与工程硕士毕业于 MIT,博士毕业于加州大学伯克利分校。
何恺明现任 MIT EECS 终身副教授,系 ResNet、Mask R-CNN 与 MAE 等计算机视觉里程碑式研究的第一作者。
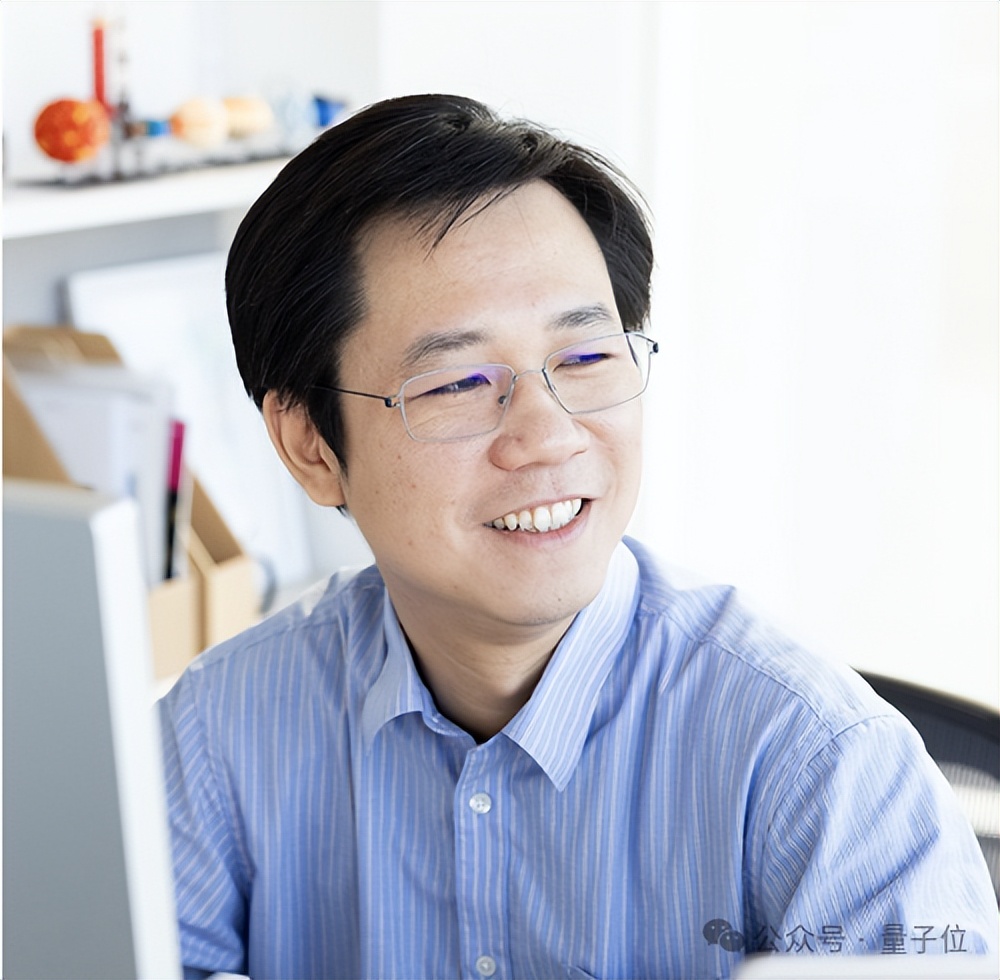
何恺明本科毕业于清华大学,博士毕业于香港中文大学,曾长期任职于微软亚洲研究院(MSRA)与 Meta FAIR,于 2024 年正式加入 MIT 任教。