
构建集群调度器:在保持全量占用的同时优先保障高影响力研究
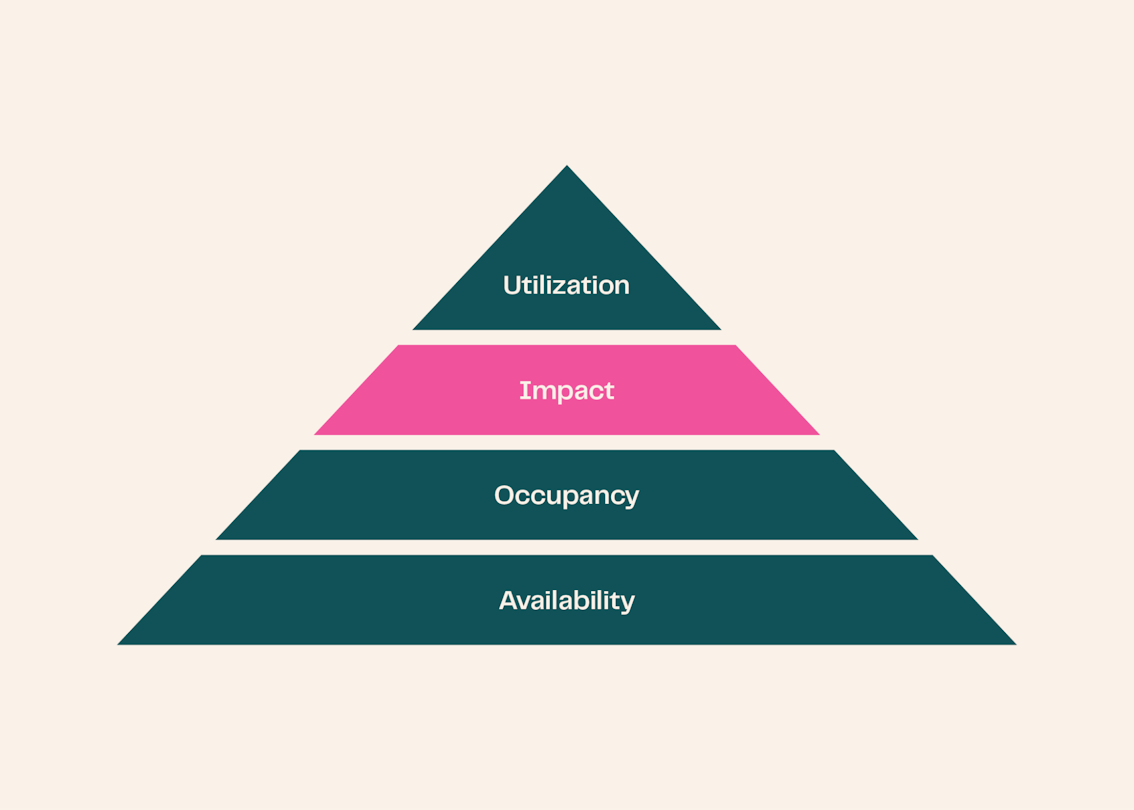
在 Ai2 的 AI 基础设施团队,我们负责为全院提供 GPU 计算能力,重点支持大规模分布式训练工作负载。我们将这项任务视为一个由四项指标逐层构建的金字塔体系。
金字塔的基石是可用性(availability):硬件保持健康并随时待命工作的频率。其上是占用率(occupancy):分配给特定工作负载的可用时间比例。再上一层是影响力(impact):最具价值的工作负载获得资源的频率。金字塔的顶峰则是利用率(utilization):在工作负载的生命周期中实际消耗的 GPU 算力比例。
本文将探讨如何提升调度决策的“影响力”。最近,我们淘汰了一套基于优先级的调度器,取而代之的是包含 GPU 时间预算、分层公平共享分配(hierarchical fair-share allocation)以及时间片合约(time-slicing contract)的新系统。因此,关于每个研究项目应该获得多少 GPU 时间的争议,从一项逐案处理的运维琐事,转变成了一个透明的行政预算流程。
资源超额提交(Overcommitting)
在 Ai2,我们管理着数千张 NVIDIA H100、B200 和 B300 GPU,它们分布在规模从 88 到 1024 张 GPU 不等的集群中。这些集群专为 AI 模型的大规模分布式训练而构建,服务于约 150 名内部研究人员。他们的研究涵盖广泛的 AI 领域,包括 LLM 和 VLM 训练的全流程、机器人强化学习(RL)仿真,以及针对科学智能体(scientific agentic)用例的后训练(post-training)。
与许多实验室一样,我们对 GPU 时间的需求远远超过供给。根据提交的工作负载,集群在任何时刻未完成的请求所需的 GPU 数量都是实际可用数量的 2 到 3 倍。换言之,集群中每一个可用的 GPU 小时,都有 2 到 3 个不同的研究工作负载在互相竞争。
过去,我们使用的是基于优先级的调度器,并允许工作负载退出(opt out)可抢占状态。每个团队在不受抢占保护的工作负载上所能并发使用的 GPU 数量都设有上限。而可抢占的工作负载则可以在闲置 GPU 上超出该上限运行。这种策略导致了意料之中的病态现象。例如,我们观察到了 GPU“占座”(squatting)的情况——用户会挂起无操作的空闲任务(no-op workloads),以便在需要时直接接入。之所以出现这种情况,是因为研究人员发现他们无法以足够低的延迟启动调试工作负载来实时排查问题。我们还观察到了“优先级通胀”(priority inflation),最终 100% 的已调度任务都使用了“高”(HIGH)优先级。这意味着较低优先级的工作负载彻底被剥夺了获得 GPU 时间的机会。此外,由于可抢占性是可选的,我们还发现值班工程师的大部分工单处理时间都耗费在了沟通协商上——协调如何有序关停运行在已知存在维护问题的节点上的不可抢占工作负载。
公地悲剧(Tragedy of the commons)
当这些问题出现时,我们并没有迅速找准根因。我们最初试图确保最重要工作获得 GPU 时间的做法,集中在更严格地控制优先级的设定上,并且最终演变为绕过基于优先级的调度器——直接为重要项目分配 GPU 独占权。虽然我们起初并未意识到,但我们实际上搭建了一个观察“公地悲剧”(tragedy of the commons)的绝佳实验室。个体在争夺稀缺的共享资源时,因追求自身利益最大化,导致了全局非最优的结果,并造成了对底层资源的滥用。
我们绝非第一批观察到这种现象的人。资源分配是一个融合了算法开发、经济学与系统管理的极具吸引力的研究领域。其核心痛点在于:用户往往比组织更了解自身任务的价值,但他们有动机隐瞒这一价值,或者在损害整体性能的情况下依然霸占资源。例如,在 2011 年介绍主导资源公平算法(Dominant Resource Fairness)的论文中,Ghodsi 等人分享了一个轶事:某家搜索公司仅在用户能保证高利用率的前提下才为任务提供专用机器,结果他们很快发现“用户在代码中肆意添加死循环,以人为抬高利用率水平”。硬件在不断迭代,但导致资源分配复杂化的根本问题依然如故。
预算而非排期(Budgets not schedules)
解决公地悲剧的经典方案是对共享资源进行私有化——所有者会有动力去最大化其资产的价值。当我们为团队分配整组 GPU 的独占权时,实际上就是在践行这种模式的某种变体,但其粒度太粗了。由于科研本身具有“周期起伏”,这导致 GPU 经常处于闲置状态。各个团队准备好运行实验和训练的时间各不相同,因此分配独占权必然会导致某些时期没有任何任务待执行,而另一个团队却只能干等算力。
我们当时实际上是在人工求解一个背包问题(knapsack problem),试图将动态变化的研究需求硬塞进静态的时间排期中。我们既希望获得资产所有权机制带来的正向激励,又希望维持 GPU 的全量占用(full occupancy)。
我们决定对所有权模型进行迭代。我们不再向团队直接下发 GPU 硬件,而是分配一定份额的 GPU 时间。预测未来的需求需要预知前沿科学实验的结果,因此无法做出精准预测。然而,各项研究工作之间的优先级却是一个战略层面的问题,完全可以更轻松地提前讨论并决定。我们不再去硬解调度迷宫,而是让管理层能够像投资人一样思考:在工作负载实际产生之前,根据管理层对潜在影响力的判断,决定用多少 GPU 时间去“资助”各项研究工作。随后,调度器便可以在为新到来的工作负载排定优先级时利用这些信息。
基于这种思路,我们设计了一套分层系统(hierarchical system),管理者可以按比例将 GPU 时间分配给其负责的项目与研究人员。如下图所示,这将科研战略直接转化为了有保障的 GPU 时间份额。无论其他地方有多少项目在排队,项目 A1 都清楚自己拥有集群总算力 35% 的使用权。
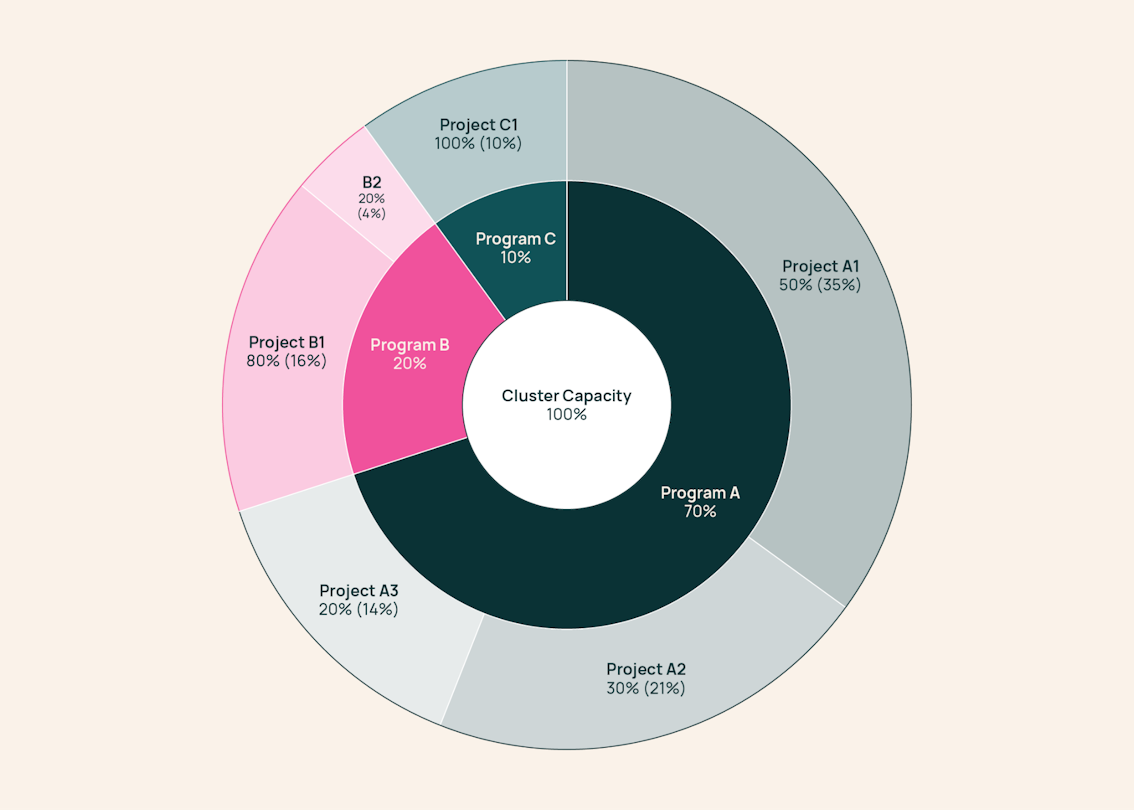
括号中的数值代表分配给叶子项目的集群总容量占比。
在这套系统中,任何对 GPU 时间的请求都必须由预算出资,否则将不受防抢占保护。在旧系统中,“高”(HIGH)优先级无需付出任何成本,且不可抢占性使得一个团队