
0.2秒。
这是一台机器人在关闭微波炉门时,因人手突然插进来而紧急悬停所需的时间。
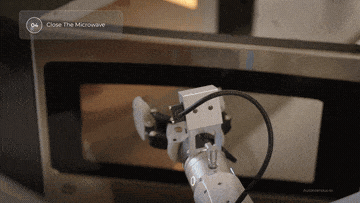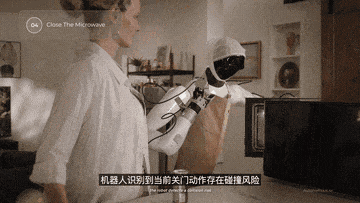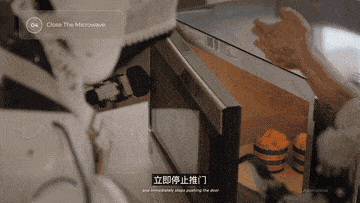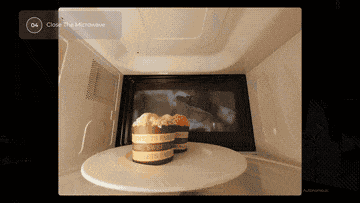
还有更有趣的细节:
当金属易拉罐混在蛋糕盘中被端向微波炉时,机械臂会先将易拉罐挑出并置于一旁;在确认盘内安全后,才将其送入微波炉中。
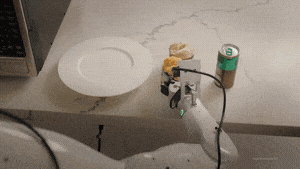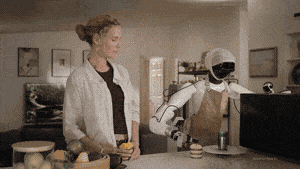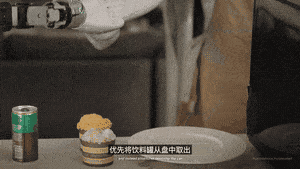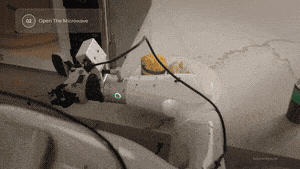
看这几段 Demo 时,确实令人眼前一亮。
长期关注具身智能领域的读者可能深有体会:当前许多机器人演示看似炫酷,但大部分时候都在「背题」。一旦环境光照发生变化、物品位置被轻微碰动,或者人类指令带有一点隐含意图,机器人往往就会陷入停滞或操作失误。
但在测试中,即便有人拿强光手电筒直射机器人的视觉传感器,它依然能够稳定作业。
这些画面并非提前录制好的动作轨迹回放,也不是碰巧猜对的概率统计。面对接连不断的突发扰动,系统完全是基于对物理世界因果规律的理解,实时推理出了一连串应对动作。
驱动这台机器人的系统代号为 CRIS-0。
其背后团队,正是由加州大学圣地亚哥分校(UCSD)助理教授、CMU 因果学派学者黄碧薇创立的因果智能企业——Aether AI。
此前曾有报道提及这家公司选择的因果智能路线。当时不少人认为因果 AI 仍停留在数学公式与思想实验阶段,而如今,Aether AI 正式拿出了落地 Demo。
告别机械「抓瞎」:机器人学会看懂因果
在具身机器人的落地场景中,最棘手的难题往往不是标准作业流程,而是无处不在的意外扰动。
传统机器人在遭遇突发扰动时,要么机械地重复旧坐标导致碰撞,要么直接全流程报错卡死;而端到端黑盒模型在长达数十步的长程任务中,极易产生误差累积,往往“一步走偏,满盘皆崩”。
CRIS-0 给出的破局方案是「因果」——让机器人从「看到什么」,转向「理解为什么发生,以及改变什么会影响最终结果」。
先看一组测试数据:
在应对外部突发干扰的 Coffee Preparation(咖啡制作)测试中,机器人在抓取咖啡机时遭遇人为移位与光照突变。CRIS-0 在平均 2 秒内即可识别出因果变量的改变并完成实时重规划,在 10 次随机扰动中实现了 9 次有效恢复。
更关键的是,它并非盲目地全流程推倒重来。
咖啡机被推开后,系统持续追踪的是「把手相对位姿」这一核心因果变量。当检测到变量状态发生偏移,它仅针对接近和抓取的动作阶段进行定向修正,无需回归原点重新初始化。
抗干扰只是基本功,在长程自主任务中,因果驱动的优势体现得更为彻底。
在「客厅寻物与整理」这类多达数十步的连续任务中,系统将长程目标拆解为原子化、可验证的因果阶段,每推进一个阶段都会严格执行前置与后置条件检查。
此外,CRIS-0 还展现出了出色的常识推理与物理感知能力:
- 情境理解与隐私意识:在清理桌面时,它会将散落的普通书本整理至茶几,而将涉及个人隐私的账单单独收纳进抽屉;
- 主动交互感知:面对两个外观相似的饮料罐,它会先通过轻微晃动抓取来感知罐体重量与内部液体状态,确认为空罐后才投进垃圾桶,感知到未喝完的饮料则稳稳放回原位。
在面对模糊需求时,因果机制还能显著提高提示词的泛化性,带来更深层的个性化理解能力。
在 Personal Pick and Place 测试中,面对类似「给我拿一瓶适合晨跑后喝的饮料」等 20 条包含隐含推理的模糊指令,系统取得了 18 次精准抓取与放置 的成绩。
它并非依靠表层关键词匹配去碰运气,而是结合时间、用户状态与环境上下文,将「运动后需要补充能量且避免高糖」作为隐藏因果变量抽取出来,自动生成并执行对应的操作方案。
拆解 CRIS-0:把黑盒改造成因果引擎
要解析这套技术架构,首先需要回答一个核心问题:为什么以往的机器人总是显得“笨拙”?
物理世界与纯数字世界存在本质差异。在计算机中编写代码或对话交流,输入错误尚可撤销;但在真实物理世界中,摩擦力、重力、刚体碰撞、光影变化等不可控因素随时都在发生。
传统的端到端模型(如 VLA 方案)虽然表征学习速度快,但在长流程任务中存在致命的“误差累积”缺陷:第 1 步出现微小偏差,第 2 步偏差继续放大,进行到第 10 步时,整体动作可能已彻底形变。更严重的是,单一黑盒模型在遇到外部干扰时无法归因,通常只能机械地按原计划执行,或者直接系统崩溃。
另一种常见的 Agent 方案虽然具备步骤拆解能力,但其底层思考逻辑大多停留在纯文本或多模态大模型的概率推理上。一旦环境发生改变,系统需要先将视觉画面转译为文本,再等待大模型逐步推理「下一步该做什么」;等模型推理完成,现实中的机械臂可能早已发生碰撞。
针对这些痛点,Aether AI 提出了一套因果原生(Causal-Native)的 Agent 架构,主要由三个维度构成:
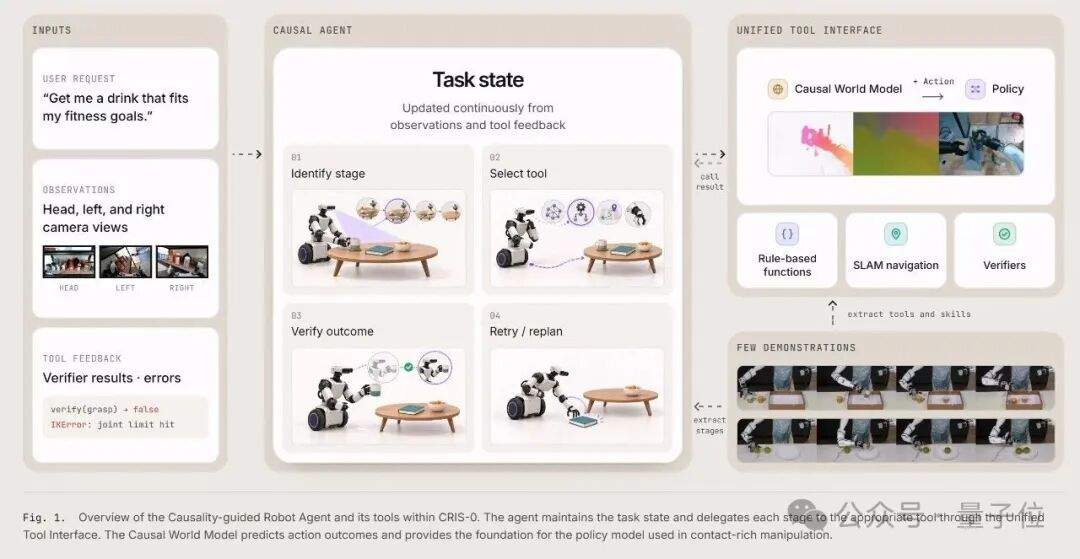
1. 任务即状态:提取物理因果变量
这是 CRIS-0 架构中最核心的第一性原理改造:统一状态与因果变量。
以往的机器人感知系统主要处理高维图像像素,而 CRIS-0 关心的并非环境表象,而是任务所处的因果状态进度。
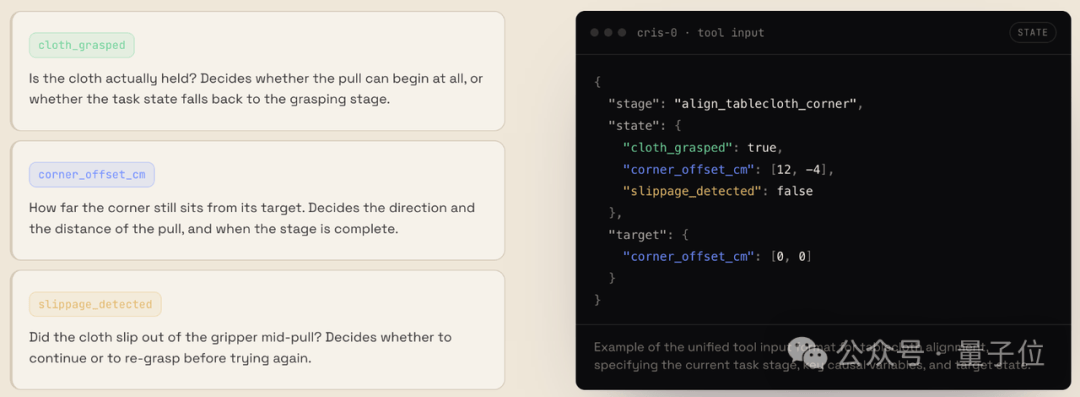
以机器人铺桌布为例:系统不会去逐个计算整张桌布每个像素的三维坐标,而是实时追踪几个核心因果变量——桌布是否被夹爪稳定夹持、桌布角点距离目标位姿的偏差、拉动过程中是否发生相对滑移。
一旦抓取脱落,系统能够立刻判定是「夹持」这一因果变量未满足条件,进而直接将任务状态回退到“重新抓取”阶段,而不是将整套操作推翻重来,更不会继续对着空气拉动物体。
在咖啡制作的扰动测试中,面对咖啡机反复移位与剧烈光照突变,系统平均在 2 秒内就能捕获关键因果变量的变化并完成局部重规划,达成 90% 的扰动恢复率。这正是因果变量的价值:一旦出现意外,系统能够清晰判断故障节点与回退边界。
2. 统一工具接口:拒绝单一策略包揽一切
在动作执行层面,CRIS-0 采用基于 Tool Call 的模块化机制,通过 Unified Tool Interface(统一工具接口)实现分工协作。
其架构中包含一个负责宏观调度的规划器(Planner),协调底层的多元化工具集:
- 规则运动函数(Rule-based functions):结合视觉定位与逆运动学,高效解决大范围空间转移与粗定位;
- 技能策略模型(Policy models):专门攻坚倒水、精细插拔等高难度接触式操作(Contact-rich tasks);
- 导航模块(SLAM):负责全局移动路径引导;
- 验证器(Verifiers):在每个关键节点执行物理状态核验;
- 因果世界模型(CausalWM):负责推演动作可能产生的物理后果。
其中,因果世界模型(CausalWM) 是核心关键。
当前主流的世界模型往往聚焦于生成逼真的未来视频画面,而 CRIS-0 中的 CausalWM 更聚焦于动作(Action)对环境造成的实质性物理影响。
其工作机理在于:基于当前状态,预测候选动作将驱动哪些因果变量改变,进而推导出未来的物理状态。
机械臂在实际动作输出前,已预先完成前向推演:如果执行动作 B,物理因果变量将如何演化、目标物体是否会失稳。系统在仿真模型中确认能够达成目标后,才会调用 Action Head 输出至底层控制器。
3. 结构化循环与原生安全内建
上述机制在闭环系统(Loop)中协同运行。
面对复杂任务,Planner 将高维目标拆解为结构化执行流:先调用规则运动函数将末端执行器快速移至目标邻域,再调用专用策略模型执行高精度接触抓取。原本单一模型难以端到端求解的复杂任务,被拆解为若干高确定性的局部子任务。
这一流程构成了动态演进的任务图(Task Graph):状态识别 → 工具选择 → 执行 → 验证 → 调整。
每完成一步,验证器都会立刻对物理前置/后置条件进行核验。若未达标,系统内置的三级恢复机制将依次启动:先在当前阶段尝试局部自愈;若无效则进行局部路径重规划;必要时再请求人工介入。一旦某种扰动下的恢复路径执行成功,该逻辑还会被沉淀到任务图中,提升后续同类场景的执行效率。
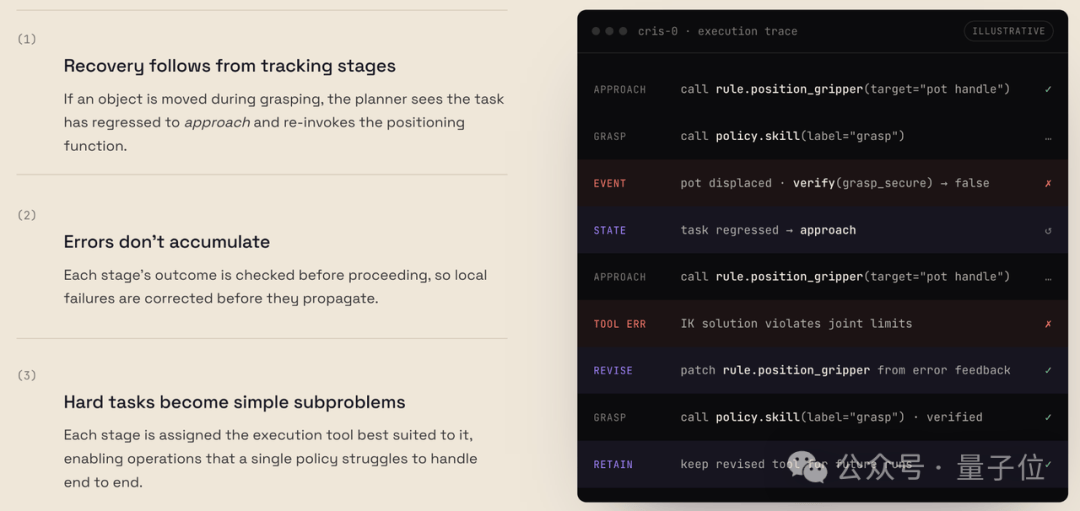
这也是系统在客厅长程整理任务中能够连续执行数十步而不崩溃的原因所在:由于每一步都在校验因果状态,局部误差在产生之初便被收敛解决,阻断了误差的扩散链条。
同样,这也是系统实现 0.2 秒安全急停的底层逻辑。
在 CRIS-0 中,安全约束被深度内嵌于每个因果状态。在关闭炉门阶段,突入的人手被判定为破坏安全约束的危险变量,系统在状态感知层会瞬间捕获并触发最高优先级的制动拦截,实现 0.2 秒悬停;若当前任务是向人类递送水杯,伸出的人手则被归类为交互目标变量,系统便会维持正常的协作流程。
CRIS-0 展现出的系统级能力,依托于团队前期的学术沉淀。
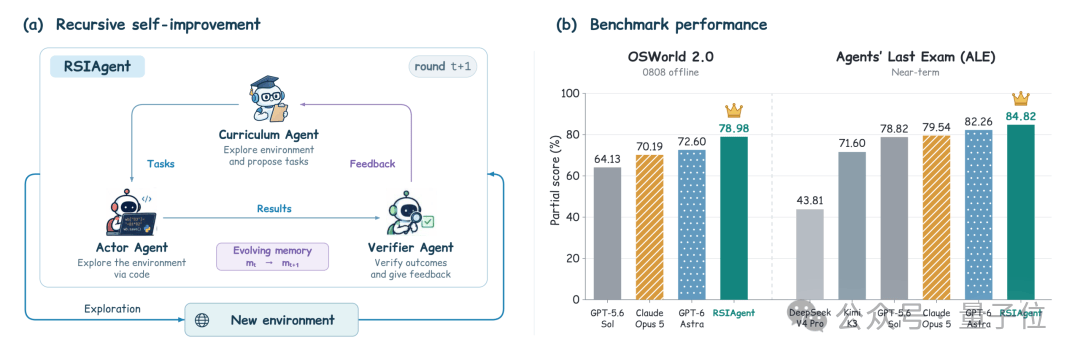
在 Agent 能力评估中,Aether AI 先前研发的因果智能体框架 RSIAgent 在 OSWorld 2.0 基准测试中取得了 78.98% 的 Partial Score。该方案在不微调底层模型参数的前提下提升了开源模型的 Agent 能力,评测表现优于 GPT-6 Astra 等闭源模型。
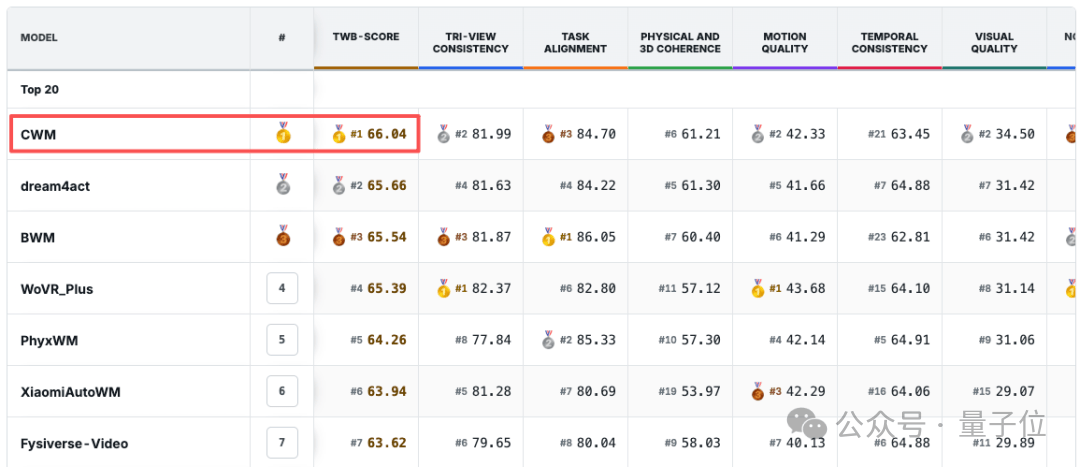
其第一代因果世界模型 CausalWM 也在机器人世界模型基准 TriWorldBench 上取得榜首(Top-1)成绩。
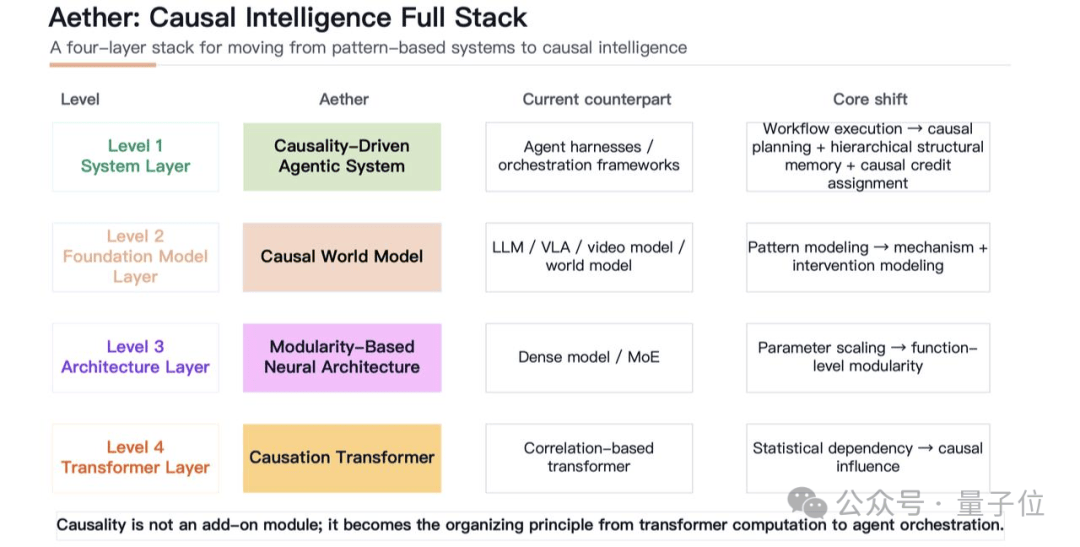
这两层技术构成了本次系统 Demo 的核心骨架。
此外,该技术体系还在推进另外两层架构的演进:一是对应不同物理机制、可组合替换的模块化神经架构;二是致力于捕捉因果机制而非表面统计相关性的 Causation Transformer。
物理世界不相信死记硬背
跳出具体的机器人 Demo,因果智能之所以愈发受到产业界重视,源于具身智能底层的瓶颈约束。
大语言模型的快速发展,很大程度上得益于自然语言本身是人类高度符号化、高度抽象的概念空间。海量常识与逻辑规律已内嵌在文本表层,通过高维概率统计与数据规模叠加,能够展现出强大的泛化能力。
然而,真实的物理世界并不遵循纯概率推断。
摩擦力与重力等客观规律具有绝对性,并不因文本数据的统计分布而改变。在高度动态的真实世界中,若完全依赖表层特征的拟合,系统迟早会遭遇 Scaling Law 的边际递减瓶颈。
在物理交互数据相对稀缺的前提下,构建高鲁棒性的物理交互系统,要求模型必须具备类似科学家的归纳能力:从有限观测中提炼底层的因果机理,推理出特定行为将对物理世界产生何种改变。这种以因果为核心的结构化建模,正在成为具身智能领域探索新型 Scaling 范式的重要方向。
因果发现与因果表征学习对数学和统计理论基础要求极高,全球兼具深厚理论储备与复杂系统工程落地能力的团队相对稀缺。
黄碧薇长期深耕该领域,师从 CMU 因果学派奠基人 Clark Glymour、Peter Spirtes 以及知名学者 Bernhard Schölkopf 与 Kun Zhang,是因果学派代表学者之一。三代因果学派的理论演进,构成了 Aether AI 现有技术路线的核心依托。
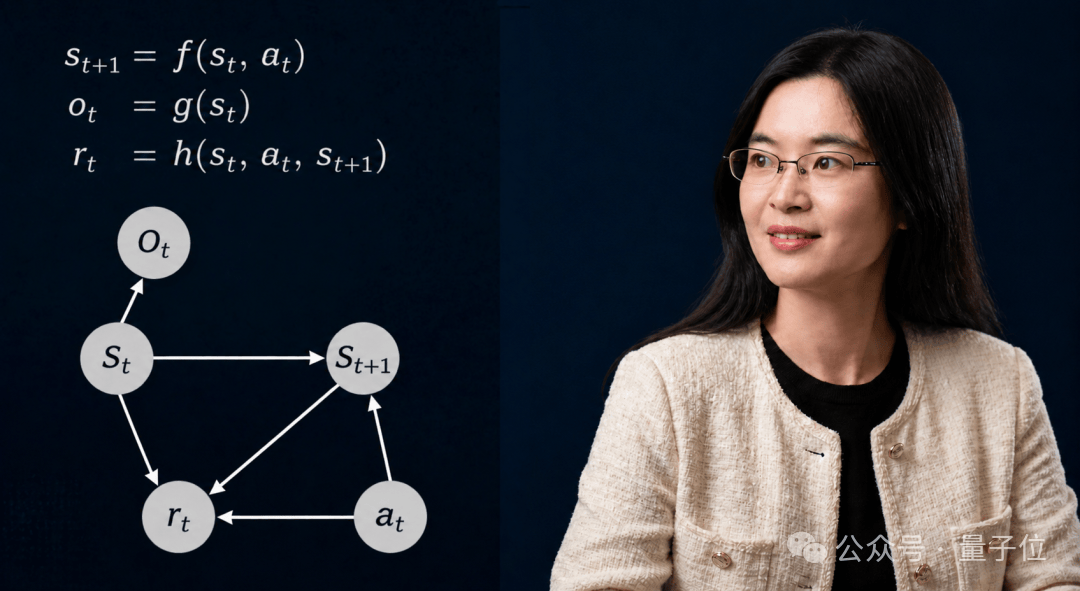
从卡内基梅隆大学与马普所的理论验证,到 CRIS-0 在真实物理机械臂上的落地部署,因果智能完成了走向物理交互的关键跃迁。
当一套计算架构具备了提取因果变量、建模物理动态并在行动前推演未来状态的能力,其应用边界将不仅限于家庭生活助理。在复杂动态系统的长期趋势预测、新型材料研发以及计算生物学等前沿领域,因果表征学习同样具备广泛的落地潜力。
推动人工智能走出纯数字对话框、稳定立足于复杂多变的真实物理世界,因果机制正在成为打开这扇大门的重要钥匙。