
Hugging Face Community Evals 如何与 EvalEval 协同工作
Every Eval Ever(EEE)和 Hugging Face Community Evals 现在已经互相兼容。我们支持交叉发布和解读评测结果,同时关联开源模型、排行榜和统一的标准化元数据存储。
EEE 于 2026 年 2 月作为 EvalEval Coalition 的一个项目上线,是首个跨机构努力,旨在改进 AI 评测结果由一方和第三方评测者报告时的呈现方式。Hugging Face 也在 2026 年 2 月推出了 Community Evals,以去中心化方式管理 Hub 上基准分数的发布。两者结合起来,弥补了用户、研究人员和政策制定者在信任、理解和选择评测与模型时的缺口。
评测结果是我们衡量模型能力、相互比较模型,以及推理安全与治理的方式,但这些结果往往分散且难以比较。它们存在于论文、排行榜、博客文章以及评测框架日志等各处,而且格式各不相同。即使是同一个模型在同一个基准上,不同执行者和不同设置下也常常得到不同分数;例如,LLaMA 65B 在 MMLU 上曾被报告为 63.7 和 48.8 两个不同结果。这些差异可能源于我们发现普遍未被报告的评测设置。
EEE 解决的是报告环节的问题。它用一套 JSON schema 来描述评测结果,记录:
- 谁执行了评测
- 哪个模型
- 通过何种方式访问
- 生成设置
- 指标的实际含义
- [推荐] 用于逐样本输出的配套 JSONL 文件
该 schema 结合了研究人员和政策研究人员的反馈构建而成,可接收来自任何来源的结果,因此评测框架日志、排行榜抓取结果和论文中的数值最终都会被统一成同一种格式。GitHub 仓库 中提供了转换器、示例和贡献指南。自上线以来,Hugging Face 上的 datastore 已增长到约 22.9 万条评测结果,覆盖 2.2 万多个模型和 2200 个基准,来自 31 种不同的报告格式。仅从头复现这些运行就可能花费数十万美元,这也充分说明:既然已经付出成本生成数据,就不应让它再次四散。
了解更多关于该 schema 以及如何贡献的内容,请见这里。
现在,它还拥有更好的集成与归因能力。贡献者现在可以将 EEE 结果发送到 Hugging Face Community Evals。我们构建了一个转换器,可以将你的 EEE 记录写成 Hugging Face 所需的小型 YAML 文件,因此你无需手动维护两种格式的同一份结果。
这不仅是面向现有 EEE 贡献者的新功能,也适用于所有发布或阅读评测结果的人。既为自己模型做一方评测、也为他人模型做第三方评测的人,都可以同时提交到 Community Evals 和 EEE;而在 Hub 上浏览的人,则能看到可追溯到完整记录的结果。当你通过所在机构的官方 Hugging Face 账号提交数据时,你的结果会在 EvalEval 上显示已验证标记,向读者表明这些数字直接来自源头。下文将介绍 Community Evals 的工作方式以及转换器的作用。
Hugging Face Community Evals 如何与 EvalEval 协同工作
Hugging Face Community Evals 有两个部分。
一个基准(benchmark)位于数据集仓库中,通过添加 eval.yaml 来完成注册。一旦注册,该数据集页面就会收集并展示在整个 Hub 上针对它报告的所有分数排行榜。 官方基准 列表也会不断扩展。
模型的分数存放在模型仓库中的 .eval_results/*.yaml 里。它们会显示在模型卡片上,并进入对应基准的排行榜。模型作者自己提交的结果,以及任何人通过 pull request 提交的结果,都会被汇总;每个分数都会带有一个徽标,说明它是作者提交、社区提交,还是独立验证。任何人都可以通过提交包含正确 YAML 文件的 PR 来为任意模型添加分数,而模型作者也可以关闭 PR 或在自己的仓库中隐藏结果。
下面是其中一个排行榜的样子:
Hub 上 Humanity’s Last Exam 的 Community Evals 排行榜
这就是 EEE 和 Community Evals 的结合点。当你将一个结果同时发送给两者时,会发生两件事:第一,你的分数会出现在 Hugging Face 模型页面上,并被拉入该基准的排行榜;第二,它会带有一个来源徽标,直接链接回完整的 EEE 记录,其中包含生成配置、框架版本、可复现性说明以及任何实例级数据。
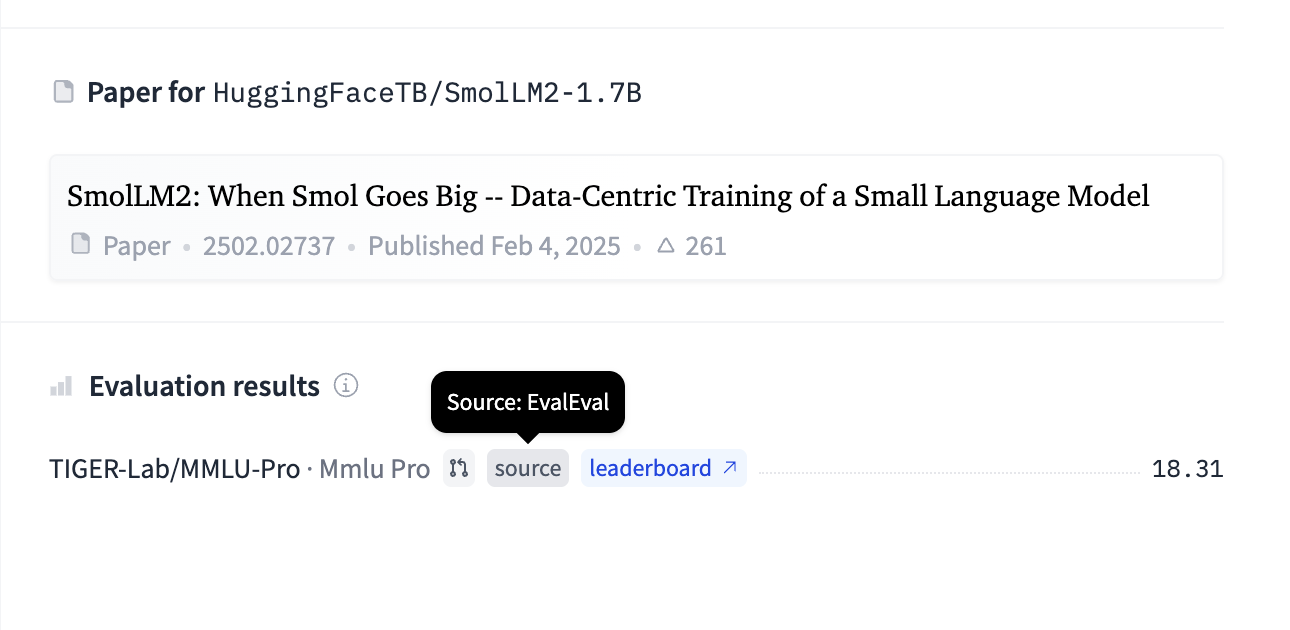
来自 EEE 数据存储(datastore)的一条评测(MMLU-Pro),在文件级别与 Hugging Face 模型卡片(b)进行交叉链接。来源 EvalEval 徽标链接到完整的 JSON 记录。
**这两个去向在同一个目标下承担不同职责。Hugging Face 把你的结果放到人们查看模型的地方,并附上指向来源的链接。EEE 则保留完整的结构化记录,使结果可被解读,并在此基础上支持 Eval Cards。**把数据同时发送到两边,同一条评测就能既可见又可读,这也正是发布评测的意义所在。
你可以在下方看到这种互操作性。上面模型卡片中展示的相同 GPQA 分数,也会在 Eval Cards 中渲染出来;Eval Cards 将 EEE 的运行数据与基准和模型元数据组合成一份可解读的记录。是同一条评测,只是呈现方式不同:
工作原理
Hugging Face 将评测分数存储在模型仓库中