
用于密度与 score 估计的 Transformer 训练
📄 技术报告: arxiv.org/abs/2511.05924

机器学习和科学中的许多问题都可以归结为同一类任务:你有一组数据点,想要恢复它们来自哪个分布——哪些取值更常见,哪些更少见。要刻画这个分布,就需要估计两个量:分布的密度,以及在高维情形下更有用的 score。密度可以理解为直方图的平滑版本——数据点聚集的地方密度高,稀疏的地方密度低。score 则是对数密度的梯度,它指向密度增长最快的方向:沿着 score 移动一个点,它会朝着更可能的区域前进。
基于扩散的生成模型(Stable Diffusion 和 DALL·E 等 AI 图像生成器背后的技术)从随机噪声开始,不断沿着 score 方向前进,把噪声转化为逼真的图像。同样的 score 也驱动贝叶斯采样,以及用于模拟等离子体等系统的粒子模拟。
从有限样本中提取密度和 score 颇具挑战,而现有工具迫使我们在泛化性和准确性之间做取舍。经典方法之一——核密度估计(kernel density estimation, KDE)——会根据某一点周围的数据点来计算该位置的密度:离得越近、数量越多,密度就越高。它无需训练,且适用于任意分布,但随着维度升高,其准确性会迅速下降。另一种方法是神经网络 score matching 模型,它们经过训练来预测 score,即使在高维空间中也能保持较高准确性,但每个模型都必须学习一个具体分布,并且面对另一个分布时需要从头重新训练。
我们提出一种名为 DiScoFormer(Density and Score Transformer) 的新方案——只需一个模型,在给定一组数据点的情况下,就能在一次前向传播中同时估计分布的密度和 score,无需重新训练。
[
](#training-a-transformer-for-density-and-score-estimation)
  用于密度与 score 估计的 Transformer 训练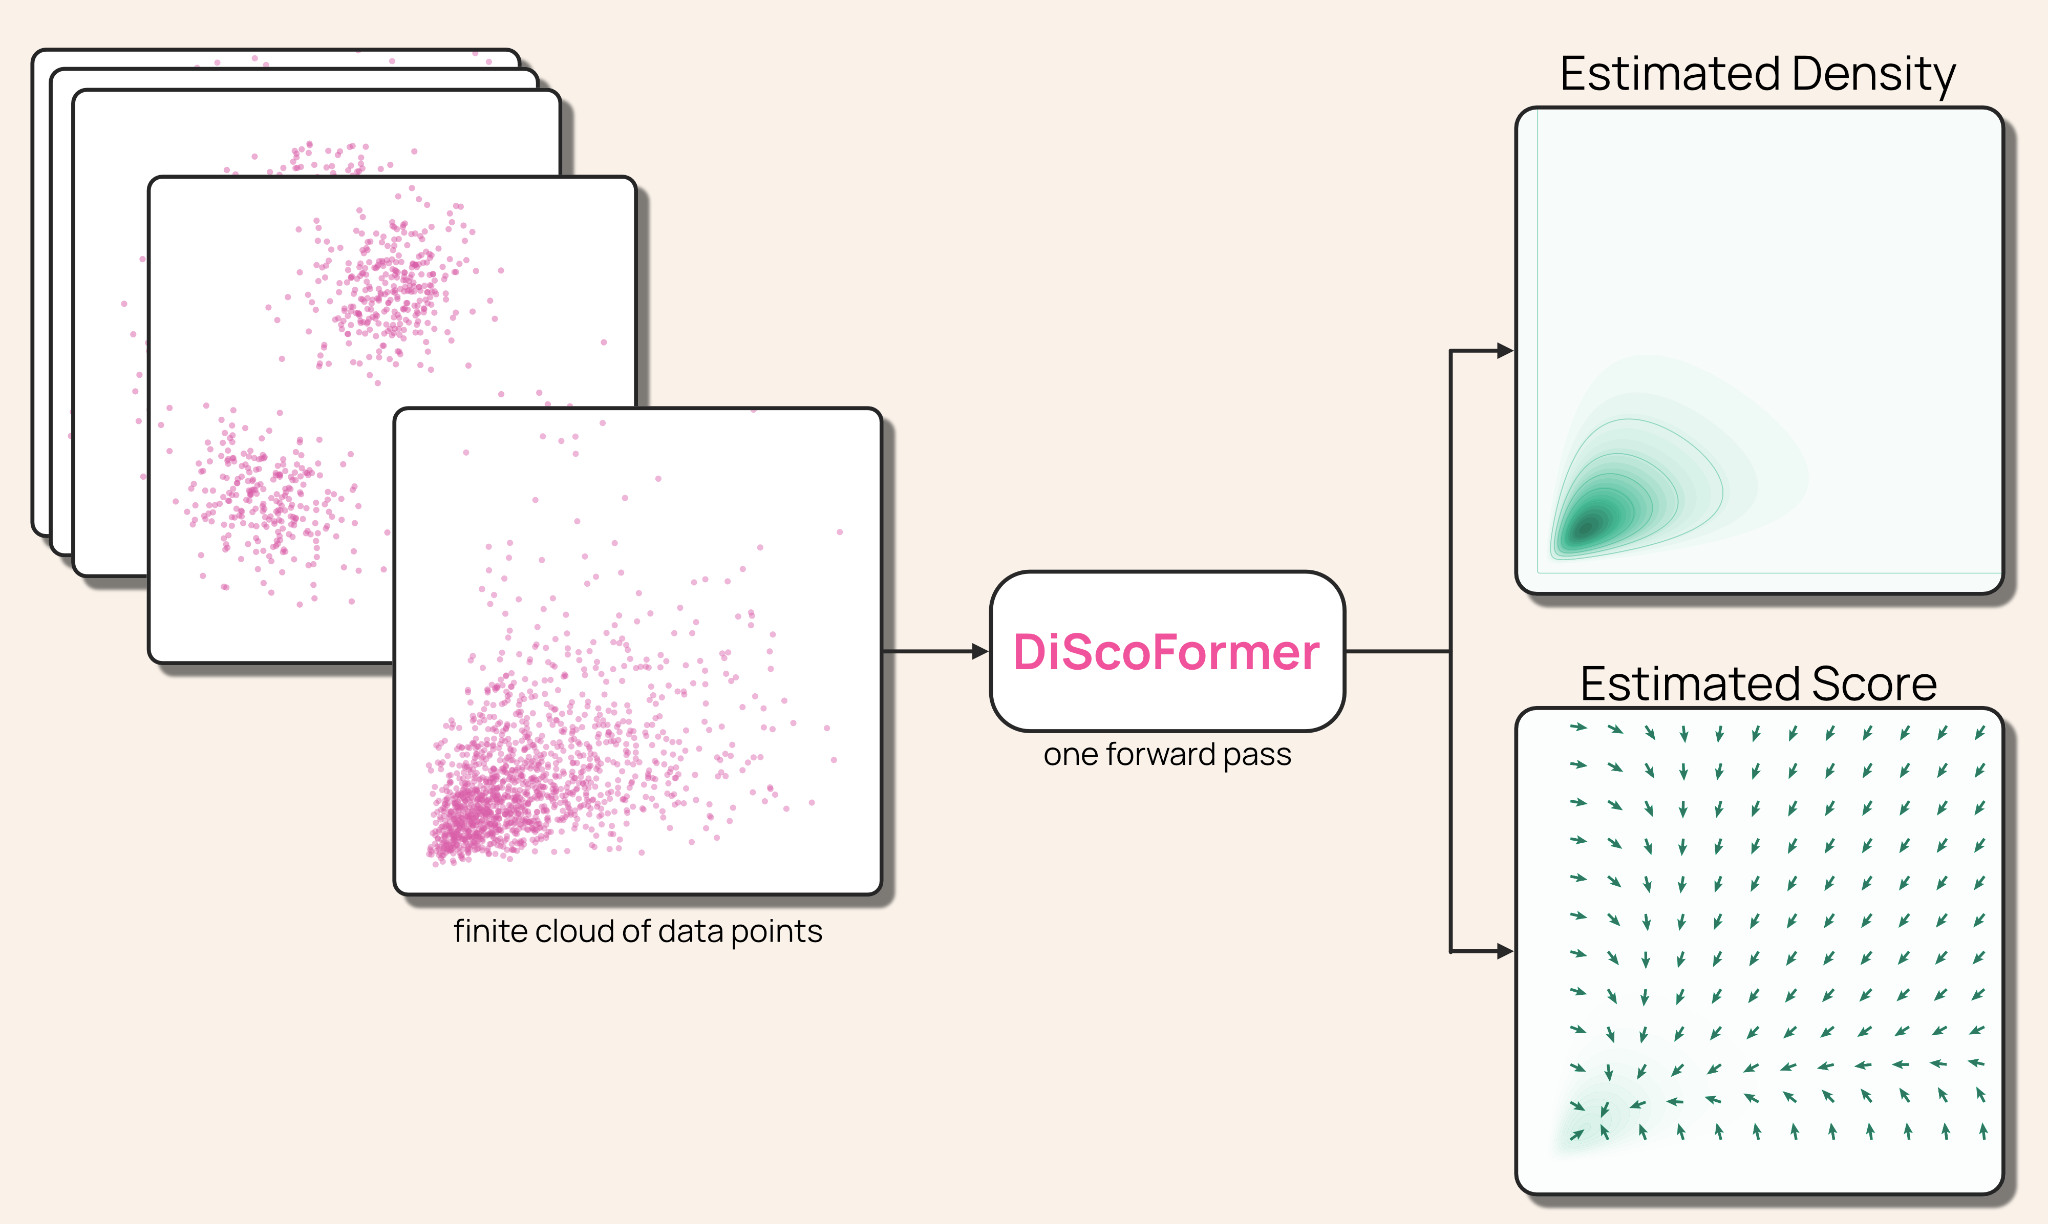
DiScoFormer 使用堆叠的 Transformer block,将整个样本映射为其背后分布的密度和 score。该模型利用交叉注意力(cross-attention),使其不仅能在已有数据点上,还能在任意位置评估密度和 score。score 与密度在数学上存在关联:score 是密度对数的梯度。我们利用这一点,共享一个主干网络,并设置两个输出头:一个输出密度,一个输出 score。
这种耦合不仅节省参数。score 头在每个查询点上都必须与 log-density 头的梯度一致,因此两者之间的任何差距都可作为一种无需标签的一致性损失(consistency loss)。我们在推理阶段利用这一点——固定上下文,对该一致性损失做几步梯度更新,DiScoFormer 就能即时适应分布外输入,无需真实的密度或 score 作为监督。
Transformer 架构适合这项任务是有数学原因的。核密度估计只有一个带宽(bandwidth)——也就是每个点的影响范围,预先设定并在所有位置统一应用。注意力机制是它的严格推广:我们从解析上证明,单个注意力头的权重几乎就是数据上的高斯核,因此一个交叉注意力 block 就已经可以复现 KDE 的密度和 score。在此基础上,模型还能进一步学习多个不同尺度,并根据数据自适应调整。DiScoFormer 并不是把经典方法当作黑箱替代掉,而是将 KDE 作为一个特例纳入其中,并在此基础上加以改进。
我们用什么数据来训练 DiScoFormer?主要基于两个原因,我们采用了高斯混合模型(Gaussian Mixture Models, GMMs)。第一,GMM 是通用密度逼近器——只要组件足够多,它就能以任意小的误差逼近几乎任何平滑分布。第二,GMM 的密度和 score 都有闭式表达式,因此我们总能得到精确的监督目标。我们利用这两个性质:为每个 batch 采样一个新的 GMM,使模型几乎拥有无限多的目标分布示例,并针对每个 GMM 的精确密度和 score 进行监督。
[
](#performance)
  性能
总体而言,DiScoFormer 在密度估计和 score 估计上都优于 KDE,而这种差距在 KDE 最吃力的地方最为明显。在 100 维空间中,两者根本不在一个量级——与经过最佳手工调参的 KDE 相比,它将 score 误差降低了约 6.5 倍,密度误差降低了 37 倍以上;而且随着样本增多,它仍在持续提升,KDE 则已经内存耗尽。它也能很好地泛化到训练数据之外:在模式数比训练时更多的混合分布上,以及在 Laplace 分布和 Student-t 分布等非高斯形状上,依然保持准确。KDE 主要的优势仍然是速度,尤其在数据集较小时更明显。
我们认为 DiScoFormer 最令人期待的地方在于:score 估计是许多领域共享的基础能力,例如生成建模、贝叶斯推断和科学计算。一个预训练、即插即用的估计器,若能在高维场景下保持准确,并免去针对每个问题重新训练的成本,就有望同时降低这些领域的开销——一个模型,可在所有需要 score 和密度的地方复用。
我们鼓励你阅读我们的技术报告以了解更多细节。