
大语言模型(LLM)如今已成为代码生成、数学题求解、摘要生成、文档理解以及许多其他开发者工作流的默认接口。不过在底层,许多 LLM 生成文本的方式仍然相同:一次生成一个 token,而且每个 token 都依赖于之前出现的 token。因此,这类模型被称为自回归(autoregressive),因为它们会消费自己生成的输出。
这种自回归(AR)方法取得了非凡的成功。它训练稳定、服务简单,并推动了现代语言建模的很大进展。但它也带来了一个硬性限制:每生成一个新 token 都需要完整跑一遍模型,并且在计算开始之前,所有权重都必须从内存中加载出来。对于构建低延迟应用、使用更小批量,或希望更充分利用现代 GPU 的开发者来说,逐 token 生成会留下性能空间未被挖掘,因为 GPU 大部分时间都花在内存操作上,而不是计算上。
此外,一旦自回归模型生成了一个 token,它就是最终结果,模型本身并不具备修订前文 token 的能力。因此,错误会在生成过程中持续传播。
Nemotron-Labs Diffusion 提供了一条新的路径:扩散语言模型(DLM),它通过并行生成多个 token,然后在多个步骤中迭代精炼这些生成的 token。不仅如此,这类模型还能更好地利用现代 GPU 的计算模式,并带来显著的运行时性能提升;同时,它们也能够修订已生成的 token,因此更适合对现有文本进行改写,以及处理中间填空(fill-in-the-middle)目标。这种“生成—精炼”的特性还提供了一种内建方式来控制推理预算。通过减少精炼步数,就可以降低这些模型在运行时的计算需求。
快速链接:模型、训练配方和技术报告
Nemotron-Labs Diffusion 系列包括 3B、8B 和 14B 规模的文本模型,全部基于对商业使用友好的 NVIDIA Nemotron 开源模型许可证发布;此外还有一个 8B 规模的视觉语言模型(VLM),基于 NVIDIA 源代码许可证发布,提供更广泛的研究灵活性。整个产品线中,NVIDIA 既发布基础模型,也发布指令微调后的聊天变体。NVIDIA 还通过 NVIDIA Megatron Bridge 框架发布了训练这些模型的代码。
单一模型中的三种生成模式
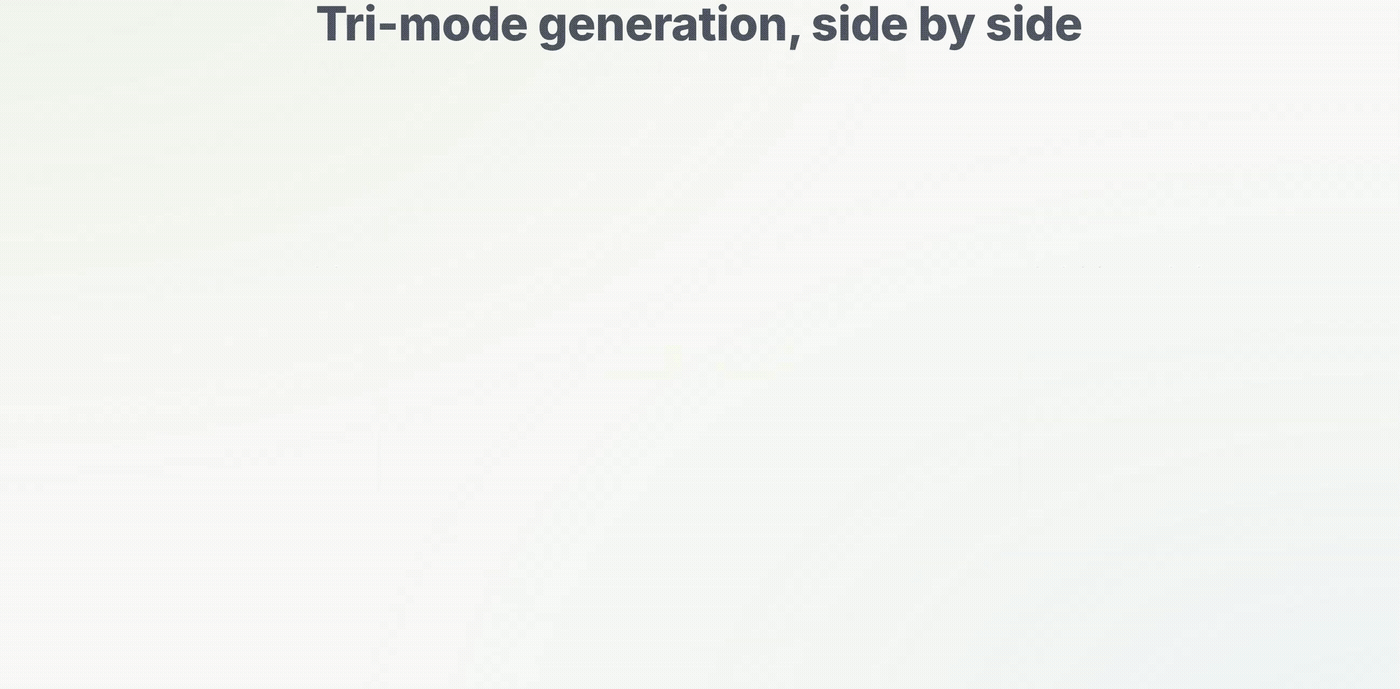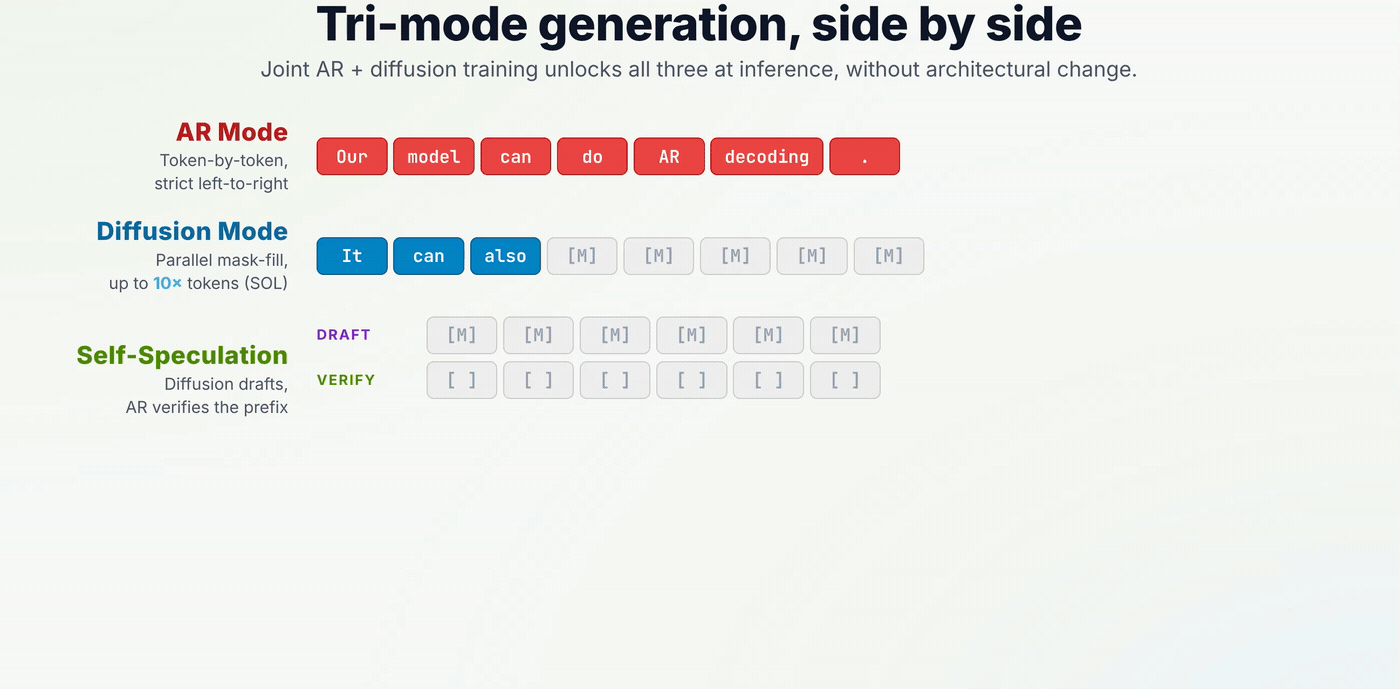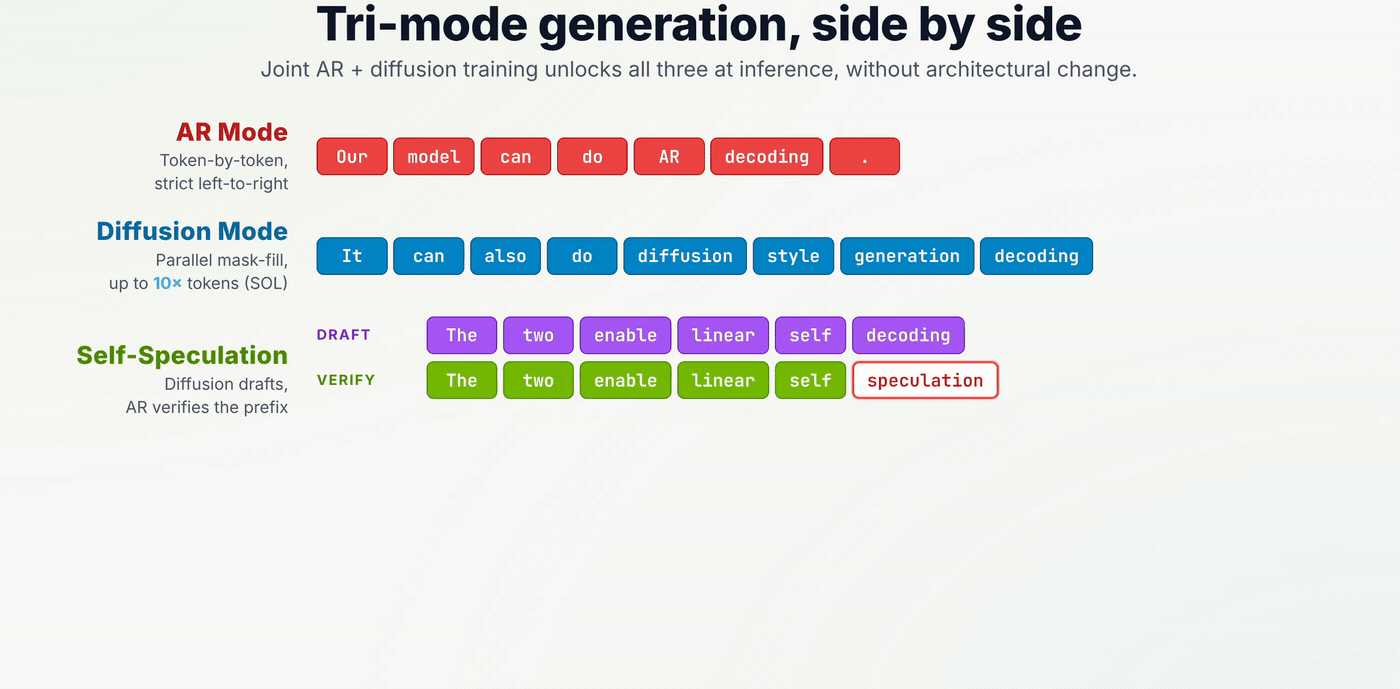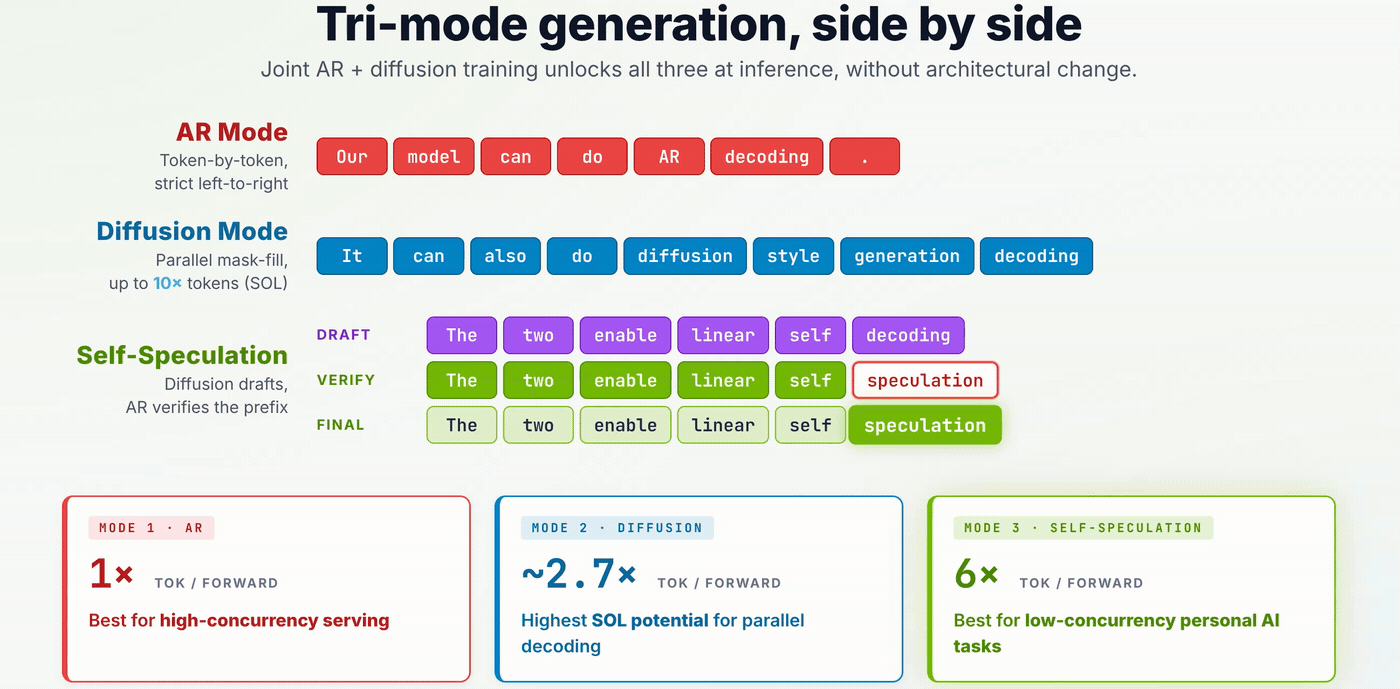
Nemotron-Labs Diffusion 的设计基于一个简单的理念:自回归生成和扩散生成不应该是两个彼此独立的模型家族,而应该是同一个模型所具备的能力。该模型支持三种生成模式:
自回归模式 按照标准的从左到右 LLM 方式运行。这保持了与开发者已经熟悉的生成工作流的兼容性。
扩散模式 按块生成,并在多个步骤中逐步生成 token。
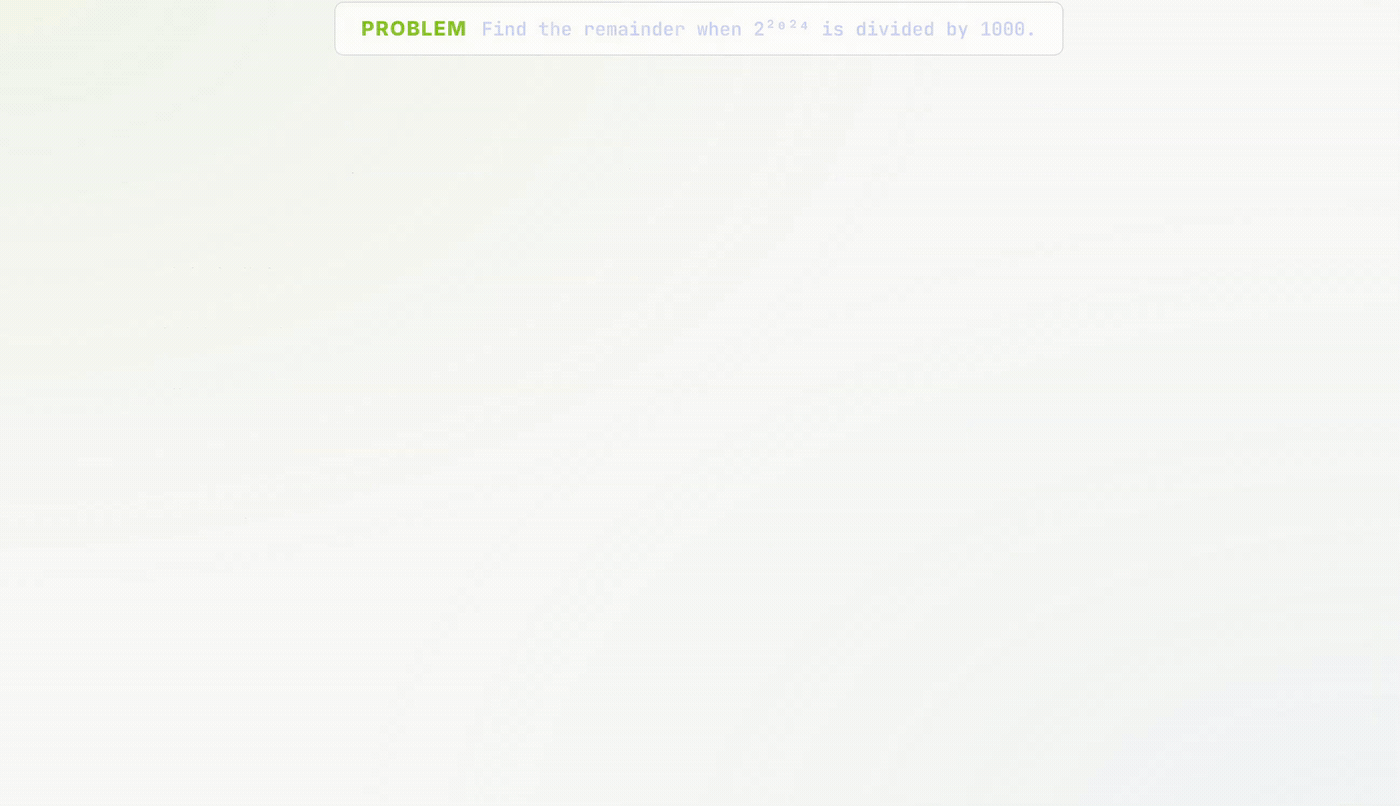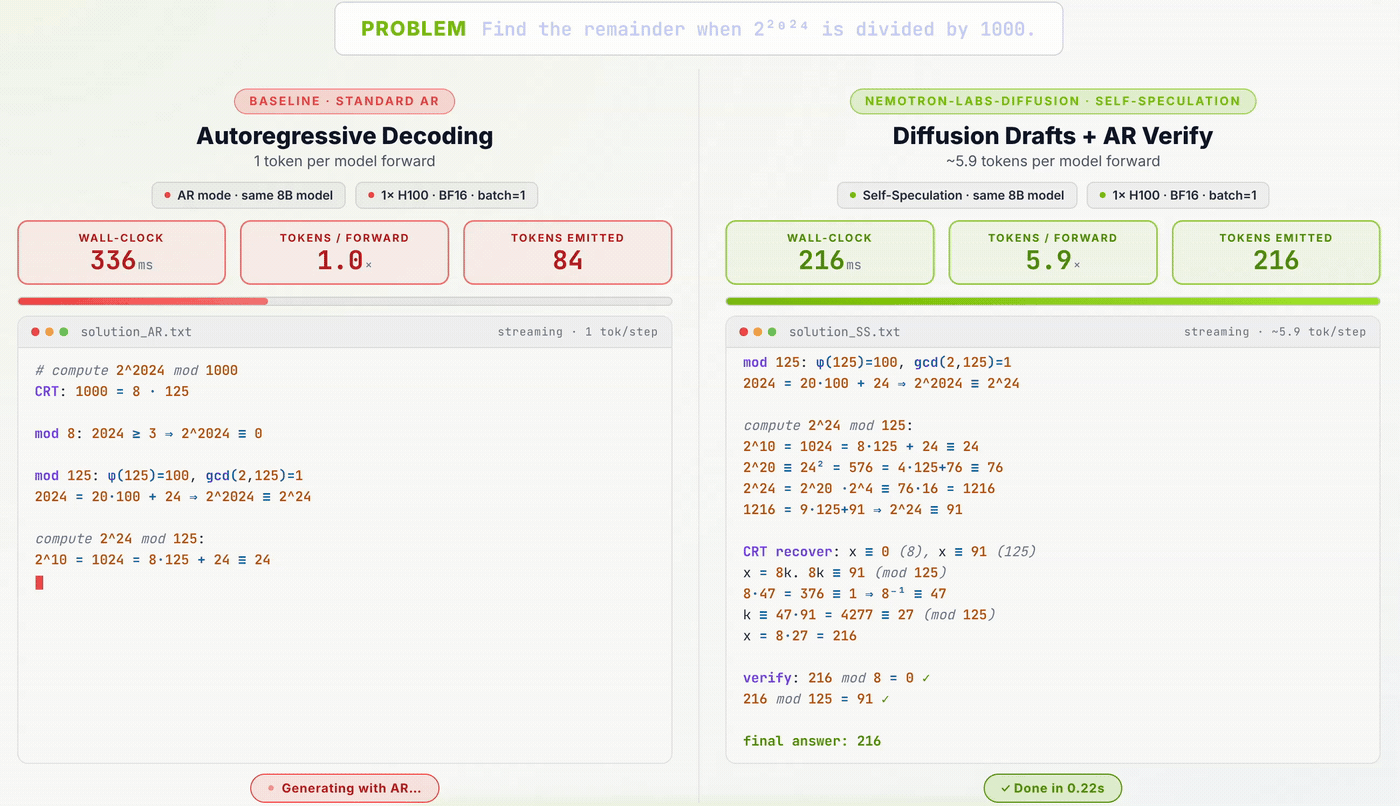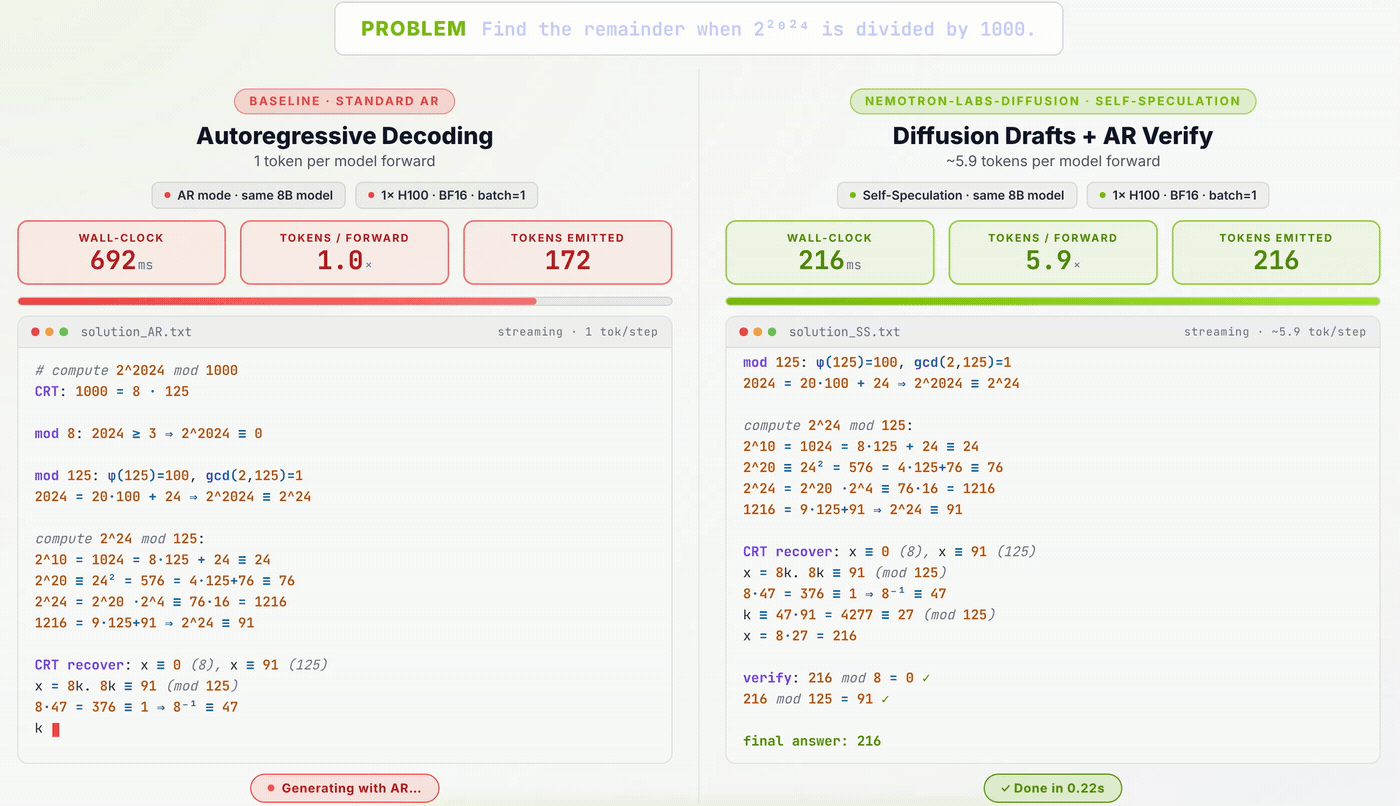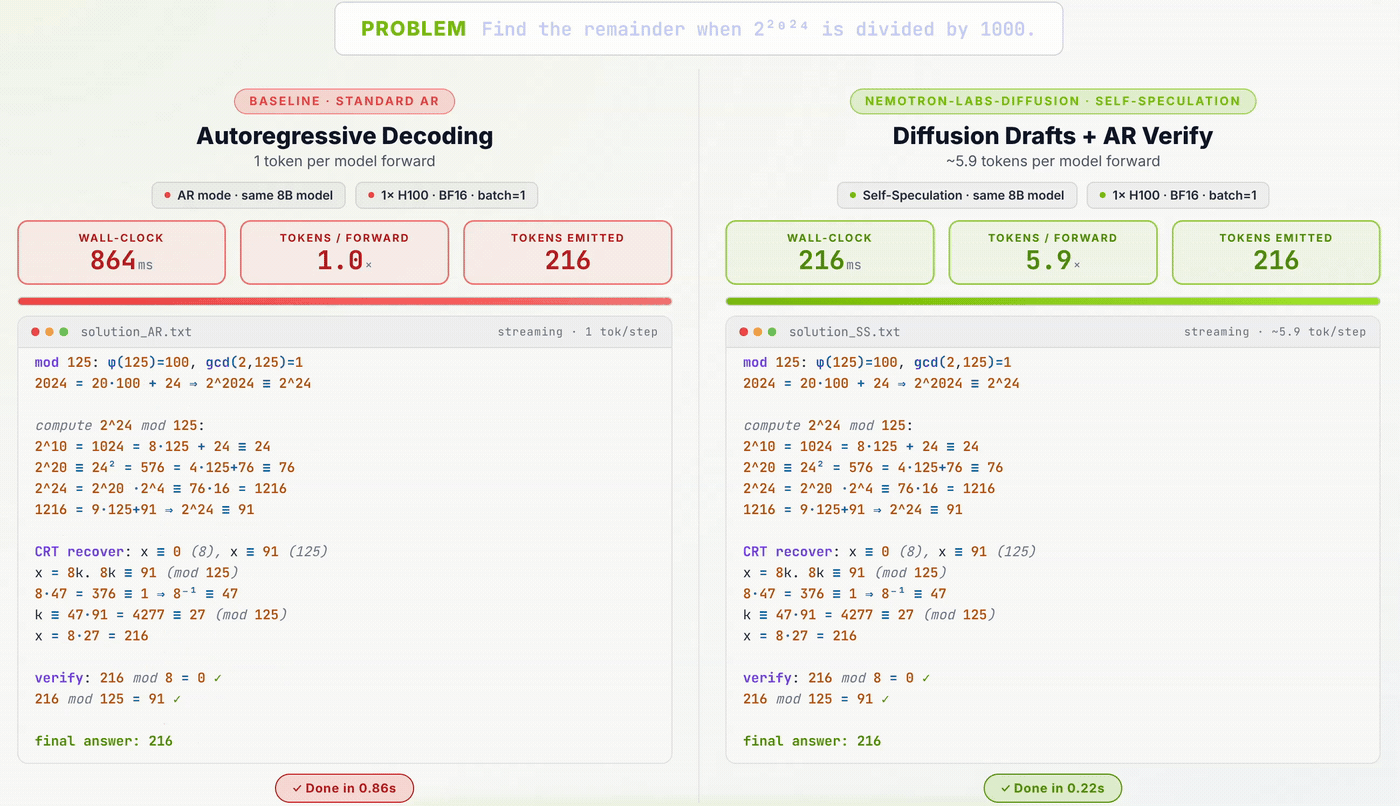
自我推测(self-speculation)模式使用扩散来起草多个候选 token,然后用自回归解码对其进行验证。这样结合了扩散式草拟的速度潜力与 AR 验证的可靠性。
这种灵活设计是面向开发者的关键特性,即使在批量大小不可预测的工作负载下,或只有单次查询的场景中(batch size=1),它也能兼顾速度与准确性。选择所需的推理模式几乎不需要在应用层做任何改动,因为这只是一个部署时设置。因此,开发者可以无缝切换到他们当前使用的模型,或者在多种推理模式下使用 Nemotron-Labs Diffusion,以获得超快的生成速度。
性能亮点
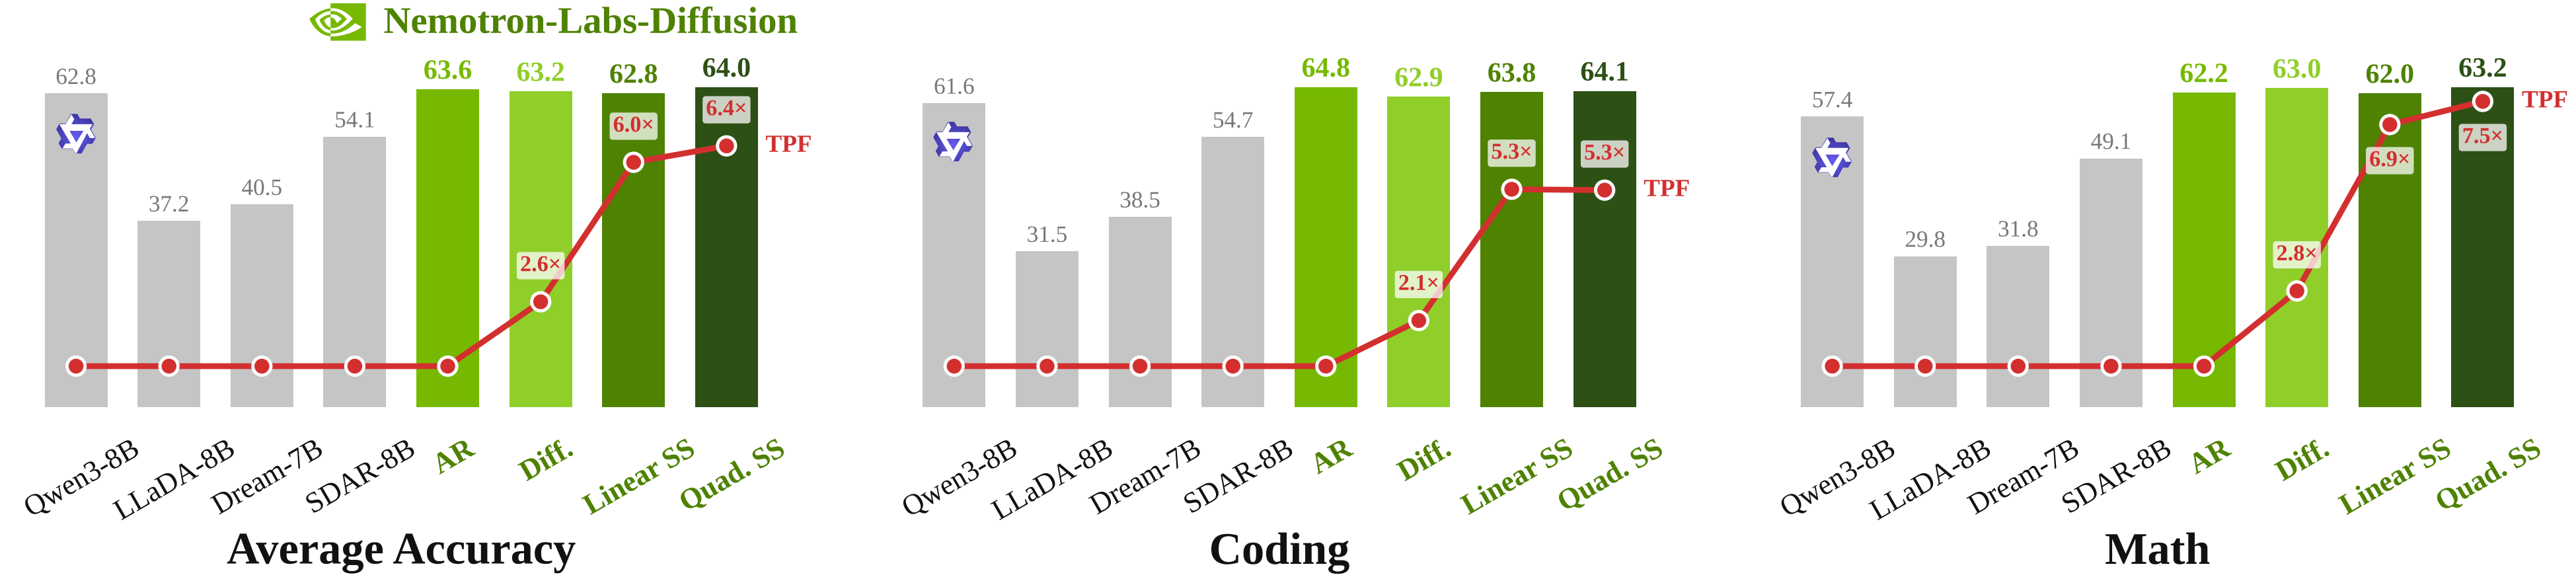
与 Qwen3 8B 相比,Nemotron-Labs Diffusion 8B 的平均准确率提升了 1.2%。在以每次前向传播 token 数(TPF,token per forward pass,作为一种与硬件无关的 token 解码效率衡量方式)计算推理速度时,扩散模式的 TPF 比 AR 模型高 2.6 倍,而自我推测进一步将这一数值提升到线性自我推测的 6 倍,以及二次自我推测的 6.4 倍,同时在所评估任务上的准确率相当。
我们如何训练 Nemotron-Labs Diffusion
扩散语言模型多年来一直很有前景,但历史上也存在一些实际障碍:与强大的 AR 模型相比准确率更低、训练更困难,以及与 KV 缓存的兼容性有限。
近期工作改变了这一方向。Efficient-DLM 表明,可以通过继续预训练并将注意力机制改为按块处理的方式,把预训练的 AR 模型转换为扩散语言模型。这种设计有助于保留 AR 模型的能力,同时支持对 KV 缓存友好的并行解码。
Nemotron-Labs Diffusion 建立在同样的实用洞见之上:为现有 AR 模型加入扩散能力。该模型采用联合 AR 与扩散目标进行训练,使其在保持初始 AR 训练中所学知识的同时,借助扩散增加并行草拟能力。模型先使用来自 NVIDIA Nemotron 预训练数据集 的 1.3T token 进行预训练,随后又使用来自 NVIDIA Nemotron 后训练数据集 的 45B token 进行了额外的监督微调。