
介绍 Ettin Reranker 系列
发布于 2026 年 5 月 19 日
TL;DR
今天我发布了 6 个新的 Sentence Transformers CrossEncoder 重排序器(reranker),它们在各自规模上都达到了最先进水平。这些模型基于 Ettin ModernBERT 编码器构建,同时还公开了生成这些模型所用的数据和完整训练配方:
cross-encoder/ettin-reranker-17m-v1cross-encoder/ettin-reranker-32m-v1cross-encoder/ettin-reranker-68m-v1cross-encoder/ettin-reranker-150m-v1cross-encoder/ettin-reranker-400m-v1cross-encoder/ettin-reranker-1b-v1
这些模型采用了蒸馏配方训练:在 cross-encoder/ettin-reranker-v1-data 上,对 mixedbread-ai/mxbai-rerank-large-v2 的分数进行逐点 MSE(均方误差)训练;该数据集是 lightonai/embeddings-pre-training 的一个子集,并混合了 lightonai/embeddings-fine-tuning 的一个重排序子集。
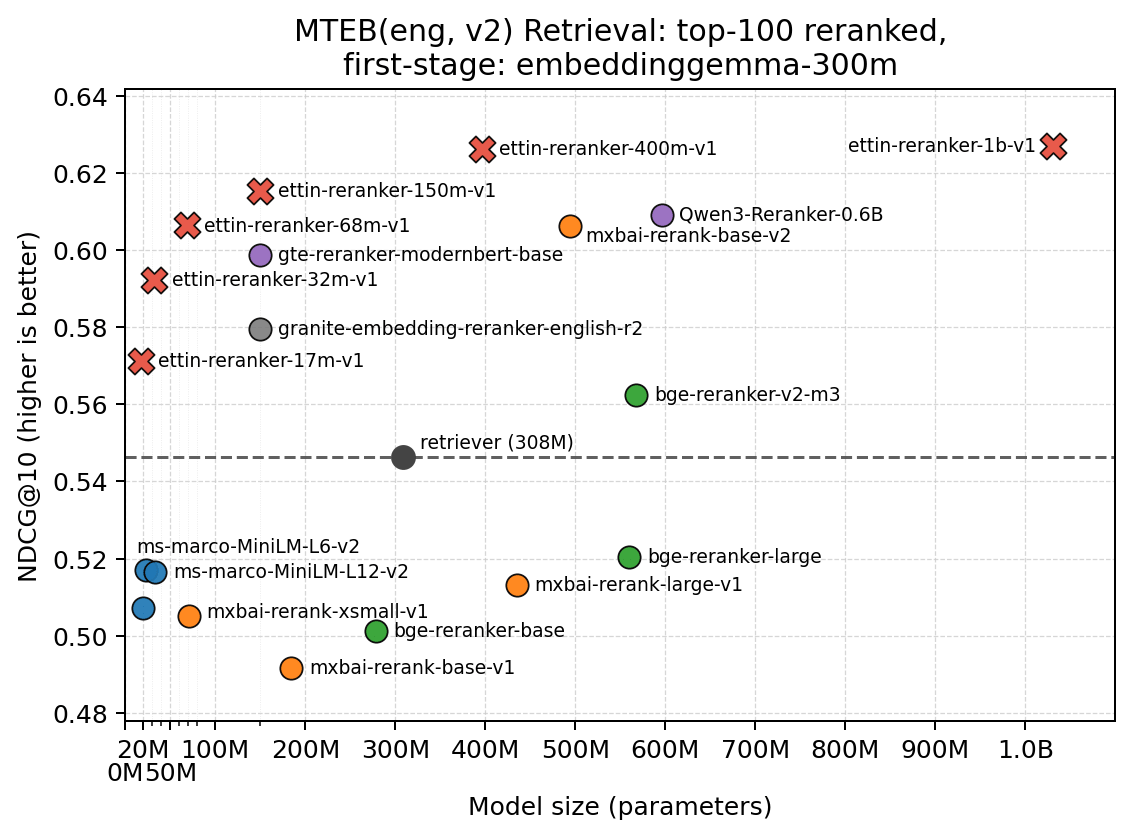
我们这 6 个重排序器与 google/embeddinggemma-300m 搭配,在 MTEB(eng, v2) Retrieval 上的表现。更多 embedding 模型组合见 Results。
如果你刚接触 reranker,并且想先了解“为什么要用”,请跳到 什么是 reranker,以及为什么要和 embedder 搭配?。如果你只想直接使用模型,请跳到 用法。如果你想训练自己的模型,请跳到 训练。
我用 Sentence Transformers v5.5.0 中新增的
train-sentence-transformersAgent Skill 对下面的训练配方进行了启动。可通过hf skills add train-sentence-transformers [--global] [--claude]安装它,并让你的 AI 编码代理(Claude Code、Codex、Cursor、Gemini CLI 等)在你的数据上微调SentenceTransformer、CrossEncoder或SparseEncoder模型。