
OlmoEarth v1.1:更高效的地球观测模型家族
团队文章,发布于 2026 年 5 月 19 日
🧠 模型:https://huggingface.co/collections/allenai/olmoearth | 📄 技术报告:https://allenai.org/papers/olmoearth_v1_1 | 💻 代码:https://github.com/allenai/olmoearth_pretrain
我们在 2025 年 11 月发布了 OlmoEarth(v1)。此后,合作伙伴已将其应用于广泛的任务中,从追踪红树林变化、分类森林损失驱动因素,到在数天内生成国家尺度的作物类型地图,并将部署规模扩展到国家、洲际乃至全球范围。每一次发布都让我们更接近使命:把最先进的 AI 带给致力于保护人类和地球的组织与社区。
当 OlmoEarth 处理卫星影像,在数万到数十万平方公里范围内进行预测时,效率决定了许多事情的可能性。在运行 OlmoEarth 的整个生命周期中——数据导出、预处理、推理和后处理——计算成本无疑是最高的。更高效的模型意味着我们可以在 OlmoEarth Platform 上支持更多合作伙伴,也意味着任何自行运行 OlmoEarth 的用户都能更快、更低成本地利用这项技术。
这就是我们构建 OlmoEarth v1.1 的原因:一个新的模型家族,在我们与合作伙伴共同构建的一系列研究基准和任务上,保持 OlmoEarth v1 性能的同时,将计算成本最高降低 3 倍。
通过缩短序列长度提升效率
OlmoEarth 模型是基于 transformer 的模型,而 transformer 是当今机器学习中占主导地位的架构之一。为了处理遥感数据,我们首先将其转换为模型可以接收的 token 序列。
影响 transformer 模型效率有两个重要杠杆:模型规模(这也是我们发布一系列模型的原因,让用户可以根据自己的计算预算选择合适的大小)以及 token 序列长度。计算成本与 token 序列长度呈二次方增长,因此即便是小幅缩短,也能显著降低模型运行成本。
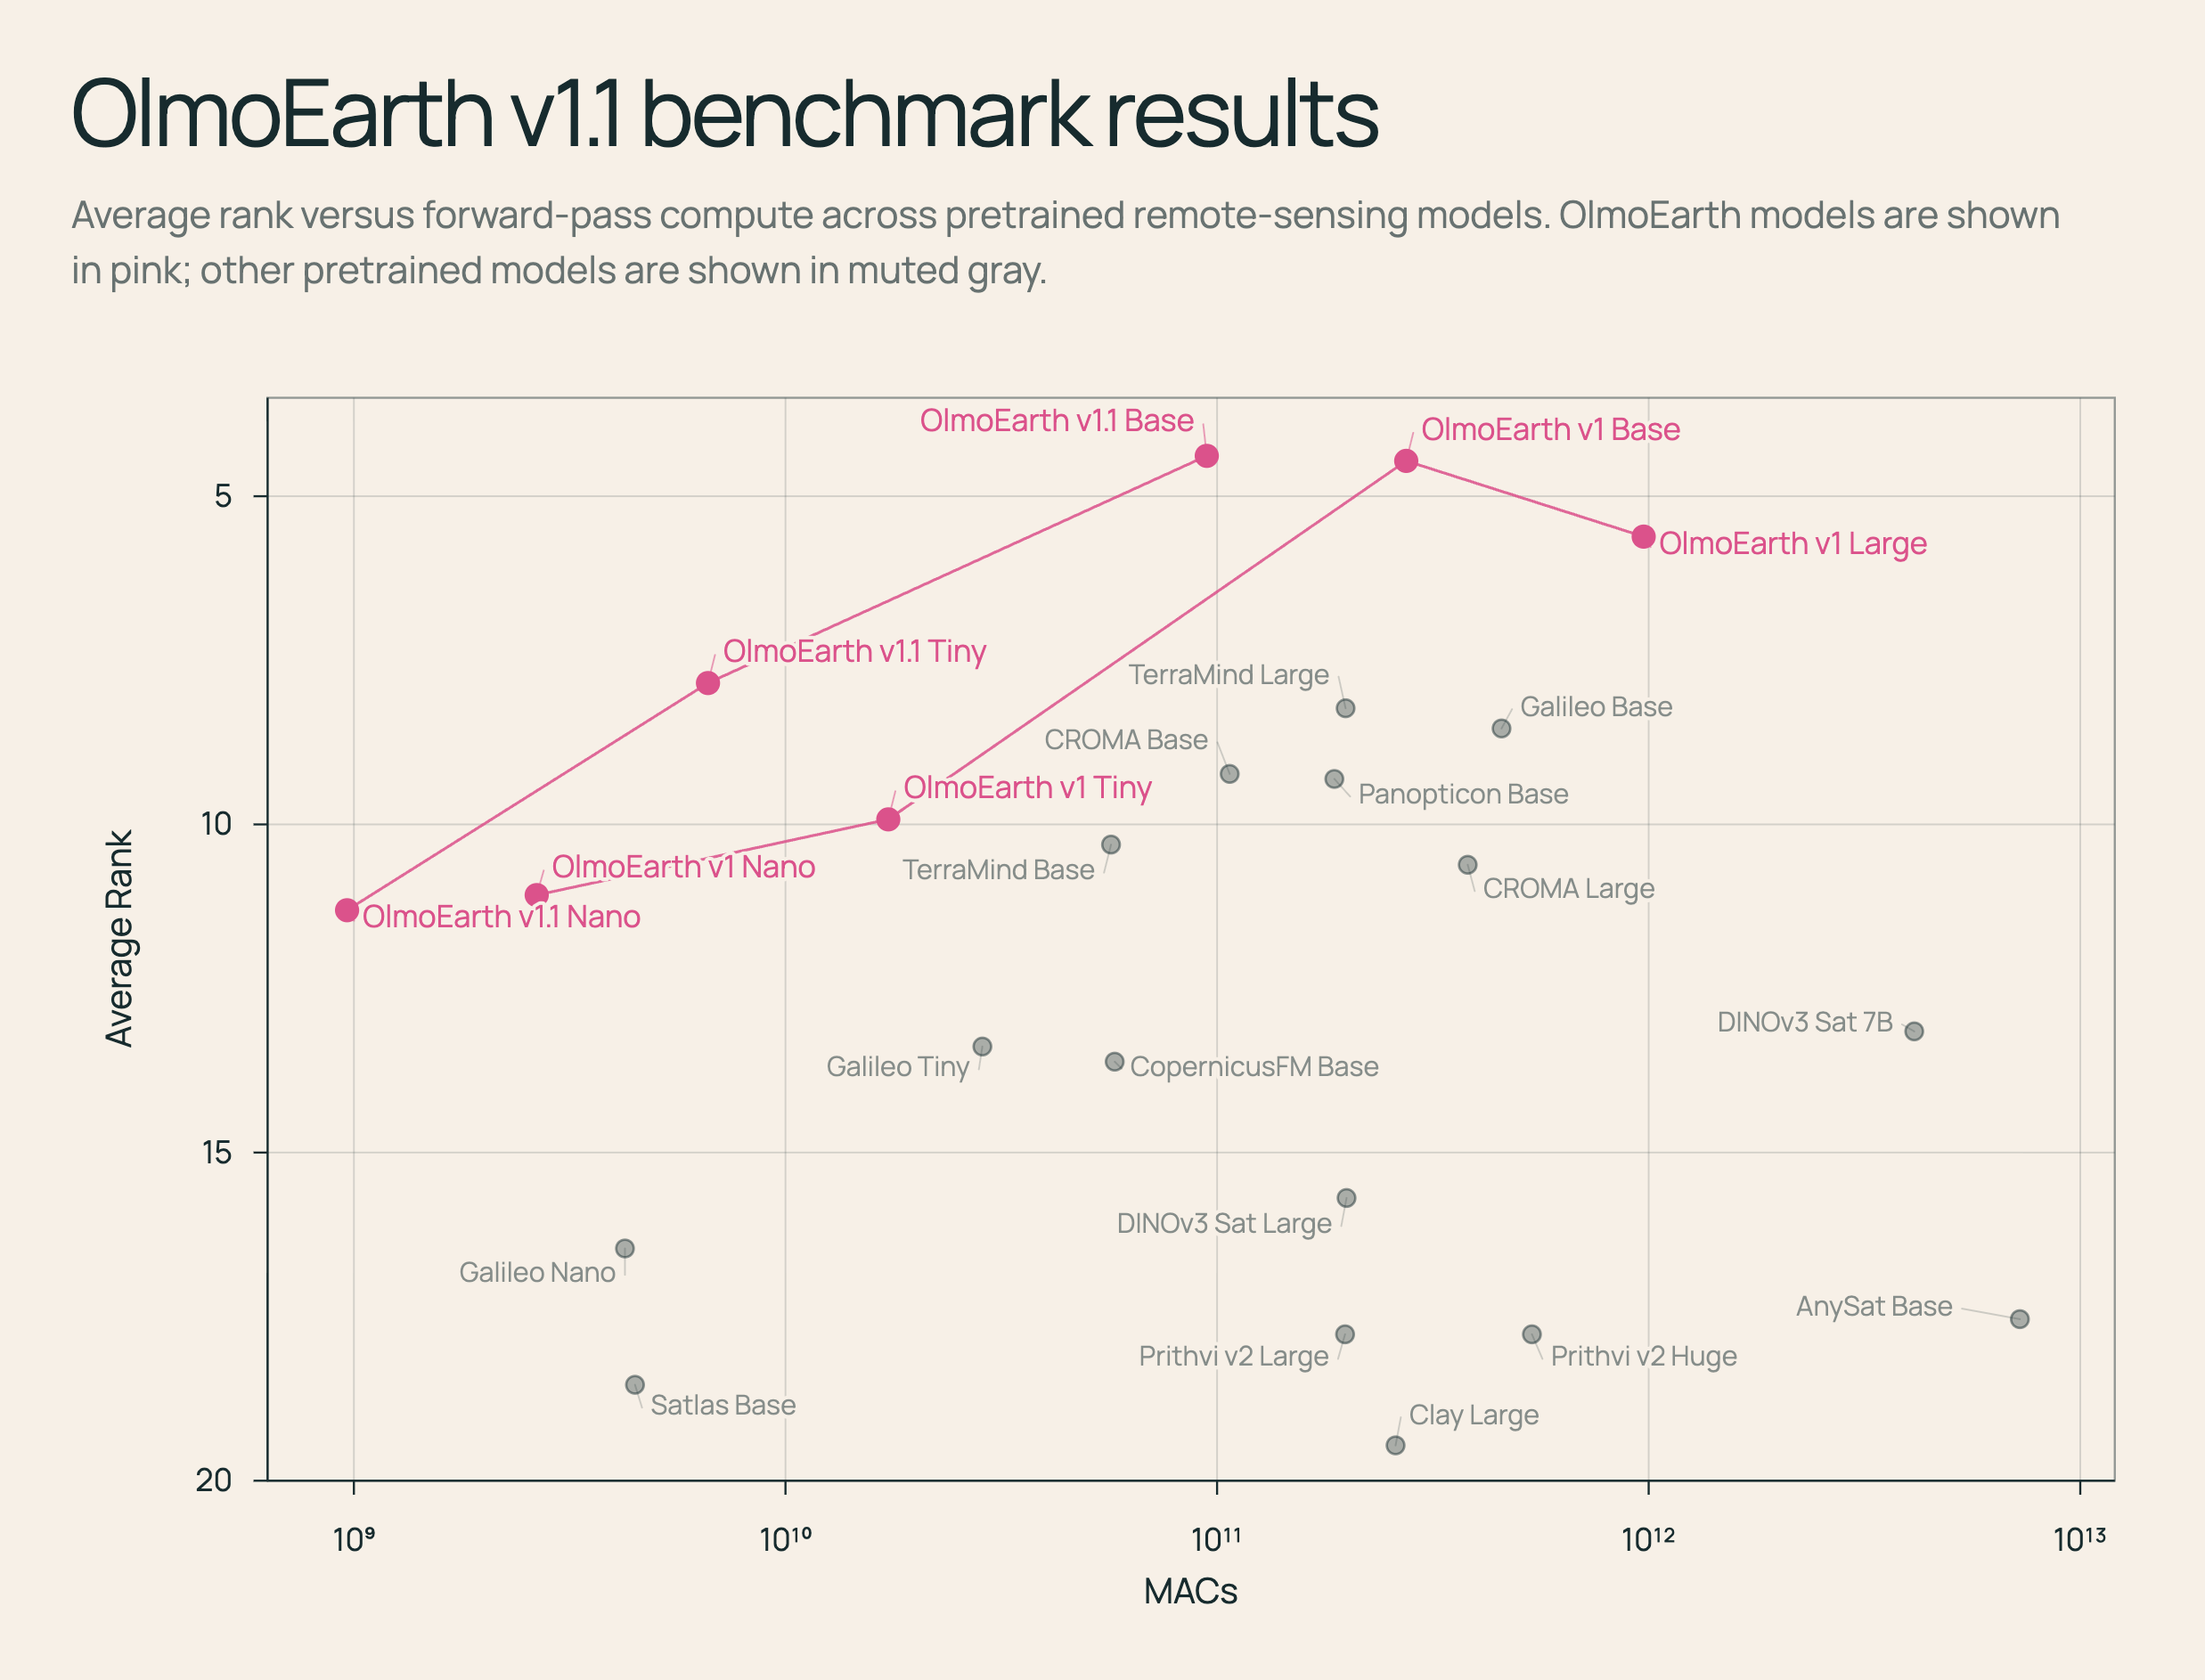
MACs(乘加运算次数)用于估算一次模型前向传播所需的计算量;MACs 越低,通常意味着推理成本更低、速度更快。纵轴是倒置的,因为平均排名越低越好。标签显示的是模型家族和规模。所有绘制点都使用了图中给出的 MAC/排名数值。
设计 token
这引出了一个针对基于 transformer 的遥感模型的重要问题:token 应该代表什么?
以我们常处理的一种常见模态 Sentinel-2 影像为例。一个 Sentinel-2 输入会是一个具有高度和宽度(H、W 分别表示纬度和经度方向像素)、时间维度 T,以及 12 个 Sentinel-2 通道的张量([H, W, T, D=12])。
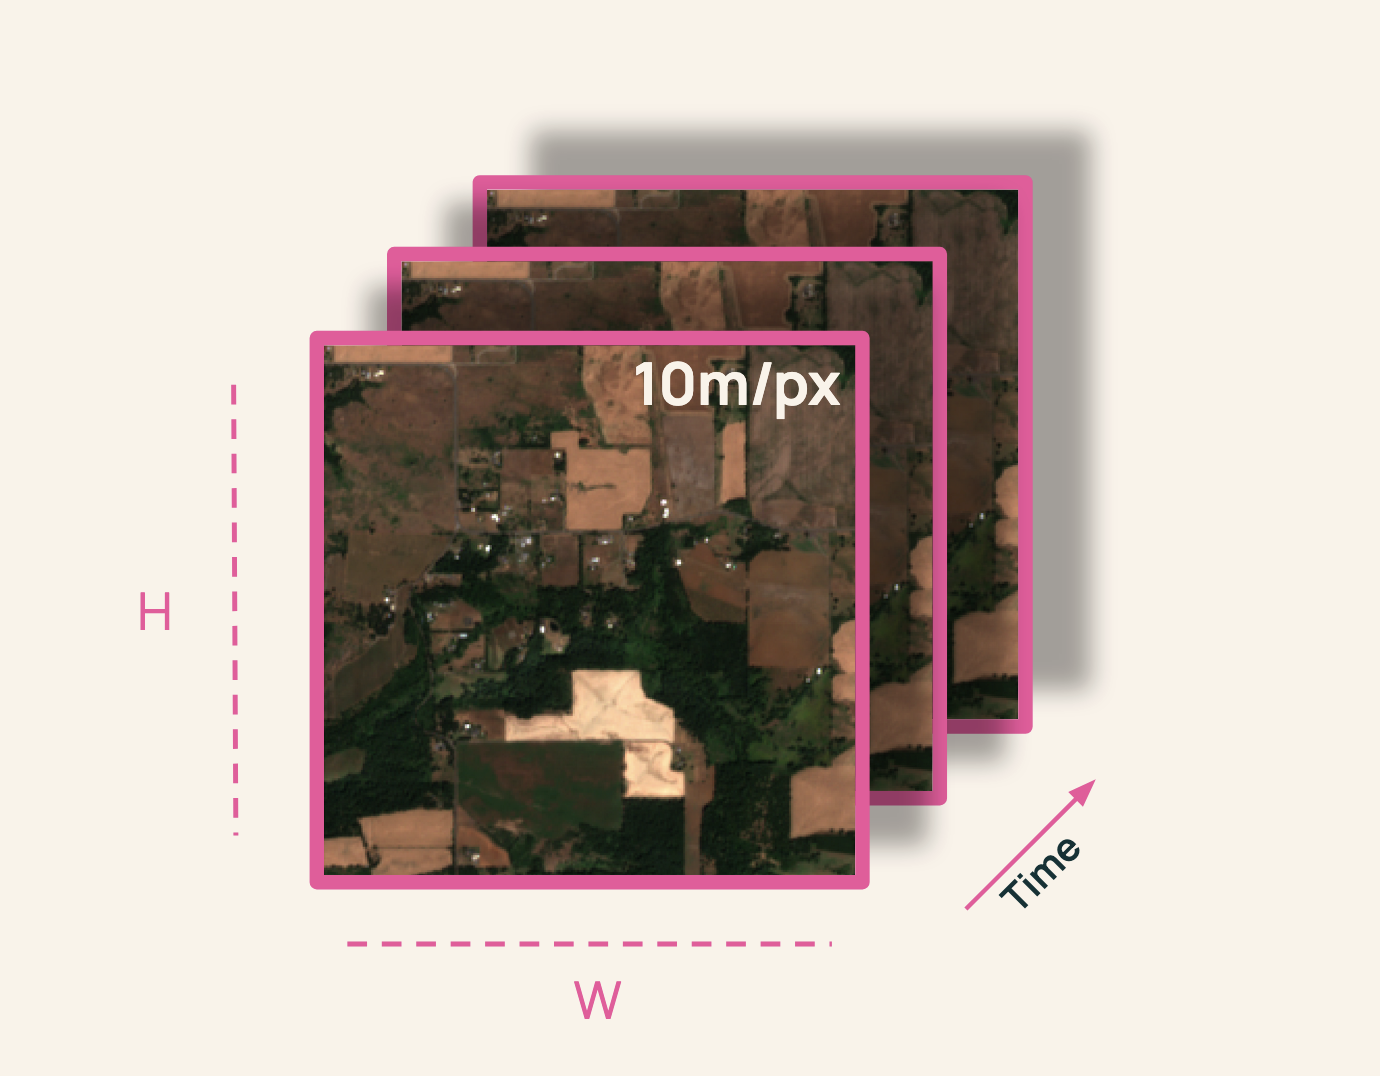
目前,我们将数据切分为 基于分辨率的 patch。具体来说,这意味着我们会选择某个空间 patch 大小 p,然后把整幅 Sentinel-2 图像切分成大小为 p x p 的 patch:
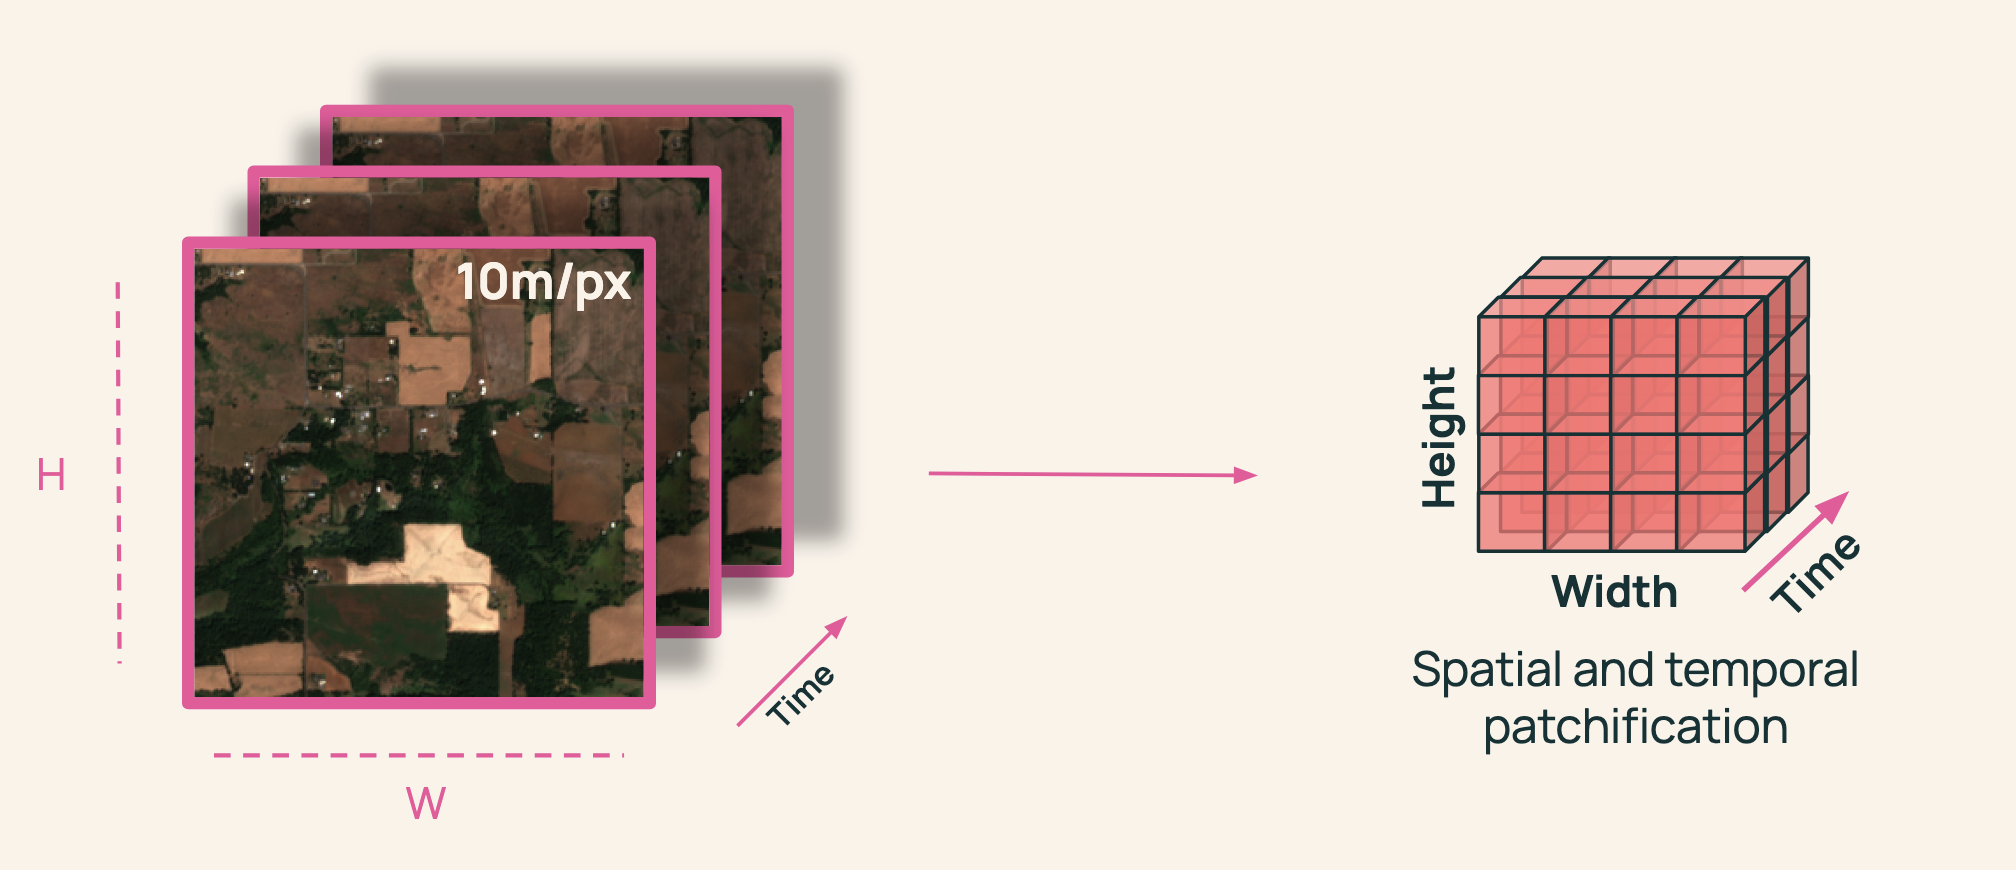
对于每个 patch,我们会在每个时间步、每个分辨率上创建一个 token。因此,一个包含 2 个时间步的 Sentinel-2 输入,每个 patch 会产生 6 个 token(2 个时间步 × 3 个分辨率,10m、20m 和 60m)。
总计而言,一个 [H, W, T, D=12] 的 Sentinel-2 输入将产生 H/p × W/p × T × 3 个 token。
为每个分辨率使用唯一 token 是处理 Sentinel-2 数据时的常见技术——Galileo 和 [SatMAE](https://arx