
跳转到内容
主站 新闻 控制台

过去六个月的大语言模型(LLM)发展,五分钟看懂

· Simon Willison
技巧LLM

我整理了这些带注释的幻灯片,来自我在 PyCon US 2026 上做的五分钟闪电演讲,使用的是我的最新版本的带注释演示工具。

Simon Willison - simonwillison.net

PyCon US 2026 闪电演讲 ” style=“max-width: 100%” />

#

我在 PyCon US 2026 上做了这场闪电演讲,尝试用五分钟概括 LLM 过去六个月的发展。

11 月的拐点
#

六个月是一个相当合适的时间跨度,因为它涵盖了我所说的 2025 年 11 月拐点。11 月是 LLM 领域的关键月份,尤其是在编程方面。
“最佳”模型的宝座在
Anthropic、OpenAI 和 Google 之间易手 5 次
#

首先,那个普遍被认为“最佳”的模型(主要取决于主观感受)在三大提供商之间易手了五次。
生成一只
骑自行车的鹈鹕
#

和往常一样,我用我的“生成一只骑自行车的鹈鹕的 SVG”测试来帮助说明这些模型之间的差异。

为什么要用这个测试?因为鹈鹕很难画,自行车也很难画,鹈鹕不会骑自行车……而且任何 AI 实验室都不太可能专门为这种荒唐任务训练模型。
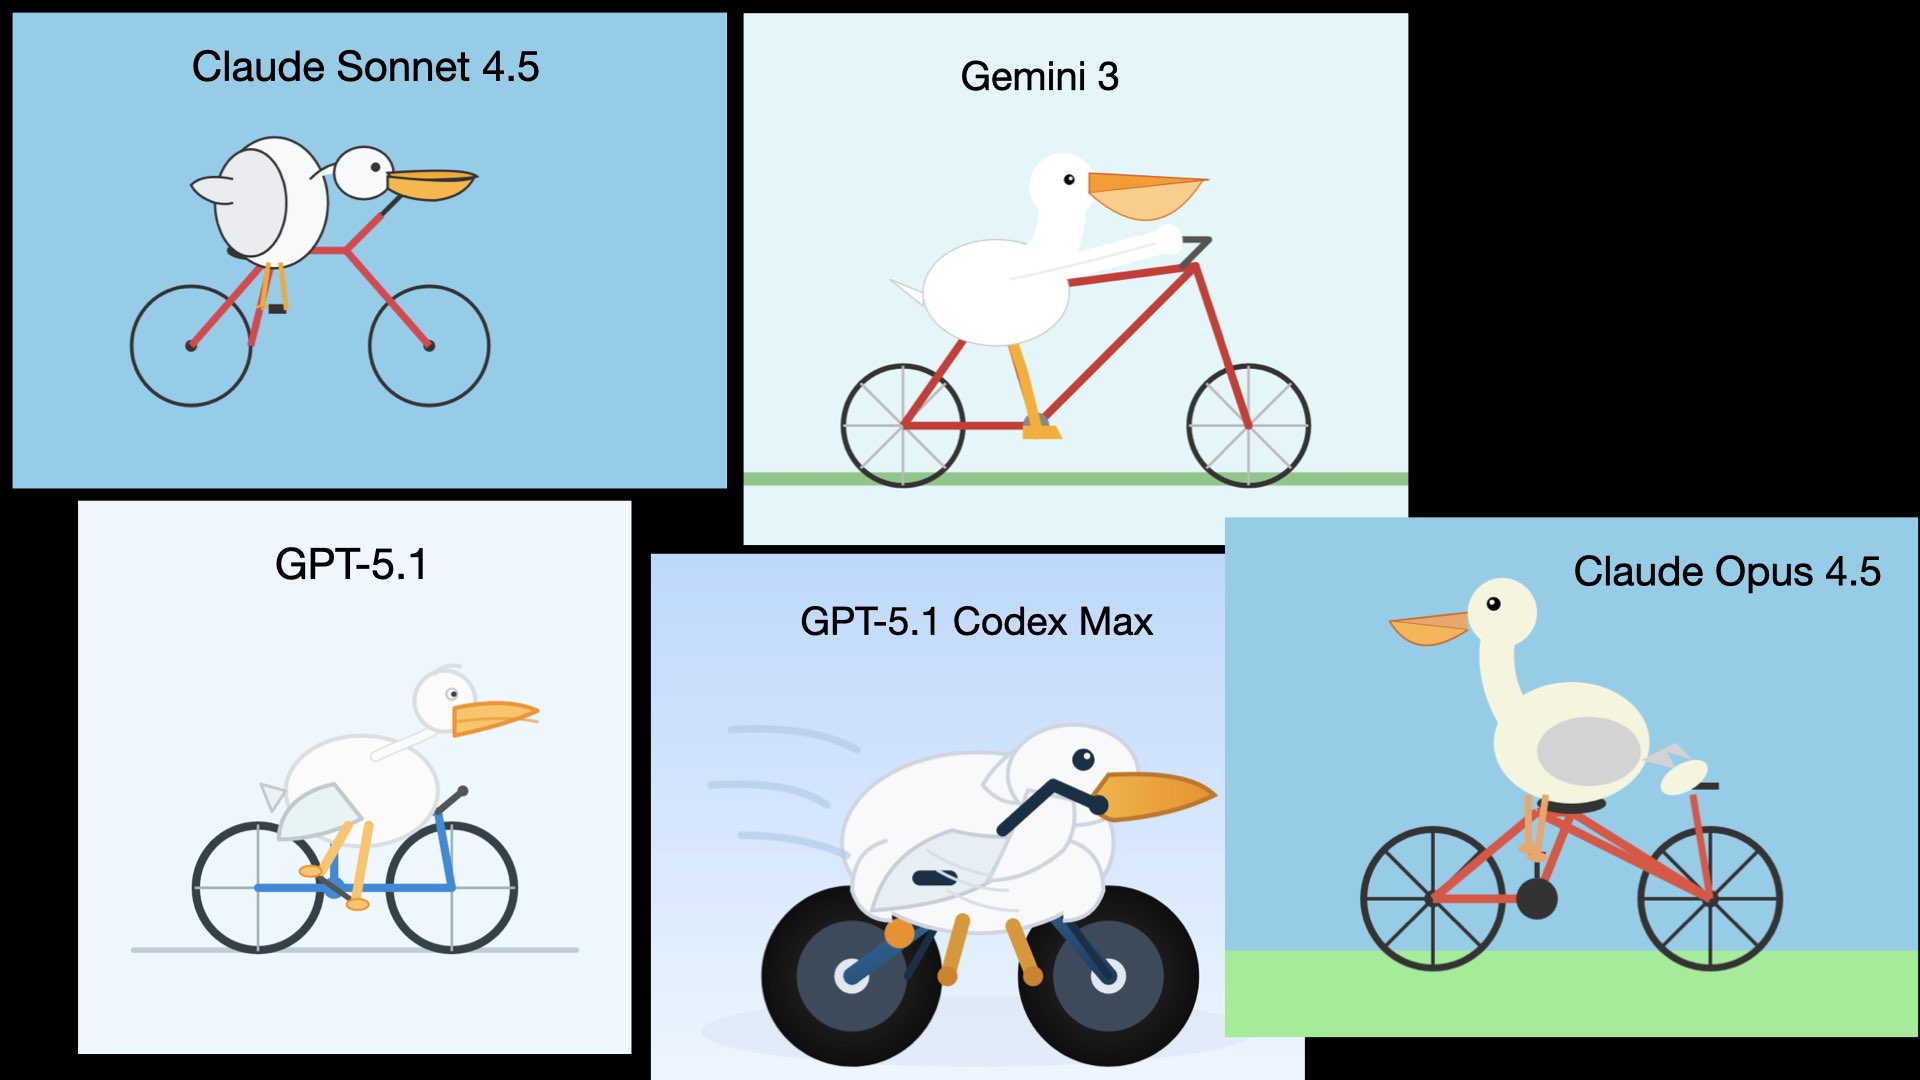
五只鹈鹕,每只对应下面一个模型。质量各不相同!
#

11 月初,广泛公认的“最佳”模型是 Claude Sonnet 4.5,于9 月 29 日发布。它为我画了这只鹈鹕。

到了 11 月,它先后被GPT-5.1、Gemini 3、GPT-5.1 Codex Max超越,随后 Anthropic 又凭借Claude Opus 4.5夺回王座。

我觉得在这几者里,Gemini 3 画出的鹈鹕最好,但鹈鹕并不是一切。大多数从业者都会同意,Opus 4.5 在接下来的几个月里保住了冠军地位。
编程代理变得好用了
#

这件事过了一阵子才变得明显,但 11 月真正的新闻是编程代理变得好用了。

OpenAI 和 Anthropic 在 2025 年大部分时间里一直在进行基于可验证奖励的强化学习,以提高模型编写代码的质量,尤其是在配合它们的 Codex 和 Claude Code 代理框架时。

到了 11 月,这些工作的成果开始显现。编程代理从“经常能用”变成了“基本能用”,跨过了一个质量门槛:你可以把它们当作日常主力工具来完成真正的工作,而不必把大部分时间花在修正它们那些愚蠢的错误上。

这是 MIT 许可证的副本” style=“max-width: 100%” />

#

同样是在 11 月,发生了这件事——一个当时还很冷门的仓库 “Warelay” 的第一条提交,来自一个叫 Pete 的人。

12 月/1 月
(稍微有点 LLM 精神错乱)
#

在假期期间,从 12 月到 1 月,我们很多人都借着休息时间去试用这些新模型和编程代理,看看它们能做什么。

它们能做很多事!我们中的一些人有点过于兴奋了。随着我开始启动一些野心勃勃的项目,想看看自己能把它们推进到什么程度,我也短暂地经历了一种 LLM 精神错乱。

var numbers = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10]; var doubled = numbers.map(n => n * 2); console.log(‘Doubled: ”’, doubled); var evens = numbers.filter(n => n % 2 === 0); console.log(‘Evens: ’, evens); var sum = numbers.reduce((a, b) => a + b, @); console.log(‘Sum:”, sum);

输出 27 Doubled: [2, 4, 6, 8, 10, 12, 14, 16, 18, 20] Evens: [2, 4, 6, 8, 10] Sum: 55 执行时间:8.00ms 关于:micro-javascript 是一个纯 Python 的 JavaScript 解释器,支持可配置的内存和时间限制。此演示…” />