
解锁连续批处理中的异步能力
发布时间:2026 年 5 月 14 日
RL:我们将说明如何分离 CPU 和 GPU 工作负载,从而在推理中获得巨大的性能提升。
这是高效 LLM 推理系列的第二篇文章。第一篇文章介绍了从第一性原理出发的连续批处理(continuous batching)。其中引入了一些我们后续会用到的概念:KV 缓存、FlashAttention、注意力掩码等。
在 Inference Endpoints 上,一台 H200 的费用大约是每小时 5 美元。按小时看不算贵,但如果用上一整天,就已经要花 120 美元了。在这种情况下,你会希望 GPU 被充分利用。
我们已经看到,连续批处理通过调度紧密排列的批次来提升 GPU 利用率,从而避免算力浪费在填充(padding)上。但连续批处理没有解决另一类浪费:默认情况下,它是同步的。这意味着 CPU 和 GPU 轮流工作:GPU 计算时,CPU 等待;CPU 准备下一批时,GPU 等待。在一个每秒运行数百步的循环中,这些空闲间隙会不断累积,正如我们将展示的那样,它们可能占总运行时间的近四分之一。为了确保 GPU 100% 时间都在忙于计算,我们需要消除这些间隙。
为此,我们可以使用异步批处理:我们将 CPU 的批次准备与 GPU 的批次计算解耦,让两者能够并行运行,并始终保持 GPU 高效工作 🔥
同步批处理
下面是朴素的同步批处理工作方式:
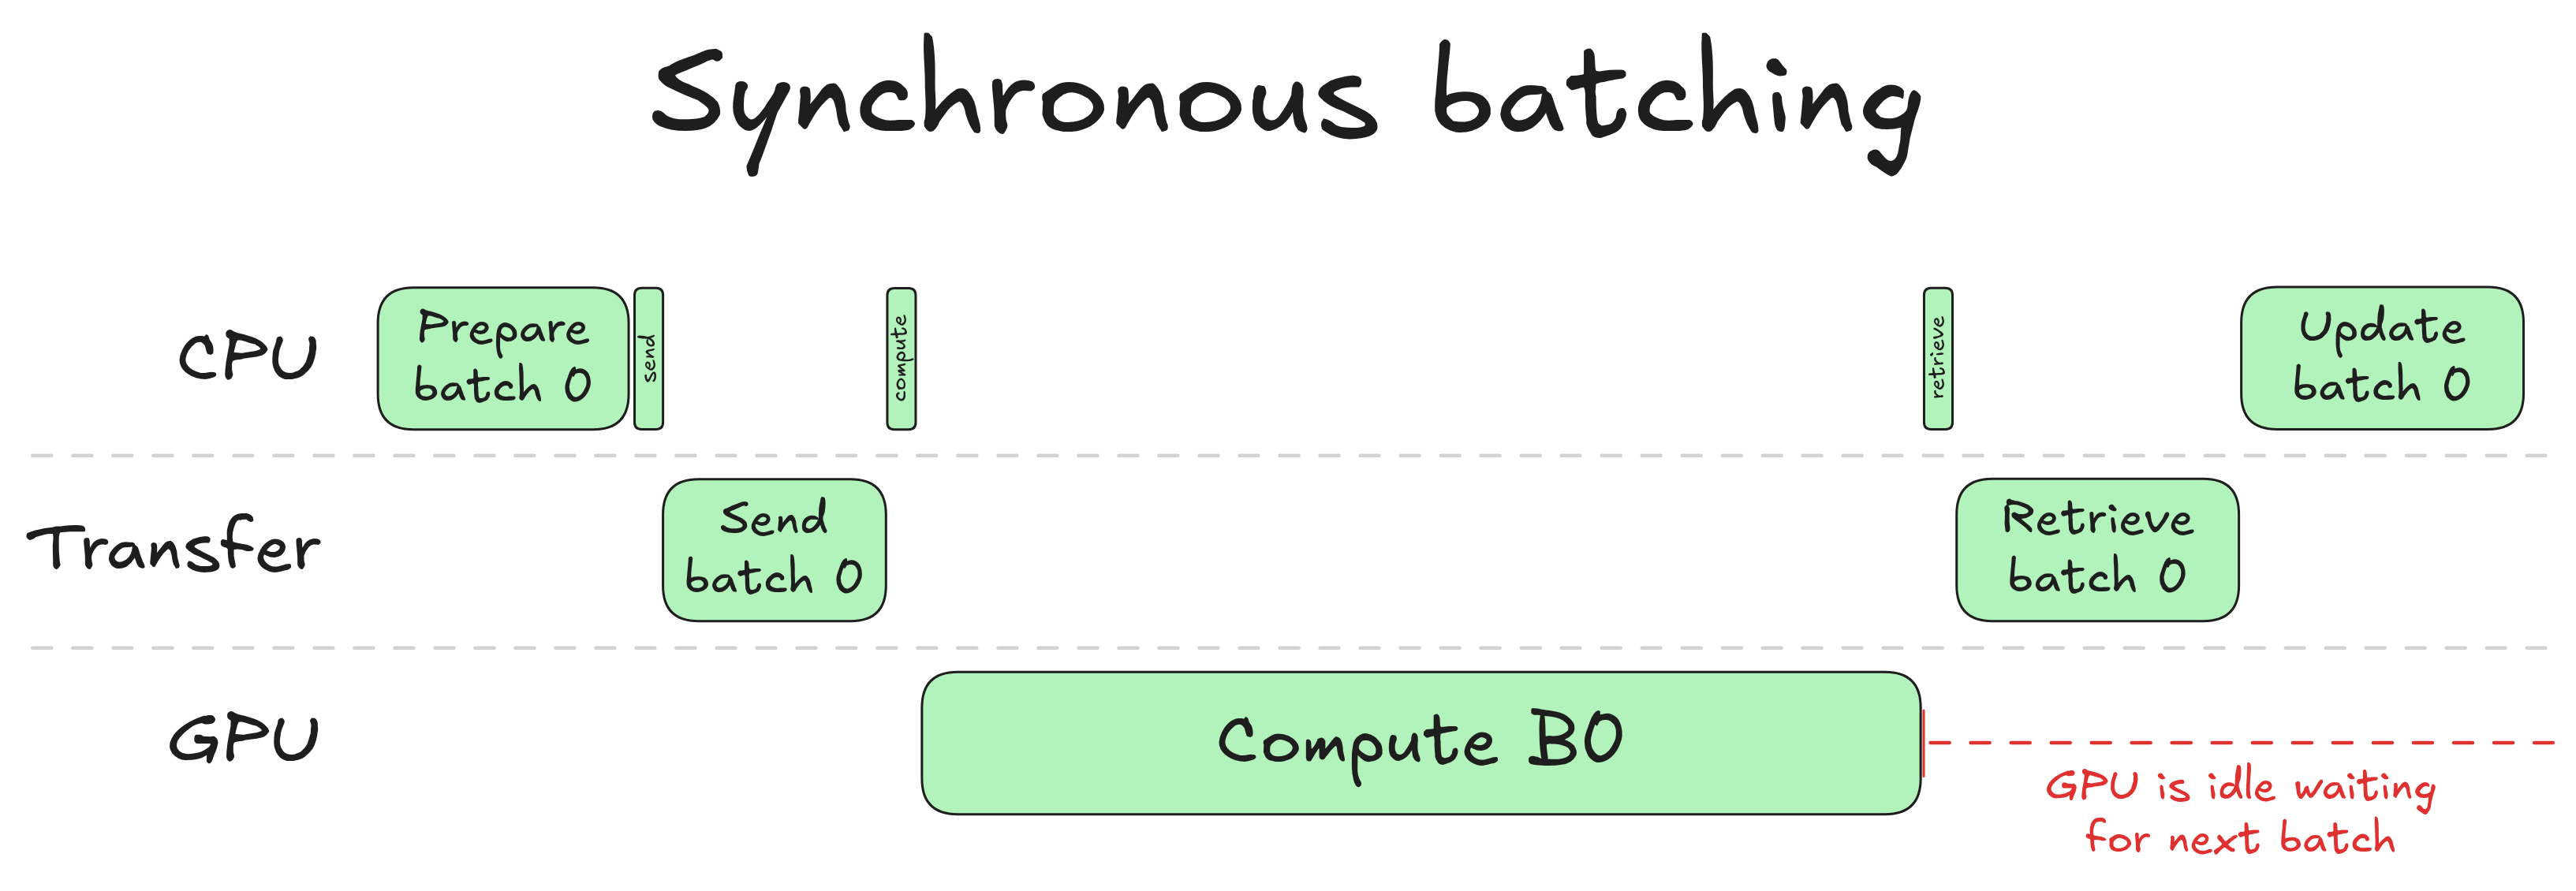
当 CPU 准备一个新批次时,它会选择要包含哪些请求,更新 KV 缓存表,驱逐在上一轮中已完成的请求,并接纳新的请求以填补释放出来的空间。完成这些后,它会把准备好的输入传输到 GPU。GPU 执行前向传播,并为每个请求采样(即选择)一个新 token。结果会返回给 CPU,这样 CPU 就知道每个请求刚刚生成了哪个 token,然后整个循环再次重复。
请注意右侧的红色标注:GPU 完成计算后就会进入空闲状态。下一批次必须等到 CPU 完成其更新步骤之后才能开始:采样输出 token、更新请求状态、重新调度批次。
这就是同步批处理的核心低效之处:CPU 和 GPU 轮流工作。GPU 计算时,CPU 空闲;CPU 更新时,GPU 空闲。任何时候它们都无法同时做有用的工作。对于一次单独的前向传播,这看起来可能只是小小的代价,但在每秒运行数百步的连续批处理循环中,这些空闲间隙会累积成真实的吞吐量损失。
为了展示这一点,我们对使用 8B 模型、batch size 为 32、生成 8K token 时 CPU 和 GPU 上花费的时间进行了分析: