
AWS 上用于基础模型训练与推理的构建模块
企业文章 发布于 2026 年 5 月 11 日
对于基础模型来说,长期以来,“扩展规模”(scaling)基本上只意味着一件事:在预训练上投入更多算力,能力就会提升。这一判断得到了经验研究的支持,例如 Kaplan 等人(2020),该研究报告称,随着 模型参数、数据集规模 和 训练算力 的扩展,损失函数会呈现可预测的幂律趋势。实际上,这些趋势为持续投资大规模加速器算力及其所需的分布式基础设施提供了依据,以确保其能够被高效利用。但前沿已在演进——扩展规模不再只有一条曲线。NVIDIA 提出的“从一条到三条扩展定律”这一表述很好地强调了:除预训练之外,性能还越来越多地通过 后训练(例如监督微调(SFT)和基于强化学习(RL)的方法)以及 测试时算力(“长思考”、搜索/验证、多样本策略)来扩展。
图 1: 改编自 NVIDIA 博客文章 “AI 的三条扩展定律,详解”。
综合来看,这些扩展范式正在推动基础模型生命周期——预训练、后训练和推理——朝着趋同的基础设施需求发展:紧密耦合的加速器计算、高带宽低延迟网络,以及分布式存储后端。它们也提高了资源管理编排的重要性,并强调了应用层和硬件层可观测性对于维护集群健康、以及在大规模场景下诊断性能异常的关键作用。
另一个关键趋势是,基础模型生命周期越来越依赖一个开源软件(OSS)生态系统,该生态系统涵盖模型开发框架、集群资源管理和运维工具。在集群层面,资源管理通常由 Slurm 和 Kubernetes 等系统提供。模型开发和分布式训练通常使用 PyTorch 和 JAX 等框架实现。监控与可视化——也就是可观测性——通常通过 Prometheus 进行指标采集,并使用 Grafana 进行可视化和告警,它们作为基础设施和资源管理之上的运维层存在。图 1 展示了这种分层架构,说明了硬件基础设施如何支撑资源编排,资源编排又如何赋能 ML 框架,而可观测性则贯穿所有层级。
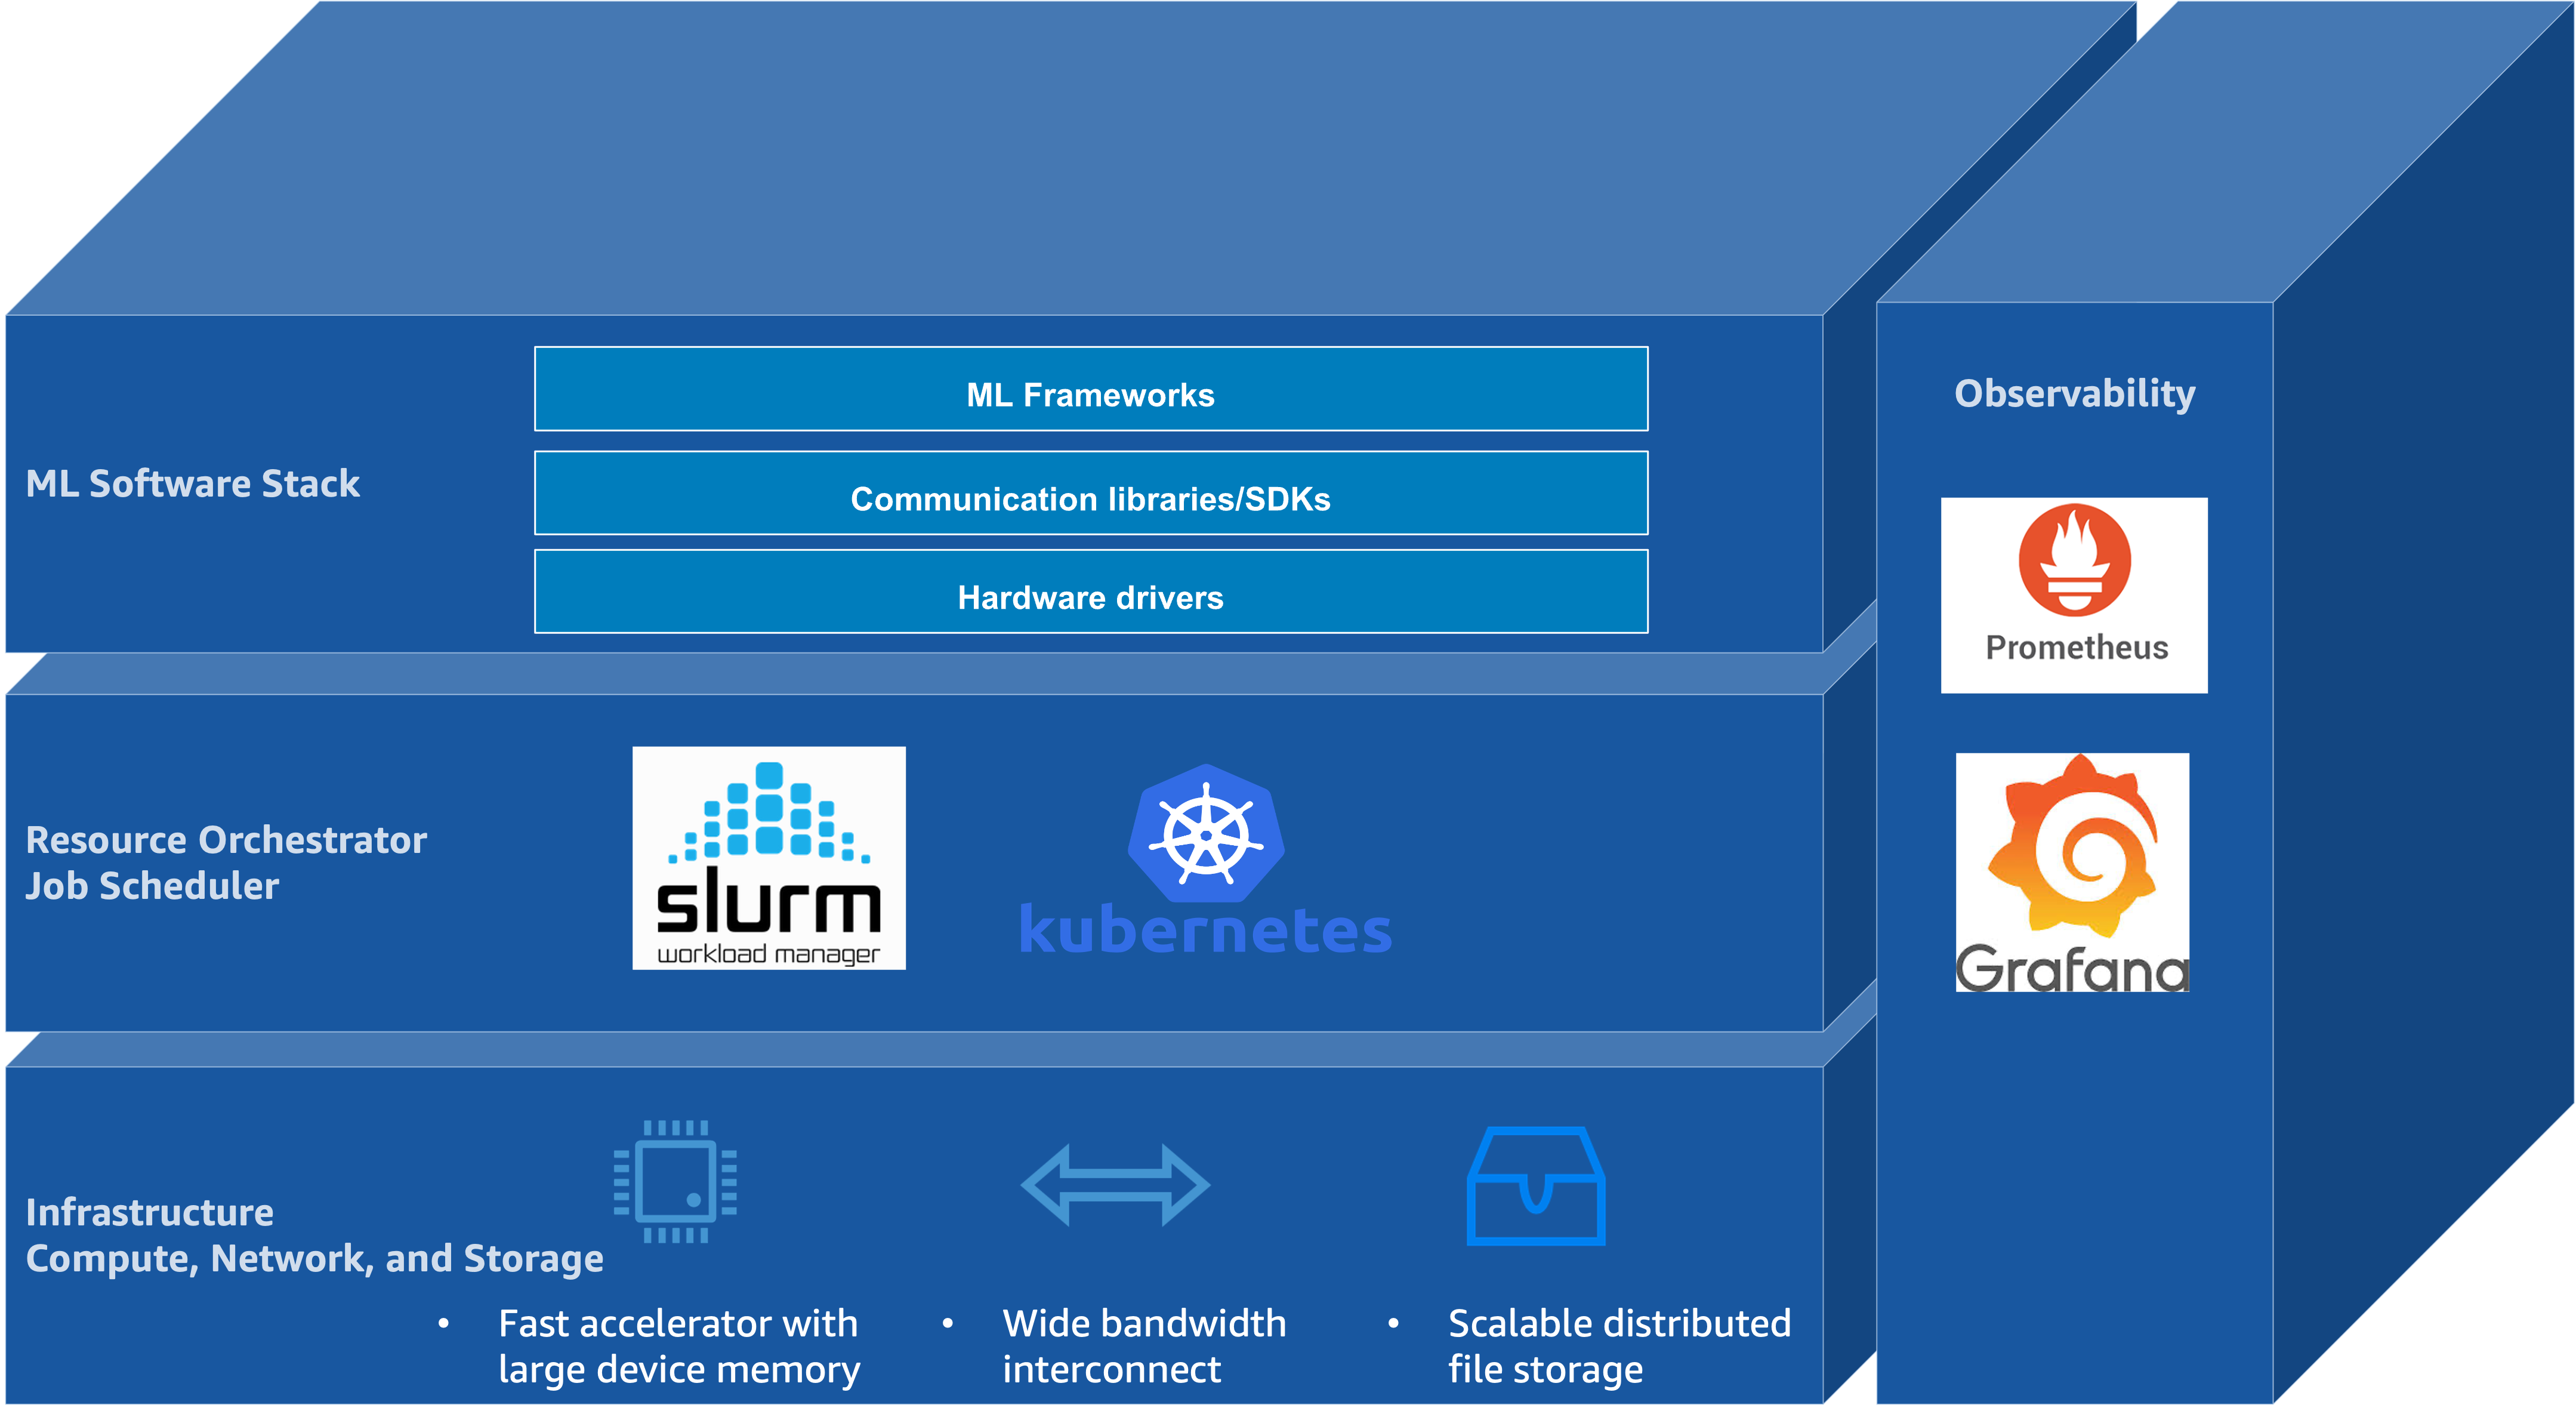
图 1:用于基础模型训练与推理的开源软件栈的分层架构
这篇文章面向参与基础模型训练与推理的机器学习工程师和研究人员,重点关注……