
vLLM V0 到 V1:在 RL 中先保证正确性,再做修正
2026 年 5 月 6 日发布
Rafael Pardinas rafapi-snow 关注
PipelineRL 使用 vLLM 作为 rollout 生成的推理引擎。推理引擎采样 token 并返回 token 的 logprob;训练器使用这些 logprob 来计算 policy ratio、KL、clip rate、entropy 和 reward。logprob 的计算方式只要有任何差异,都会改变训练动态。这就是我们在 vLLM V0 到 V1 迁移过程中必须消除的训练—推理不一致问题。
TL;DR。 在修复了四件事之后,vLLM V1 与我们的 vLLM V0 参考实现对齐:处理后的 rollout logprob、V1 特有的运行时默认值、在线权重更新路径,以及用于最终投影的 fp32 lm_head。我们是在修改 RL 目标之前先修复后端行为。
参考运行使用的是 vLLM 0.8.5;V1 运行使用的是 vLLM 0.18.1。图 1 展示了最终结果。红色曲线是最初的 V1 尝试,绿色曲线是下文所述修复后的最终 V1 运行。
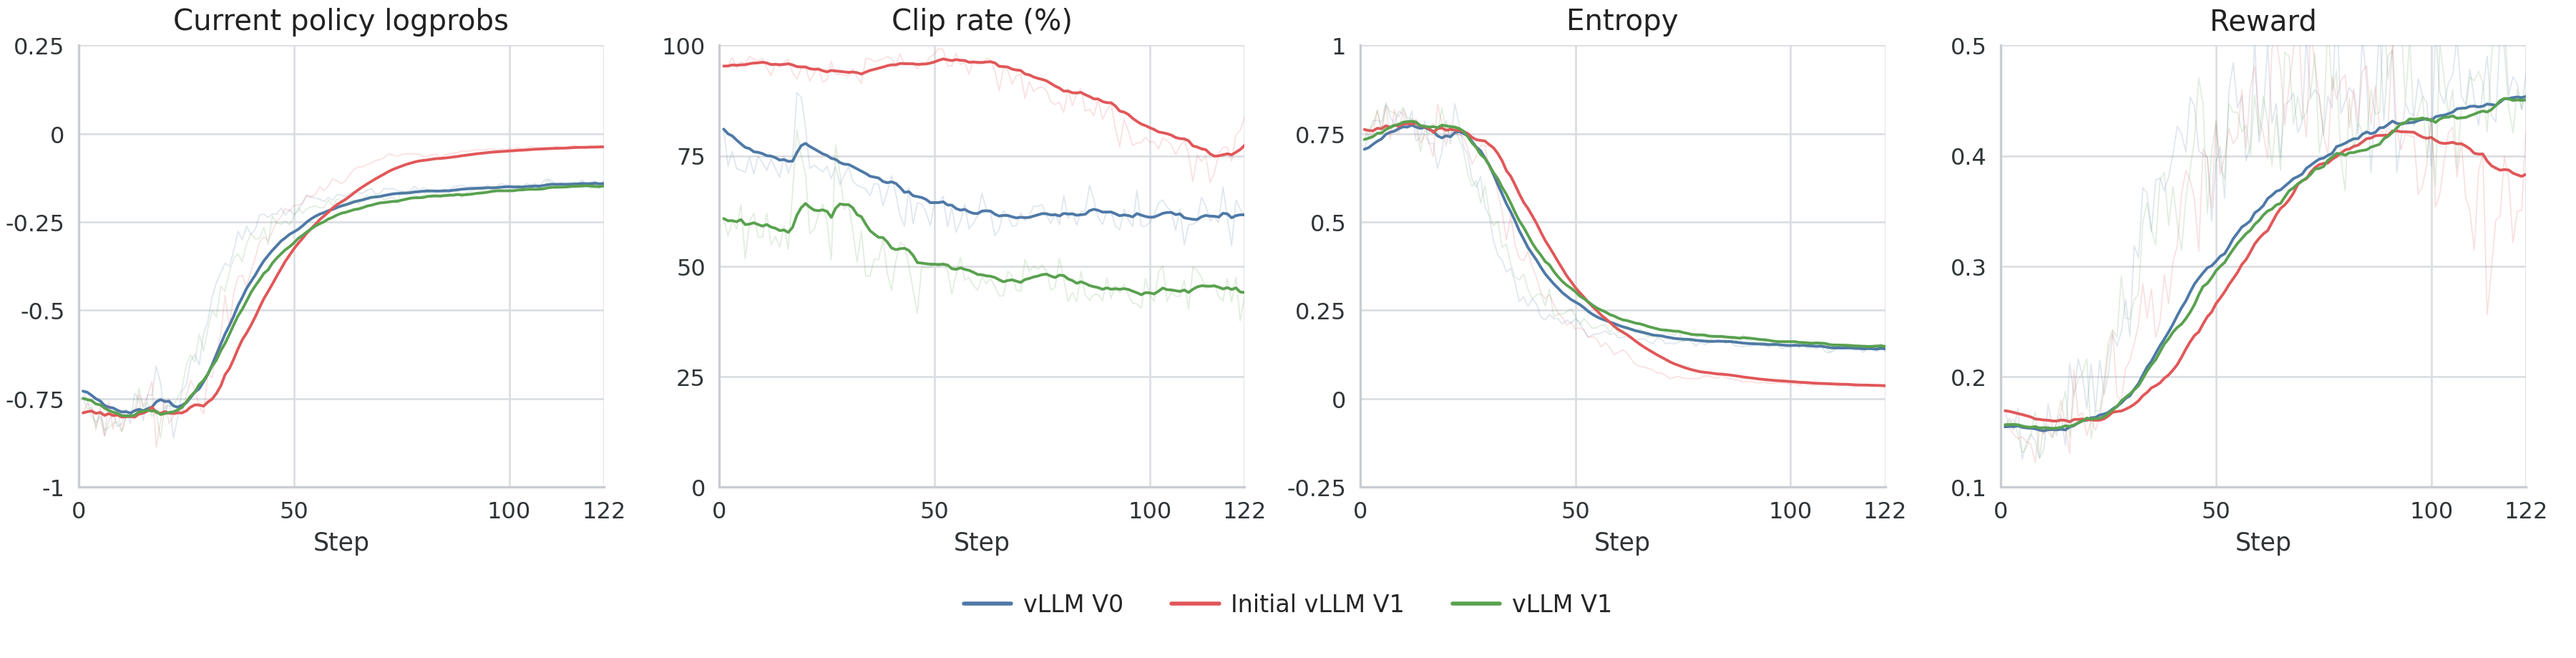
图 1. vLLM V0 参考版本(蓝色)、最初的 vLLM V1 尝试(红色),以及修复后最终的 vLLM V1 运行(绿色)的训练器侧指标,包括 fp32 lm_head。最终的 V1 运行在 clip rate、KL、entropy 和 reward 上都接近 V0 的轨迹。
迁移目标
vLLM V1 是对 V0 引擎的一次大规模重写。因此,我们的迁移目标有意设得很窄:
- 验证 V1 返回的 rollout logprob 是否符合训练器预期的格式
- 用相同工作负载重新运行,与 V0 参考结果对比
- 只有在恢复后端一致性之后,才评估目标层面的变化
最先出现的可见症状包括:
clamp_log_ratio_new_old_indicatorkl_new_oldentropyreward
这些指标来自一次 GSPO 训练运行,而该目标正是本实验所使用的目标。类似的不一致也可能出现在 PPO、GRPO,或任何把 rollout 侧 logprob 视为优化目标一部分的在线 RL 系统中。
最初的 V1 运行清楚地暴露了问题。训练器侧的 logprob 和 reward 在训练早期就偏离了 V0 参考结果。
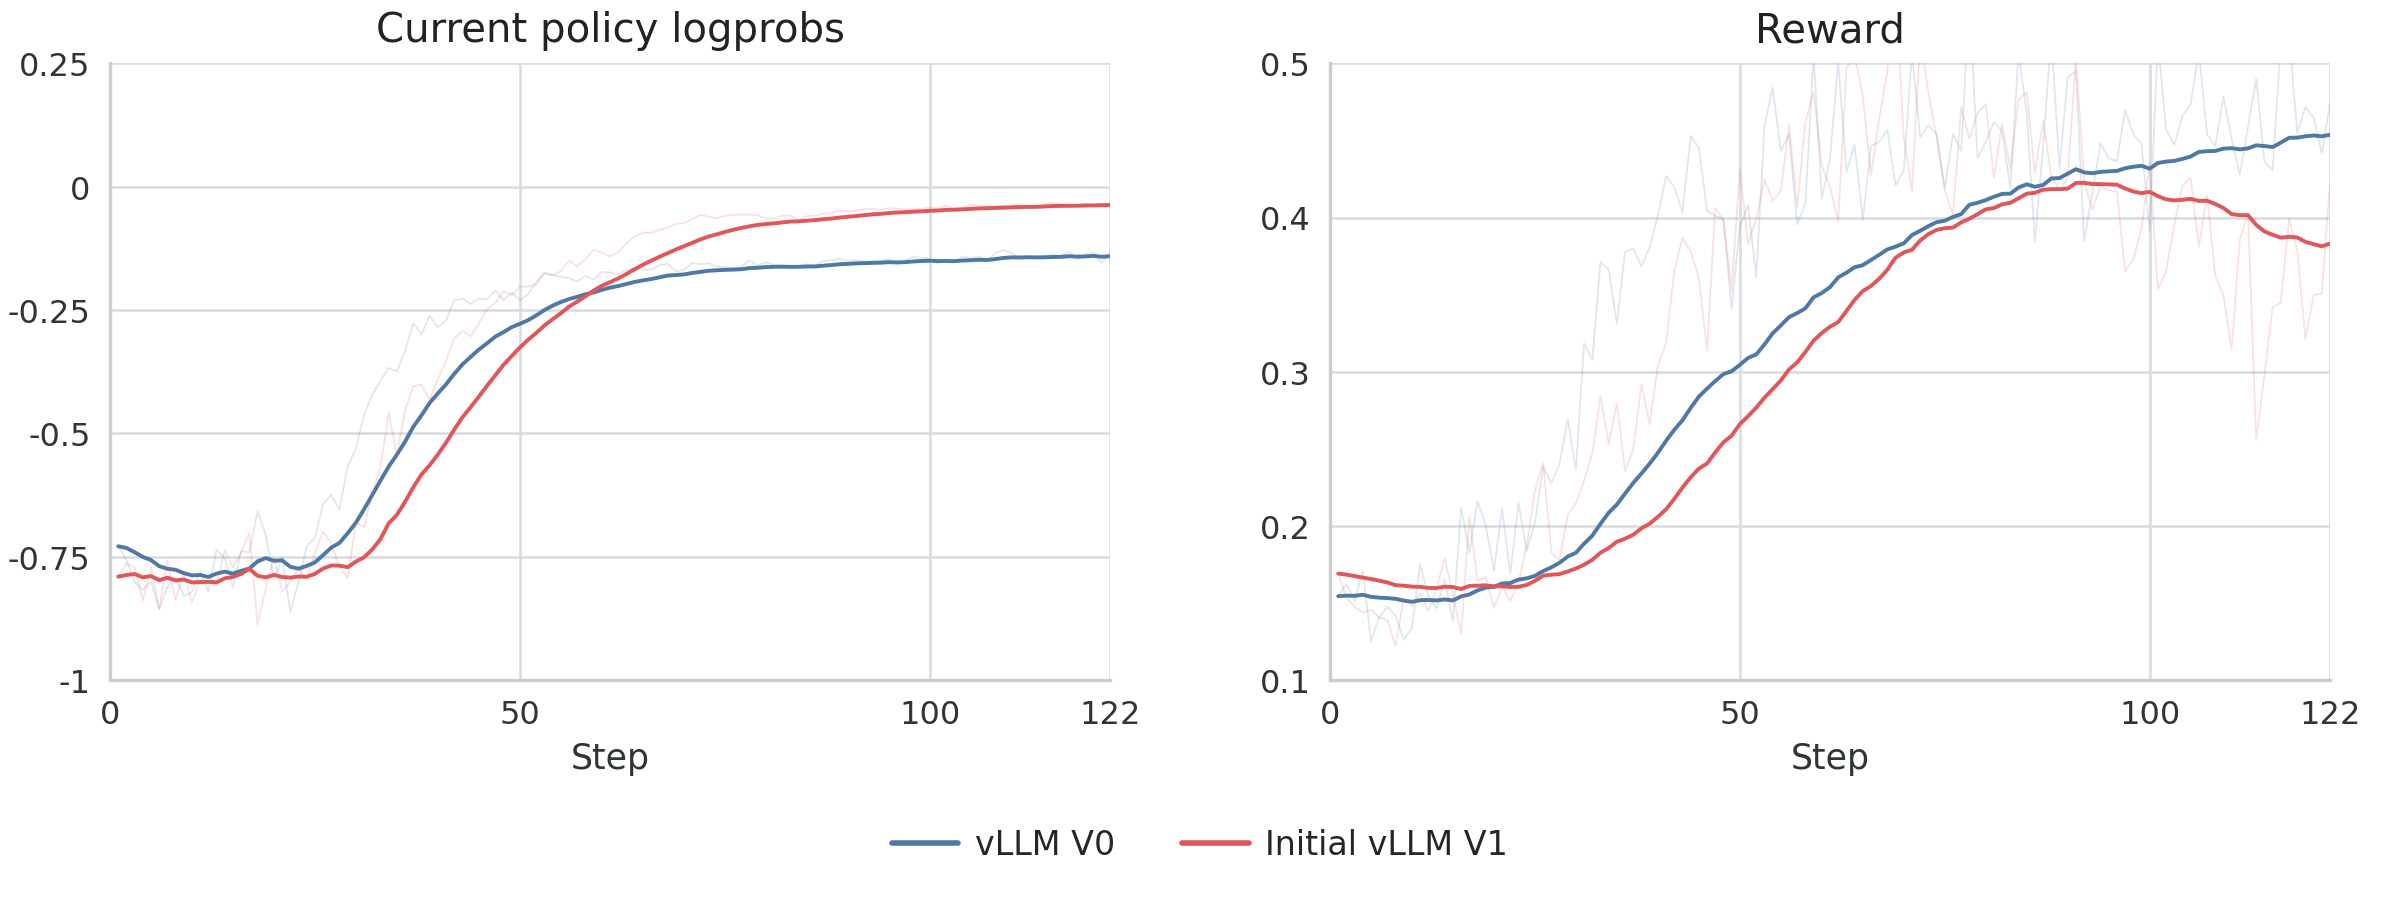
图 2. 训练器在更新过程中计算的当前策略 logprob(左)和 reward(右)。最初的 vLLM V1 运行(红色)与 vLLM V0 参考(蓝色)逐渐分离。
在训练器指标中也能看到同样的模式。clip rate 是最初对比中最容易读取的信号。
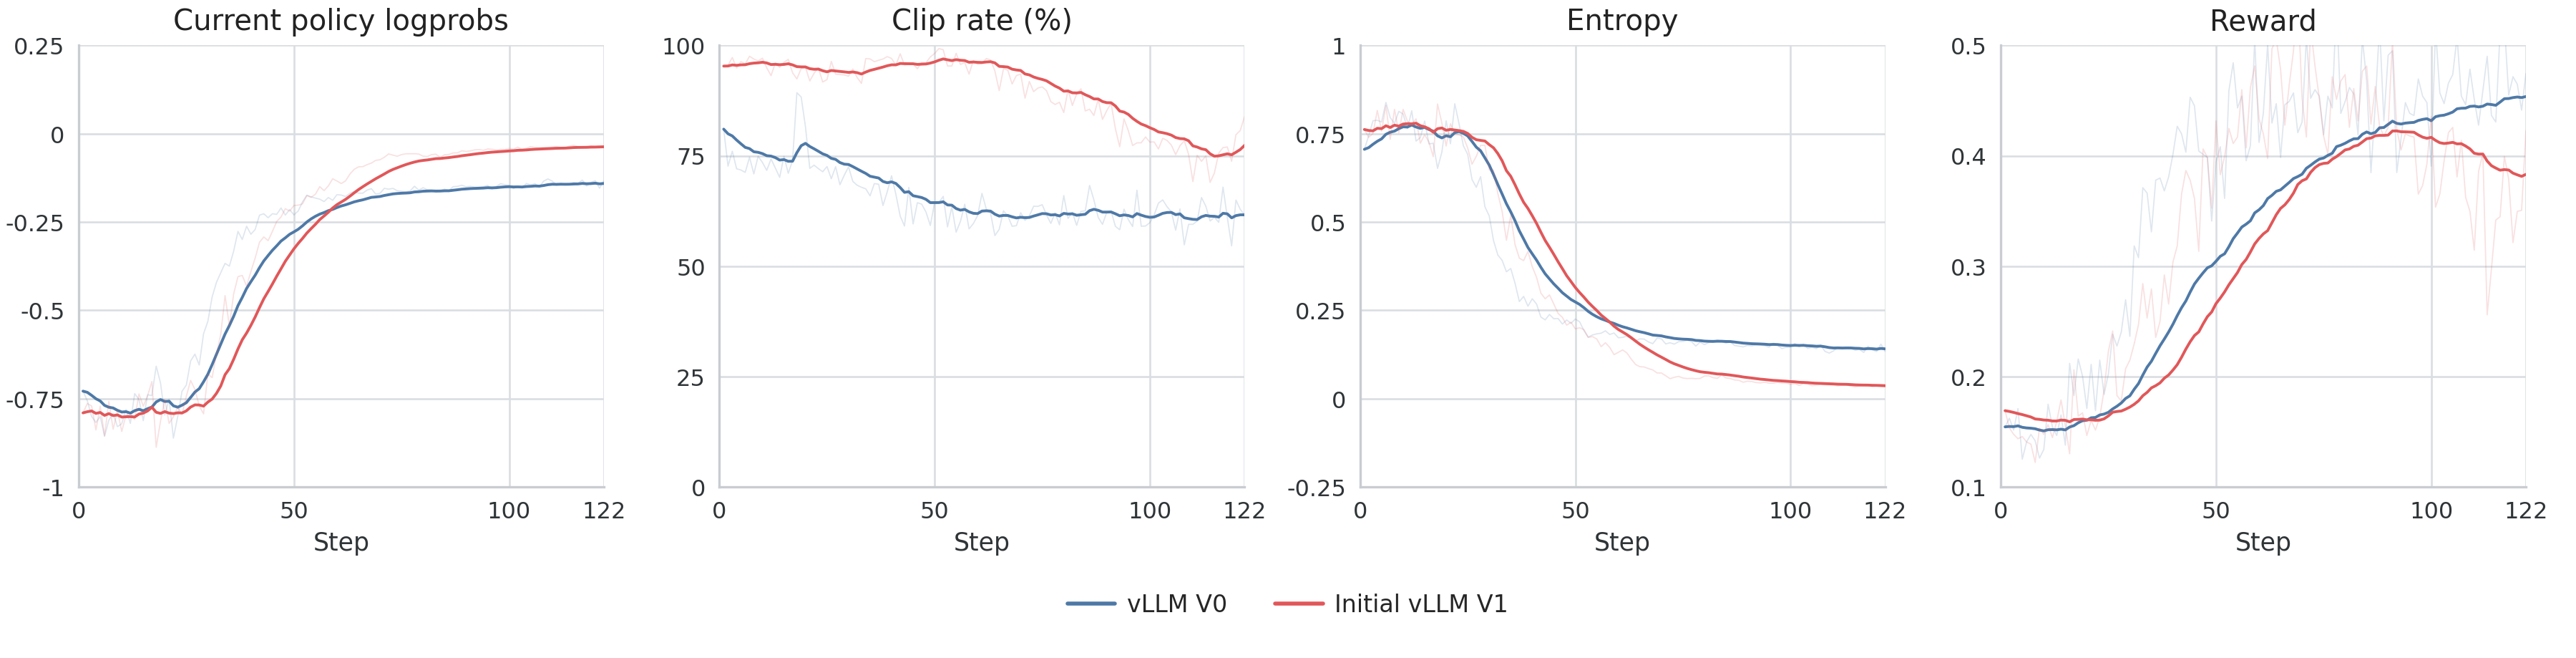
图 3. vLLM V0 参考版本(蓝色)与最初的 vLLM V1 尝试(红色)的训练器侧指标。clip rate 反映 rollout/训练器策略之间的差距;entropy 和 reward 展示了这种差距如何传播到训练中。
失败模式
我们将可能的原因分成三层:
- 语义不匹配:后端返回的 logprob 相对于训练器预期具有不同含义。
- 推理路径不匹配:后端在缓存、调度或请求处理方面使用了不同的运行时默认值,导致相同的 prompt 走上了不同的执行路径。
- 目标不匹配:RL 目标本身需要针对