
作者:Stephan Rabanser、Sayash Kapoor、Arvind Narayanan
假设你听说有一个新的 AI 智能体,号称能通过代你购物、写代码、发送邮件,或接待客户来提升生产力。你应该信任它吗?这个智能体真的能可靠地完成工作吗?毕竟,智能体出错的案例比比皆是。
令人惊讶的是,尽管 AI 智能体缺乏可靠性这一点众所周知,但目前 AI 行业既没有很好的工具来衡量可靠性,甚至连“可靠性”的良好定义都没有。
Arvind 和 Sayash 长期以来一直在思考这个问题。去年秋天,普林斯顿大学博士后研究员 Stephan Rabanser 加入了我们;他的博士研究聚焦于更简单、更传统的 AI 系统中的可靠性问题。我们招募了另外几位独立研究人员,并发布了我们希望是一项全面的可靠性测量研究。我们的论文草稿名为 Towards a Science of AI Agent Reliability。
我们借鉴了核安全和航空安全等多个领域的经验。我们将可靠性分解为 12 个不同维度。在两个互补基准上评估 14 个模型后,我们发现,近两年来能力的快速提升,只带来了适度的可靠性改进。交互式仪表盘见这里。
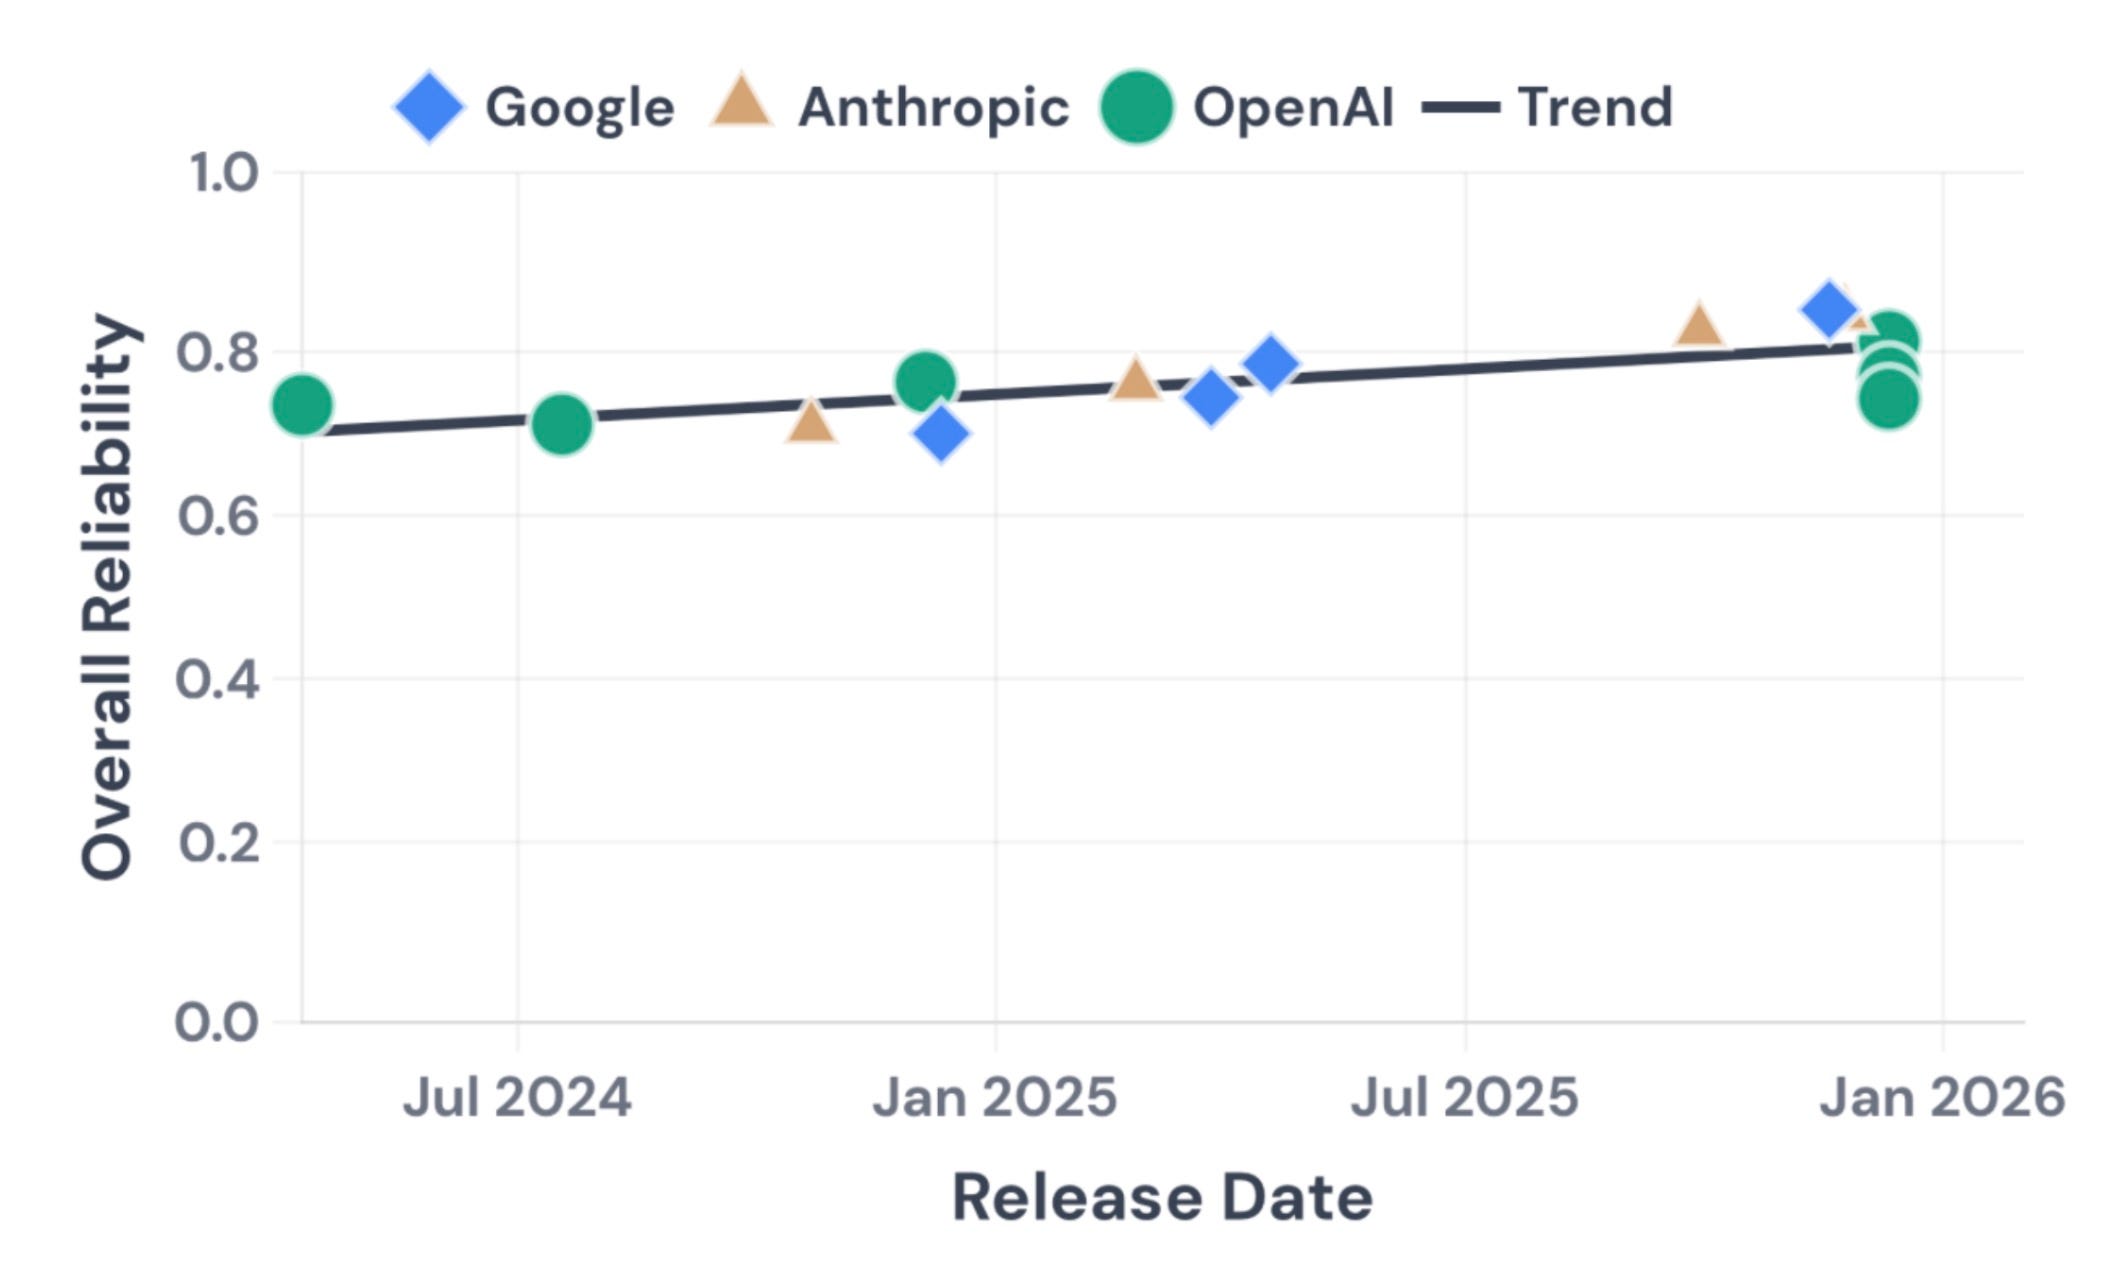
尽管我们目前的发现还只是初步结果,但我们希望它们能够解释行业内许多人心中的困惑:为什么 AI 智能体的经济影响推进得如此缓慢,尽管它们在能力基准上表现得极为出色。1 为了帮助社区系统性地跟踪可靠性,我们计划推出一个 AI 智能体“可靠性指数”。我们希望这能促使研究人员和业界投入更多精力来提升可靠性。